 匯東華統計顧問有限公司
一頁先懂|操作與判讀
操作路徑:分析(A) → 敘述統計(E) → 預檢資料(E)... → 把要檢定的連續變數放進「應變數清單(D)」 → 按右側「圖形(T)...」 → 勾選「常態圖(含檢定)(O)」 → 「繼續(C)」 → 「確定」。
要依組別分開檢定:把分組變數放進「因數清單(F)」,其餘步驟完全一樣。
輸出要看哪一張:標題為 Tests of Normality(常態檢定)的輸出表格。Shapiro-Wilk 與帶 Lilliefors 校正的 Kolmogorov-Smirnov 會同時出現在同一張表。
怎麼看:看 Sig. 欄,亦即 p 值。p 大於 0.05,表示沒有足夠證據說本筆資料偏離常態。
該表星號為何意:SPSS 印出 .200*,表格下方腳註為「這是真實顯著性的下界」,意思是 p 比 .200 更大,不是 p 剛好等於 .200。
本文用一份 200 人的模擬資料,將兩種做法從選單一路走到輸出判讀。
01|動手之前,先確認你要檢定的是哪一欄數字
一句話原則:檢定的對象,跟你接下來要做的分析目標一致。
如果接下來要比較男女兩組的平均數,你關心的是「各組內部」的分布,就依組別分開檢定;若是描述整份資料的分布樣態,看整體結果即可。SPSS 將此兩種做法放在同一個對話框,差別只在【因數清單】欄位有無變數。本文兩種均進行示範。
資料來源:本文示範使用一份 200 位護理人員工作負荷之模擬資料。欄位包括編號(ID)、服務單位(Unit)、性別(Sex,0 男、1 女)、年資(Tenure)、疲勞量表總分(Fatigue)。
目的:檢定之Y為連續變數 Fatigue(疲勞量表總分),分組變數為 Sex(性別)。
02|操作路徑(不分組,全體 200 人一起檢定)
步驟 1|打開「預檢資料」
從功能表依序點:分析(A) → 敘述統計(E) → 預檢資料(E)...
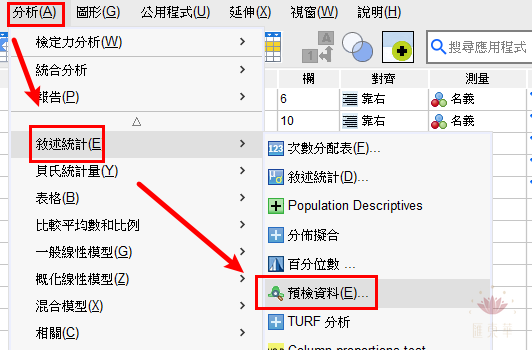
圖1、SPSS 功能表操作路徑
(點擊圖片可開啟原圖放大檢視)
本模組在部分 SPSS 版本或簡體介面中稱為「探索」,位置與功能相同。
步驟 2|把變數放進「應變數清單」
在左側變數清單中選取要檢定的連續變數(本例為 Fatigue),用中間的箭頭按鈕送進右上方的「應變數清單(D)」。
「應變數清單」只放連續變數。
步驟 3|按右側的「圖形(T)...」
對話框右側有四個按鈕:統計量(S)、圖形(T)、選項(O)、拔靴法(B)。常態性檢定不在「統計量」裡,在「圖形」裡,此為最多人第一次操作時卡住的地方。
步驟 4|勾選「常態圖(含檢定)(O)」
點開「圖形」之後會跳出第二層對話框。在左側「盒形圖」區塊的正下方,勾選「常態圖(含檢定)(O)」。
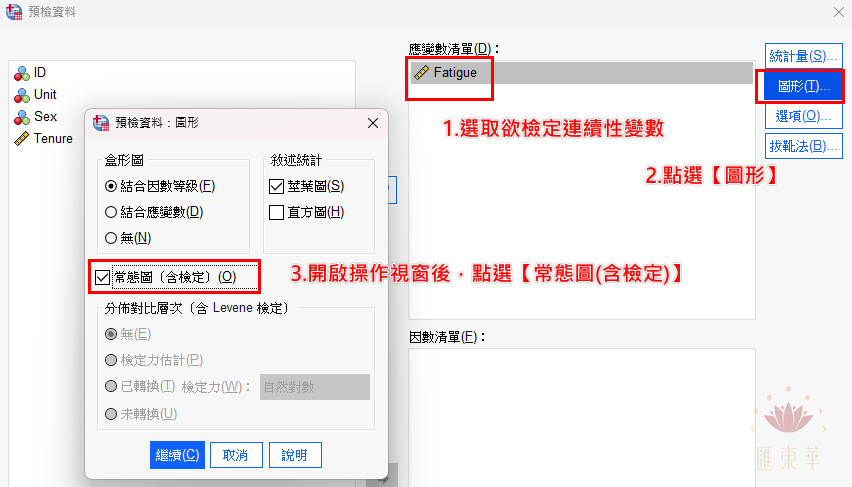
圖2、SPSS「預檢資料」對話框與其「圖形」子對話框
(點擊圖片可開啟原圖放大檢視)
本選項同時輸出三結果:
- 輸出
Tests of Normality表(兩種檢定的統計量與 p 值) - 輸出
Normal Q-Q Plot(常態 Q-Q 圖) - 輸出
Detrended Normal Q-Q Plot(去趨勢常態 Q-Q 圖)
若無勾這一項,則不會執行常態性檢定,就看不到上述輸出結果。對話框裡其他預設值可先不動;右側「敘述統計」區塊的「莖葉圖(S)」預設已勾選,若你也想要檢視直方圖,可勾選「直方圖(H)」即可。
步驟 5|「繼續(C)」回到主對話框,按「確定」
輸出視窗就會出現結果。
03|輸出怎麼看
按下確定之後,主要結果表格如下:
Tests of Normality(常態檢定)
回答:這筆資料偏離常態的程度,是否大到足以被偵測出來?
| Kolmogorov-Smirnov ᵃ 統計量 | df | Sig. | Shapiro-Wilk 統計量 | df | Sig. | |
|---|---|---|---|---|---|---|
| Fatigue 疲勞量表總分 | .040 | 200 | .200 * | .992 | 200 | .302 |
(表格較寬,手機可左右滑動檢視)
ᵃ. Lilliefors Significance Correction(Lilliefors 顯著性校正) *. This is a lower bound of the true significance.(這是真實顯著性的下界)
逐欄判讀
| 欄位 | 它是什麼 | 怎麼看 |
|---|---|---|
Statistic | 檢定統計量。K-S 是實際分布與理論常態分布之間最大的落差;S-W 反映資料與常態分布的吻合程度,最大為 1。 | 不用直接判讀,它是 Sig. 的計算基礎。S-W 統計量越接近 1,與常態越吻合 |
df | 這個檢定實際用到的觀察值個數 | 應該等於第一張表的「有效 N」。不一致就要回頭查 |
Sig. | p 值,判讀就看這一欄 | p 大於 0.05:沒有足夠證據說它偏離常態。p 小於 0.05:有證據顯示偏離常態 |
(表格較寬,手機可左右滑動檢視)
本例:K-S 的 p 大於 .200,Shapiro-Wilk 的 p 為 .302,兩者均大於 0.05。結論為,此 200 筆疲勞量表總分沒有顯示出足以被偵測到的常態偏離。
兩個腳註不要跳過
- 腳註 a:
Lilliefors Significance Correction。本欄的 K-S 顯著水準為經過 Lilliefors 校正的。即表示所執行之分析為經過校正版本,Sig.欄可以直接照後面的規則判讀。 - 腳註
*:This is a lower bound of the true significance.為最常被誤讀的一行。SPSS 印出的.200不是精確的 p 值,而是下界,真正的 p 值比 .200 更大。所以看到.200*,正確的讀法是「p > .200」,寫進論文時也應該寫成p > 0.200,不要寫成p = 0.200。
兩個檢定同時印在同一張表上時,主判準看 Shapiro-Wilk。依據是 Razali 與 Wah(2011)以 Monte Carlo 模擬比較四種常態性檢定的檢定力,也就是「資料其實不是常態時,這個檢定抓不抓得出來」的能力:在各種分布型態與樣本數之下,Shapiro-Wilk 的偵測能力都是最強的,Kolmogorov-Smirnov 最弱;套用 Lilliefors 校正後的 K-S 雖然穩定優於未校正的 K-S,但仍不及 Shapiro-Wilk。K-S 那幾欄不必遮住,留著當參考即可,但不要當成主要依據。有一種情況例外:樣本數超過 5,000 時,SPSS 不會計算 Shapiro-Wilk,表上只印得出 K-S;不過在那樣的樣本量下,任何細微的偏離都會顯著,此時更應該回到 Q-Q 圖判斷形狀,不要只看 p 值。若兩者結果不一致,不要挑對自己有利的那個報:不一致本身就是訊息,代表資料落在判定的邊界上,這時回到 Q-Q 圖看形狀,以及偏離集中在哪一段。
04|依組別分開檢定:只多做一個動作
接下來要分析的是兩組比較,想了解各組內部之分布。操作上只需要多做一件事。
操作差異
回到「預檢資料」主對話框,把分組變數(本例為 Sex)放進「因數清單(F)」。其餘步驟與第 02 節完全相同:按「圖形(T)」,勾「常態圖(含檢定)(O)」,「繼續(C)」,確定。
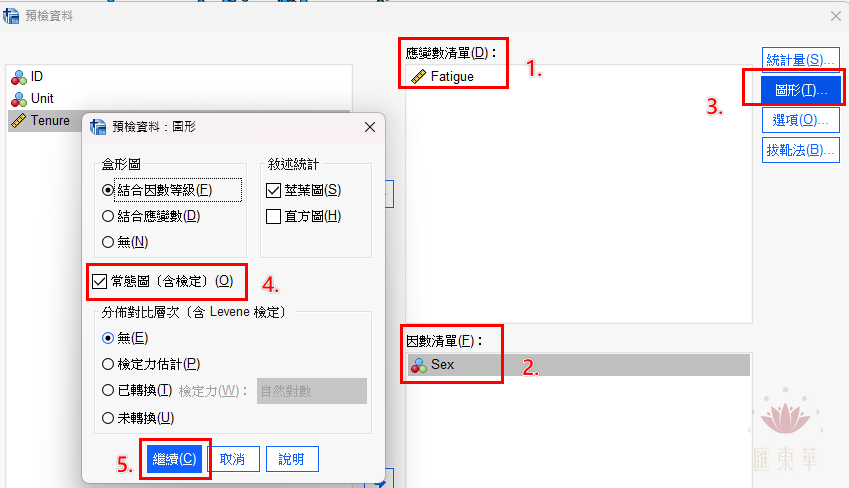
圖3、SPSS「預檢資料」對話框的分組做法
(點擊圖片可開啟原圖放大檢視)
「因數清單」放的是分組用的類別變數。放進去之後,SPSS 會把前面的表全部按組別各輸出一次。
輸出差異
多出一個組別欄。以下是本例的實際輸出。
Tests of Normality(依性別)
| 性別 | Kolmogorov-Smirnov ᵃ 統計量 | df | Sig. | Shapiro-Wilk 統計量 | df | Sig. |
|---|---|---|---|---|---|---|
| 0 男 | .065 | 33 | .200 * | .982 | 33 | .831 |
| 1 女 | .051 | 167 | .200 * | .991 | 167 | .405 |
(表格較寬,手機可左右滑動檢視)
ᵃ. Lilliefors Significance Correction *. This is a lower bound of the true significance.
判讀:四個 p 值全部大於 0.05,兩組均沒有顯示可偵測之常態偏離。
另要對 Q-Q 圖的形狀進行評估
- Normal Q-Q Plot:資料點越貼近那條斜線,越接近常態。看的是整體貼合程度。
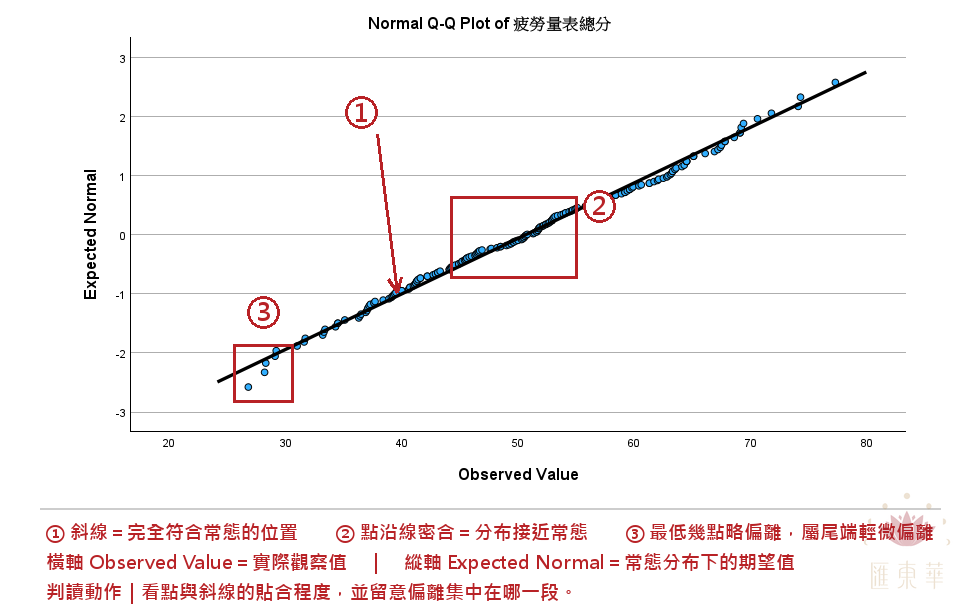
圖4、Normal Q-Q Plot(常態 Q-Q 圖):不分組、全體 200 人。圖為 SPSS 實際輸出,紅色標示與中文對照為本文另加。
(點擊圖片可開啟原圖放大檢視)
- Detrended Normal Q-Q Plot(去趨勢版):把斜線拉平成水平線,畫的是每一點偏離斜線的殘差。看的是偏離集中在哪一段,是兩端翹起、還是中間鼓起。
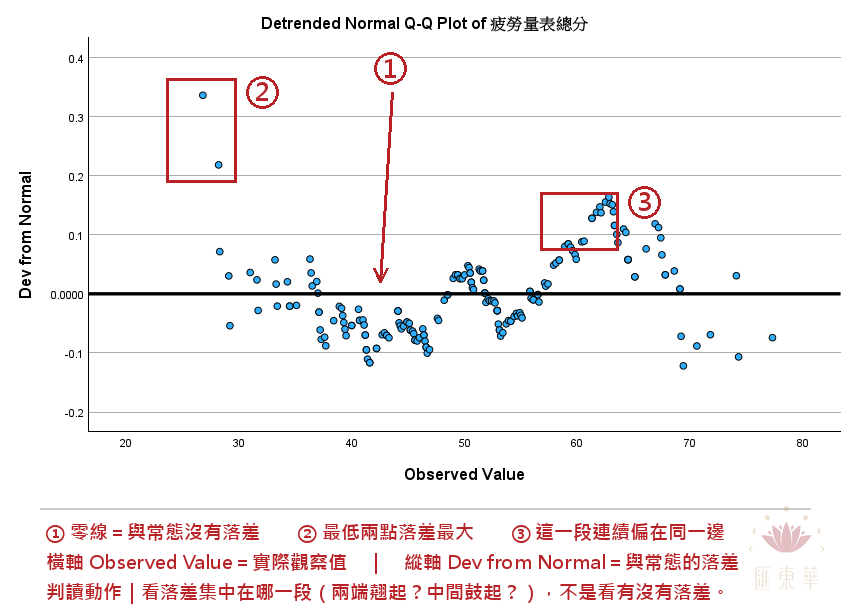
圖5、Detrended Normal Q-Q Plot(去趨勢常態 Q-Q 圖):同一份資料。圖為 SPSS 實際輸出,紅色標示與中文對照為本文另加。
(點擊圖片可開啟原圖放大檢視)
這兩張圖回答的是 p 值答不了的問題:偏離在哪裡、有多大。p 值只告訴你偏離有沒有大到被偵測出來。
一句話收掉這一節:檢定看數字,圖形看形狀,兩個一起看。
如果你是第一次用 SPSS 跑統計,從資料輸入、變數設定到描述性統計與常態分布檢定這一整段,我們有一門從零開始的課: A01-SPSS零基礎入門統計課程
05|把本例從頭判一次
以下是把前面所有數字串起來的完整判讀,也是你在方法段或結果段可以照著寫的順序。
第一步,看檢定。 不分組時 Shapiro-Wilk p = .302,Kolmogorov-Smirnov(Lilliefors 校正)p > .200。依性別分組後,男性組 p = .831 與 p > .200,女性組 p = .405 與 p > .200。六個 p 值全部大於 0.05。
第二步,看形狀指標。 偏態與峰度除以各自的標準誤之後,六個 Z 值都落在該組樣本數適用的範圍內(男性組 33 人適用 ±1.96,全體與女性組適用 ±3.29)。平均數 50.656 與中位數 50.750 幾乎重疊,5% 修整平均數 50.641 與平均數也幾乎一致,沒有被極端值拉動的跡象。上述偏態、峰度與各自的標準誤,以及平均數、中位數與 5% 修整平均數,都在同一次「預檢資料」輸出的敘述統計表裡,本文未另列該表。
第三步,看圖。 把 Normal Q-Q Plot 叫出來(見圖4)確認資料點沿斜線分布,並用去趨勢圖(見圖5)確認偏離沒有集中在某一段。
結論:這份疲勞量表總分,無論就整體或依性別分組,都沒有顯示出足以被偵測到的常態偏離。
寫進論文時的句子:「疲勞量表總分經 Shapiro-Wilk 檢定,整體樣本(N = 200)p = .302;依性別分組後,男性(n = 33)p = .831、女性(n = 167)p = .405,均未達顯著,並輔以常態 Q-Q 圖與偏態、峰度 Z 值檢視,未觀察到顯著的常態偏離。」
注意這句話的寫法:報的是 p 值本身,不是「通過檢定」四個字,而且把樣本數一起寫出來。因為讀者要能自己判斷這個「未達顯著」是在多大的樣本下得到的。
參考文獻
- IBM Corporation. IBM SPSS Statistics 29 Command Syntax Reference(version 29, release 0, modification 1)。引用段落:EXAMINE 指令之 PLOT 次指令(NPPLOT 關鍵字)、NPAR TESTS 指令之 K-S 次指令(One-Sample)。查閱日期:2026 年 9 月 13 日。
- Ghasemi, Asghar, and Saleh Zahediasl. "Normality Tests for Statistical Analysis: A Guide for Non-Statisticians." International Journal of Endocrinology and Metabolism, vol. 10, no. 2, 2012, pp. 486–489. DOI: 10.5812/ijem.3505
- Mishra, Prabhaker, Chandra M. Pandey, Uttam Singh, Anshul Gupta, Chinmoy Sahu, and Amit Keshri. "Descriptive Statistics and Normality Tests for Statistical Data." Annals of Cardiac Anaesthesia, vol. 22, no. 1, 2019, pp. 67–72. DOI: 10.4103/aca.ACA_157_18
- Razali, Nornadiah Mohd, and Yap Bee Wah. "Power Comparisons of Shapiro-Wilk, Kolmogorov-Smirnov, Lilliefors and Anderson-Darling Tests." Journal of Statistical Modeling and Analytics, vol. 2, no. 1, 2011, pp. 21–33.
AI 使用聲明
本文由匯東華統計顧問有限公司 陳秀敏 博士撰稿,Claude Opus 5 協助原文檢索、引用核對與版面排版,最終內容已由作者審閱定稿。文中所有 SPSS 操作畫面與輸出數值,均取自本公司以該份模擬資料實際執行之結果,非示意圖或轉載;判準依據取自上列方法學文獻原文,軟體行為之陳述取自 IBM SPSS Statistics 29 官方指令語法參考手冊,均逐項核對。示範資料為教學用模擬資料,非真實個人資料。日期:2026 年 9 月 18 日。
同期其他單元
- 統計方法實務|p < 0.05 就有實務意義嗎?
- 臨床預測模型系列 No. 02|預測模型的 ROC 曲線、校準圖與決策曲線:介紹與判讀
- 研究誠信與 AI 治理系列 No. 04|醫院導入生成式 AI:五項治理重點
匯東華電子報 第 5 期|2026.09.18|看本期網頁版 →
聯絡我們
- LINE:@medatatw
- Email:info@medatatw.com
- 電話:07-9721586
- 官網:www.medatatw.com

統計分析
服務價目表 (未含5%營業稅)
透過嚴謹的數據整理,提供有價值的資訊,形塑知識,提高決策品質。包括信達雅三執行原則。
信:確保資料品質可信賴
達:確保統計方法適切性
雅:確保圖文表格正規化
協助代執行統計分析與進一步加值服務。
在匯東華與夥伴的專業背景知識配合下,能有效地處理面對的問題。
統計分析成果

數據串接與清洗
數據是礦藏,數據清洗是挖出鑽石的第一步,尤其是巨量知識。數據清洗或串接執行過程需要細心與專注,且有可能會消耗許多時間和精力,就由我們來替各位處理掉這個大麻煩。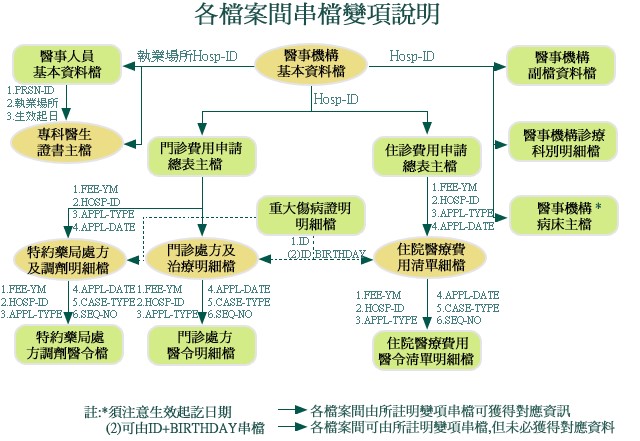
全民健保研究資料庫、國外大型資料庫資料非常齊全,種類多,需要串接與清洗,進行正規化後才能更進一步進行資料探勘與統計分析。
Fig1.同一個Project資料散落在不同tables,無法使用
Fig2.整併與清理為可分析的table
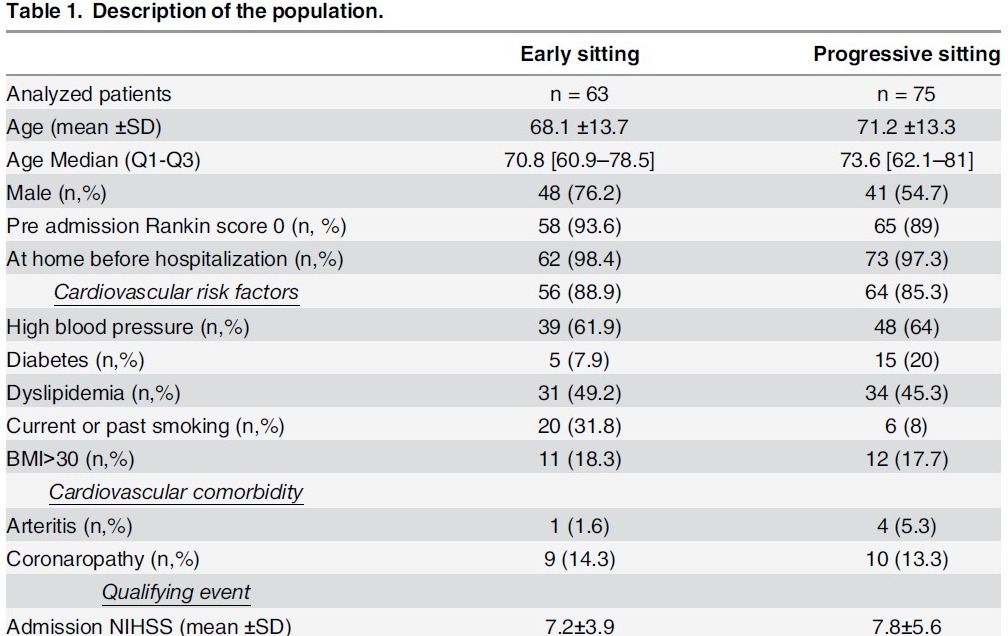
Fig.3整理和分析後形成有意義的知識
概念與流程示意圖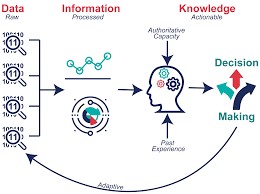

計畫撰寫與統計諮詢
為了讓匯東華的顧客與學員有更好的合作和消費體驗,故匯東華特別依據營業項目開發周邊產品,提供使用、購買。目前已有針對公共衛生師的題庫以及模擬試題,未來將針對醫學研究領域發展產品。