 匯東華統計顧問有限公司
一頁先懂|核心判斷
預測模型的三張核心圖,分別回答三個問題:
ROC 曲線:模型能否區分個體風險高低? 校準圖:預測機率是否符合實際事件比例? 決策曲線:依模型分流,是否提高淨效益?
AUC 高,不代表預測機率準確,也不代表依模型決策能提高淨效益。區辨度、校準度與臨床效用必須分別評估。
本文以模擬圖解說判讀原則,再以公開資料的重分析結果示範,最後彙整為對照表。
01|三張圖,三個不同的問題
第 4 期介紹 TRIPOD+AI 的三項評估面向:區辨度(discrimination)、校準度(calibration)與臨床效用(clinical utility)。本期說明對應圖形的判讀。
| 要評估的面向 | 主要的圖 | 這張圖回答的問題 |
|---|---|---|
| 區辨度 | ROC 曲線(附 AUC) | 模型能不能把會發生事件的人排在前面? |
| 校準度 | 校準圖 | 模型說「風險 20%」的那群人,真的大約 20% 發生嗎? |
| 臨床效用 | 決策曲線分析(DCA) | 依模型分流,比一律治療或一律不治療好嗎? |
(表格較寬,手機可左右滑動檢視)
只有 ROC 曲線,尚不足以判斷模型是否適合臨床使用;還須檢視校準與決策效益。
完整開發流程可參考 Efthimiou 等人於 2024 年《BMJ》提出的 13 步驟指引;本文聚焦其中的模型評估。
真實案例採用 Eom 等人 2015 年《PLOS ONE》韓國胃癌術後存活研究的公開附件資料。圖形與數值為我方重新擬合、在驗證世代計算的教學結果,非原文圖表;適用限制請見文末。
02|區辨度:ROC 曲線與 AUC
圖形結構
橫軸為偽陽性率(1 減特異度),縱軸為敏感度。改變分類門檻,即可得到不同之敏感度與偽陽性率組合,連成 ROC 曲線。
左下至右上的對角線代表無區辨能力,AUC 為 0.5。曲線越靠近左上角,區辨度越佳;曲線下面積為 AUC,1.0 代表完美區分。
評估重點
AUC 衡量模型將事件個案排在非事件個案之前的能力;主要評估風險排序,不評估預測機率是否準確。
判讀步驟
- 確認座標軸。部分圖以特異度為橫軸,刻度由 1 遞減至 0,須注意方向。
- 檢視曲線及 AUC 的 95% 信賴區間。區間越寬,估計的不確定性越高。
- 檢視曲線形狀。相同 AUC 可能對應不同的敏感度與特異度組合。
- 對照臨床需求。篩檢應先設定可接受的敏感度,再檢查相應的偽陽性率;侵入性檢查則須權衡漏診與不必要檢查的代價,不能固定以曲線左半段或右半段判定用途。
下圖示範相同 AUC 下的曲線差異。
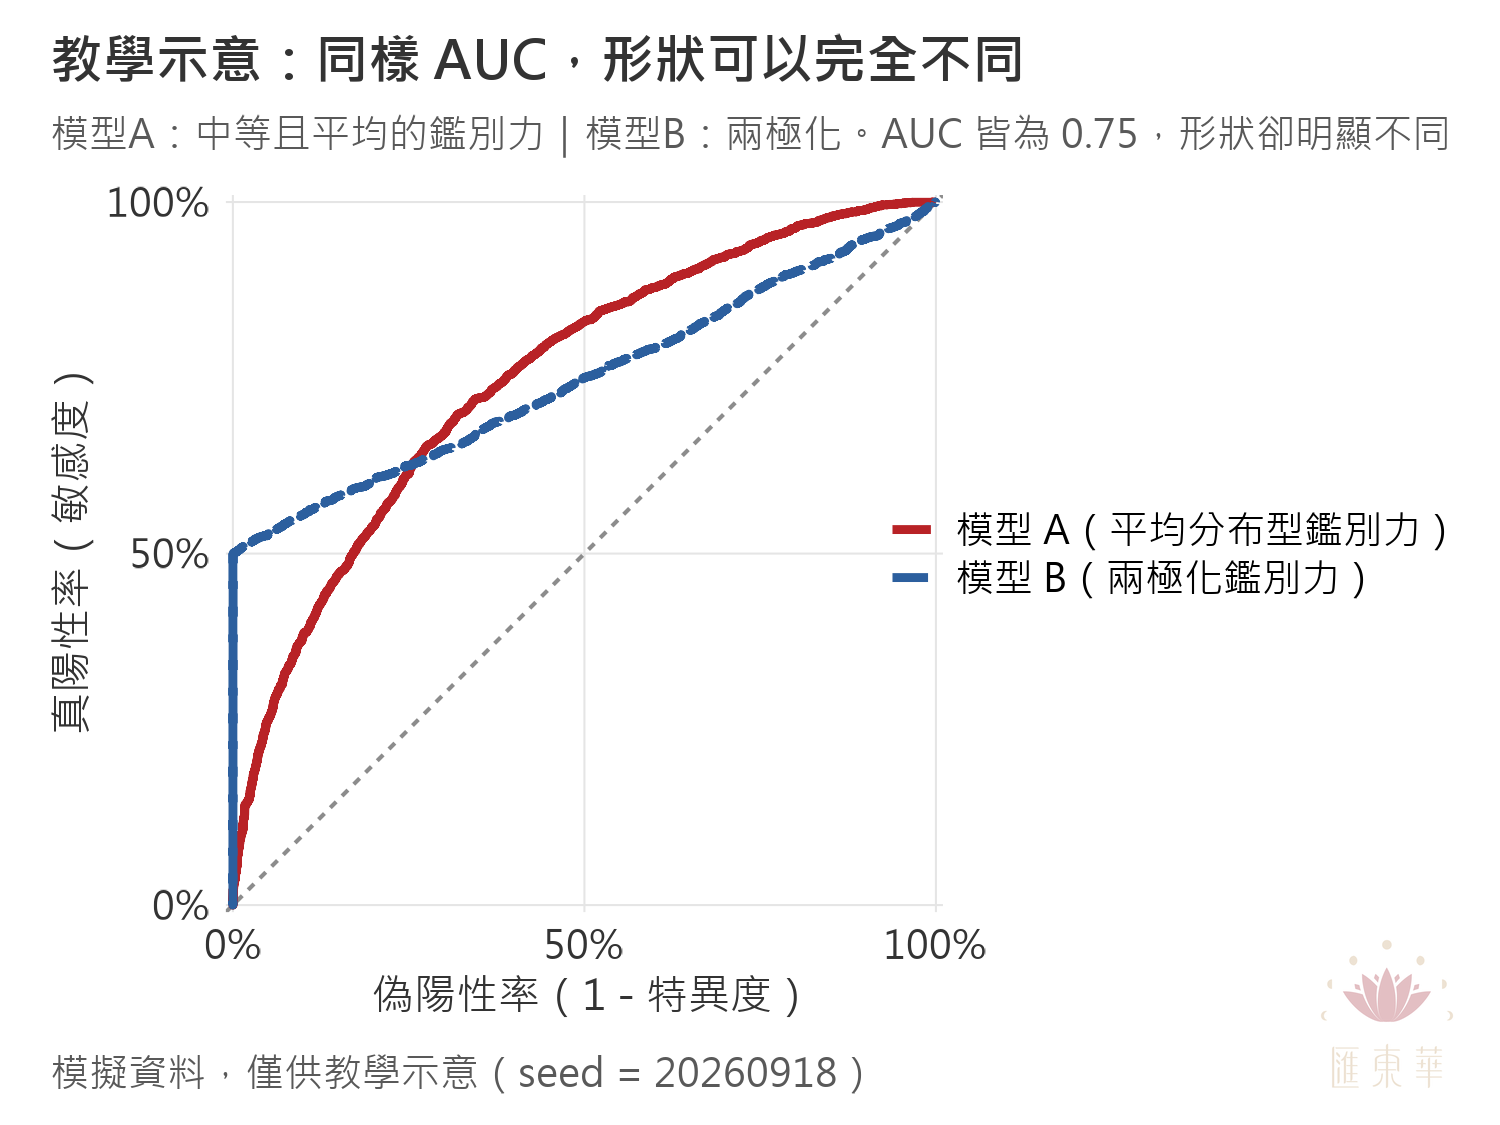
同 AUC、不同形狀的 ROC 曲線(模擬資料)。模型 A 為紅色實線,模型 B 為藍色虛線,兩者 AUC 皆為 0.75;模型 B 在偽陽性率 0% 處的敏感度即達 50%。相同總體 AUC,仍可能有不同的局部表現。
(點擊圖片可開啟原圖放大檢視)
曲線差異須在預指定的操作條件下比較;僅憑曲線形狀,不能判定模型適合廣泛篩檢或特定亞群。
AUC 沒有通用的及格線。除數值本身,還須考慮預定用途與現行方法的表現。
真實案例
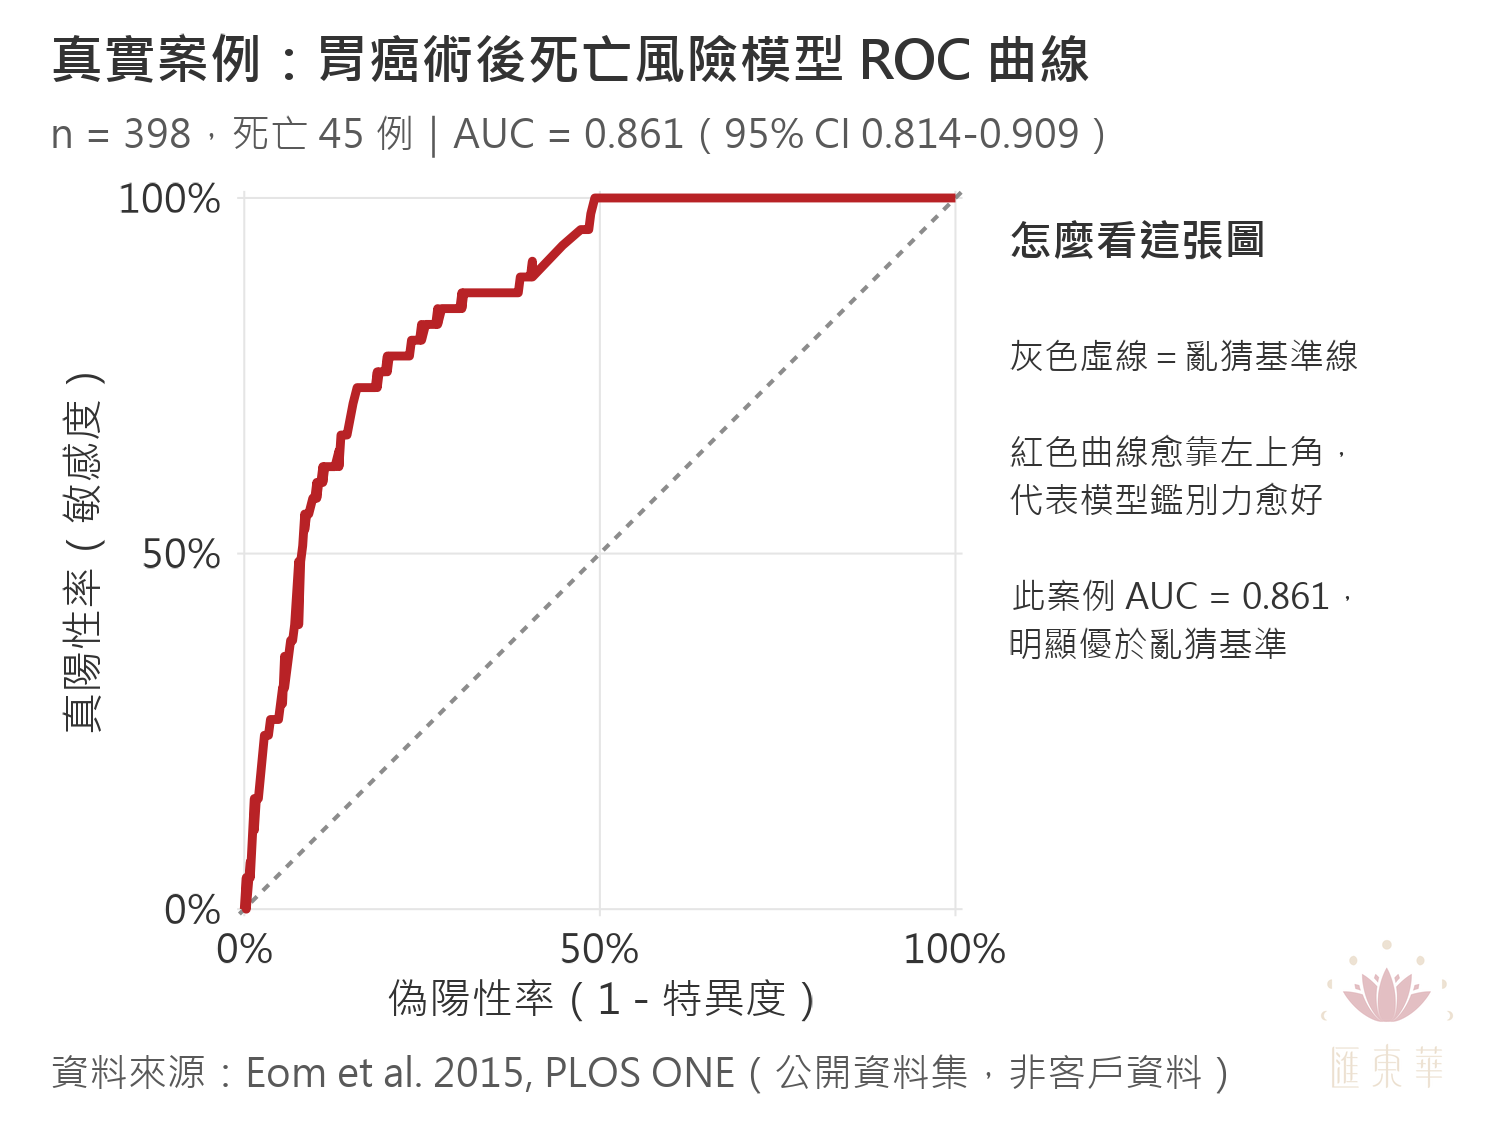
胃癌術後 36 個月死亡風險 Logistic 模型的 ROC 曲線。驗證世代 n = 398,死亡事件 45 例;AUC = 0.861(95% CI 0.814-0.909)。資料源自 Eom 等人(2015)公開附件,為我方重分析結果。
(點擊圖片可開啟原圖放大檢視)
此結果支持模型具有區辨度;預測機率是否準確、依模型介入是否有益,仍須看校準圖與決策曲線。
03|校準度:校準圖
本節以校準圖檢視預測機率與觀察比例的一致性,並說明兩項常見數值:Hosmer-Lemeshow 檢定檢查分組差異;Brier score 則補充整體機率預測誤差,不能單獨代表校準度。
圖形結構
橫軸為預測風險,縱軸為實際事件比例。兩軸採相同範圍與比例時,45 度對角線代表完美校準:預測風險與觀察比例一致。
常見畫法包括依預測風險分成十分位、繪出各組觀察比例及 95% 信賴區間,或以不分組的平滑曲線呈現。
評估重點
校準評估預測機率與實際事件比例是否一致。例如,預測風險為 R% 的病人群體,實際事件比例是否接近 R%。
判讀步驟
- 確認兩軸定義、範圍與比例;判讀應以預測風險等於觀察比例的參考線為準。
- 檢視點或曲線位於參考線上方或下方。
- 檢視信賴區間。寬度受組內人數、事件比例及估計方法影響;本文各組人數相近,事件比例接近 50% 的組別通常較寬。須合併評估偏離幅度與不確定性。
- 確認偏離所在的風險區間,判斷對臨床決策的影響。
如何判斷高估與低估
| 曲線的位置 | 意思 | 臨床後果 |
|---|---|---|
| 落在對角線下方 | 觀察比例低於預測風險 → 模型高估 | 可能增加不必要的介入或焦慮 |
| 落在對角線上方 | 觀察比例高於預測風險 → 模型低估 | 可能低估介入需求,錯失處置時機 |
| 貼著對角線 | 預測與實際一致 | 支持相應資料範圍內的校準表現 |
(表格較寬,手機可左右滑動檢視)
橫軸為預測風險、縱軸為觀察比例時:線下代表高估,線上代表低估。
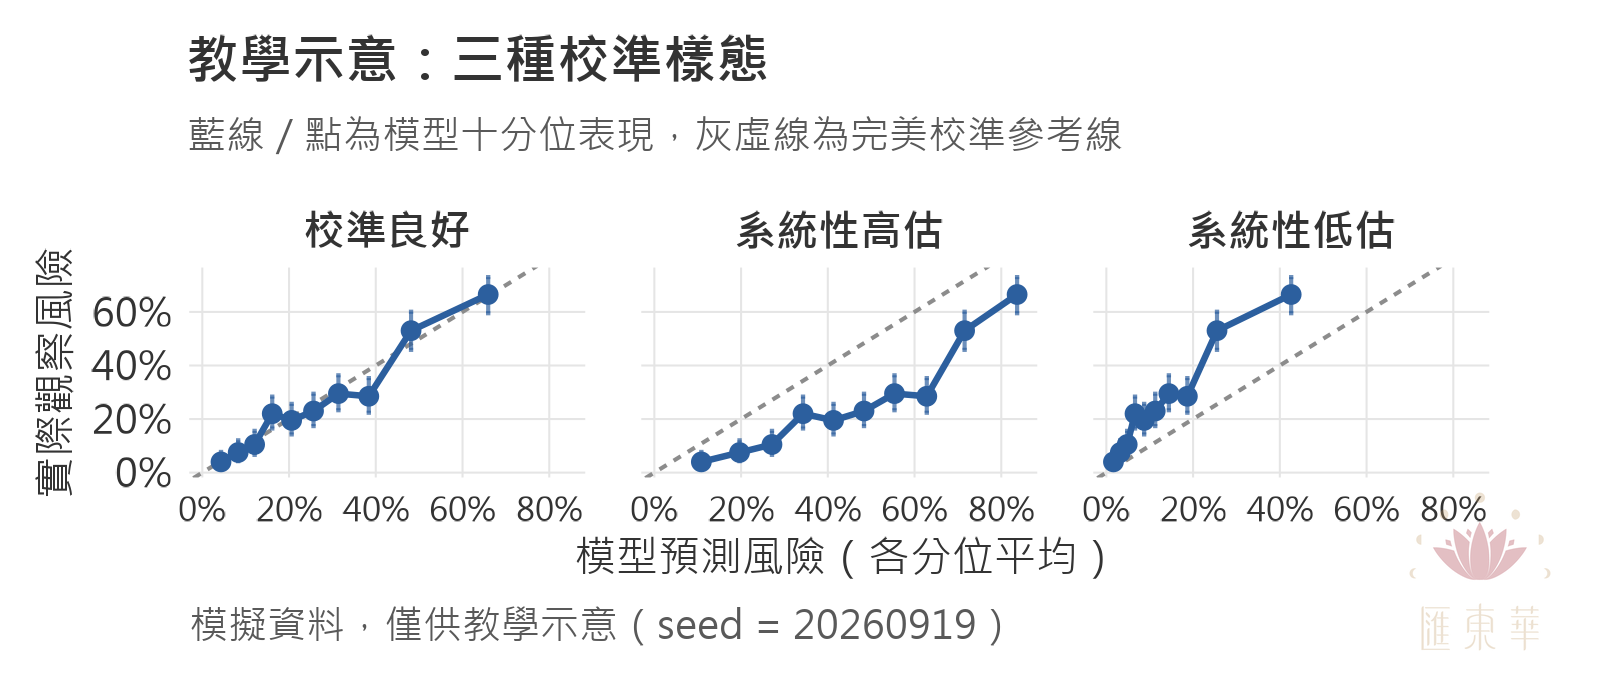
三種校準樣態(模擬資料)。曲線貼近對角線代表校準良好;落在下方代表高估,上方代表低估。各圖以十分位分組並附 95% 信賴區間。
(點擊圖片可開啟原圖放大檢視)
若風險轉換保留排序且不產生新的同分,AUC 不變,校準卻可能改變。因此,區辨度相同模型仍可能有不同的機率誤差。
Hosmer-Lemeshow 檢定:檢查分組預測與觀察的差異
Hosmer-Lemeshow(H-L)是常見於 Logistic 迴歸的適合度檢定。先依預測風險分組(常分為十組),再比較各組實際與預期的事件、非事件人數;預期事件數為組內預測機率的總和。將各項「觀察人數減預期人數」的平方除以預期人數後加總,得到卡方統計量,再求得 p 值。
p 值小表示分組預測與觀察結果有差異;未達顯著則只代表未偵測到差異,不能證明校準良好。單一 p 值也無法交代偏離的方向、幅度與風險區間,仍須檢視校準圖。
Eom 等人原文第 7 頁圖 2b,以風險十分位呈現預測與觀察的 5 年存活率;觀察值以 Kaplan-Meier 法估計。原文報告 H-L 卡方為 3.92(p = 0.917),屬於原研究的 5 年存活模型,並非本文 36 個月死亡風險 Logistic 重分析的檢定結果。
Brier score:補充整體機率預測誤差
Brier score 將每人的預測機率減去實際結果(事件發生記為 1,未發生記為 0),平方後取平均。二元結果的分數介於 0 至 1,越低表示整體誤差越小;它非單純的校準度指標,也不能指出風險被高估或低估的位置。一般作為輔助性指標。
真實案例
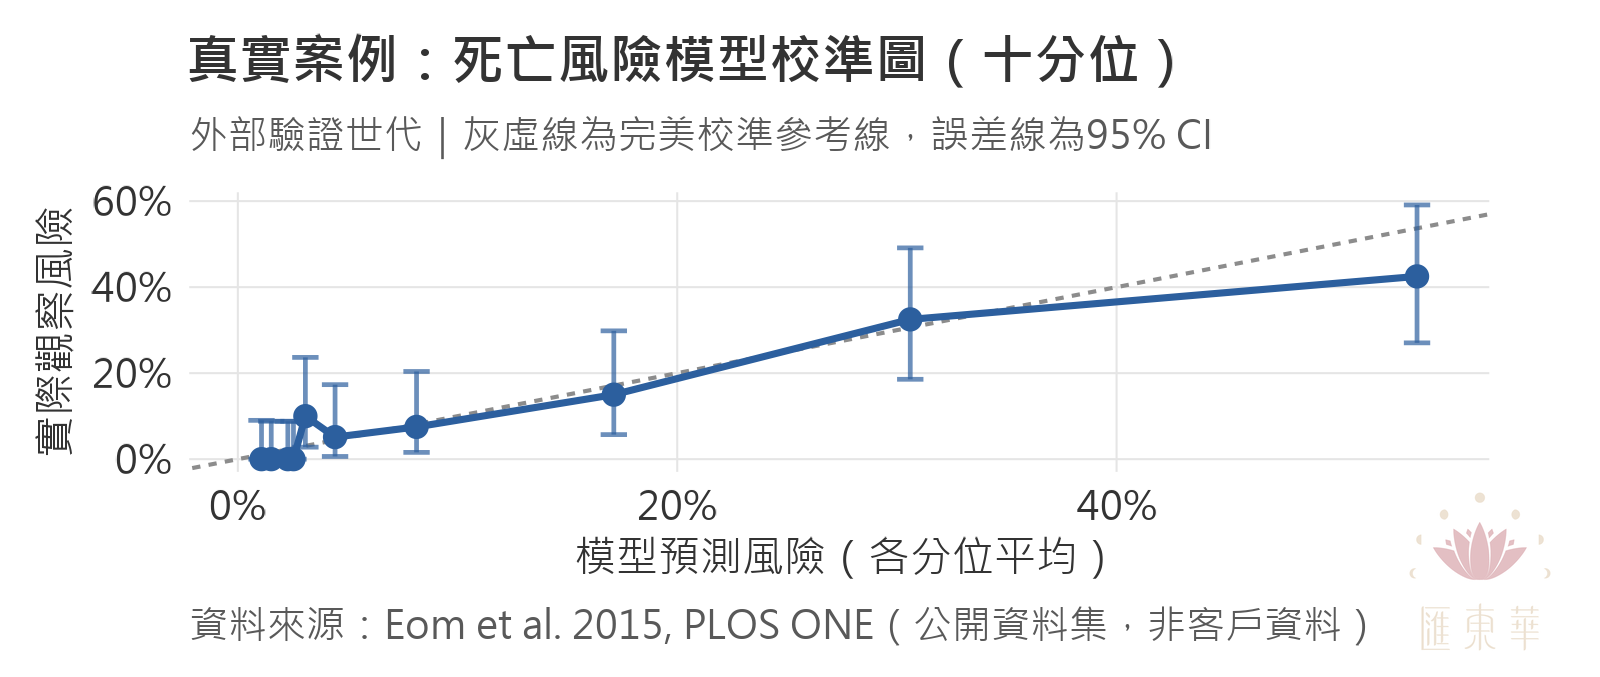
胃癌術後 36 個月死亡風險模型的十分位校準圖,附 95% 信賴區間。多數分位接近對角線,部分高風險分位偏離;各組 39 至 40 人,事件比例接近 50% 的組別區間較寬。
(點擊圖片可開啟原圖放大檢視)
驗證世代共 398 人,Brier score 為 0.081,摘要的是整體機率預測誤差。校準仍須由圖形判讀:高風險區間估計較不精確,不能僅憑分組圖認定所有個體的預測機率均可靠。
04|臨床效用:決策曲線分析(Decision Curve Analysis, DCA)
圖形結構
橫軸為門檻機率(threshold probability),縱軸為淨效益(net benefit)。常見三條曲線:
- 模型曲線:依模型預測結果分流時的淨效益
- 全部治療(treat all):對所有人採取處置
- 都不治療(treat none):對所有人不採取處置,淨效益固定為 0
門檻機率是決定採取處置的風險水準,反映對漏失事件與不必要處置的權衡。DCA 比較不同門檻下各策略的淨效益。
Vickers 與 Elkin 提出 DCA,利用門檻機率表達偽陽性與偽陰性的相對代價,據此計算淨效益。
評估重點
在指定門檻下,依模型分流是否比全部治療或都不治療提供更高淨效益。此為採用模型之重要依據,但仍須評估實際流程、成本與適用性。
判讀步驟
- 事前界定臨床合理的門檻區間,避免依圖形結果挑選有利區段。
- 在該區間比較模型與「全部治療」「都不治療」;模型須同時高於兩者,才優於這兩項基準策略。
- 檢視淨效益差距,並考慮導入成本與流程負擔。
- 檢查 y 軸尺度,避免忽略被壓縮的曲線差異。
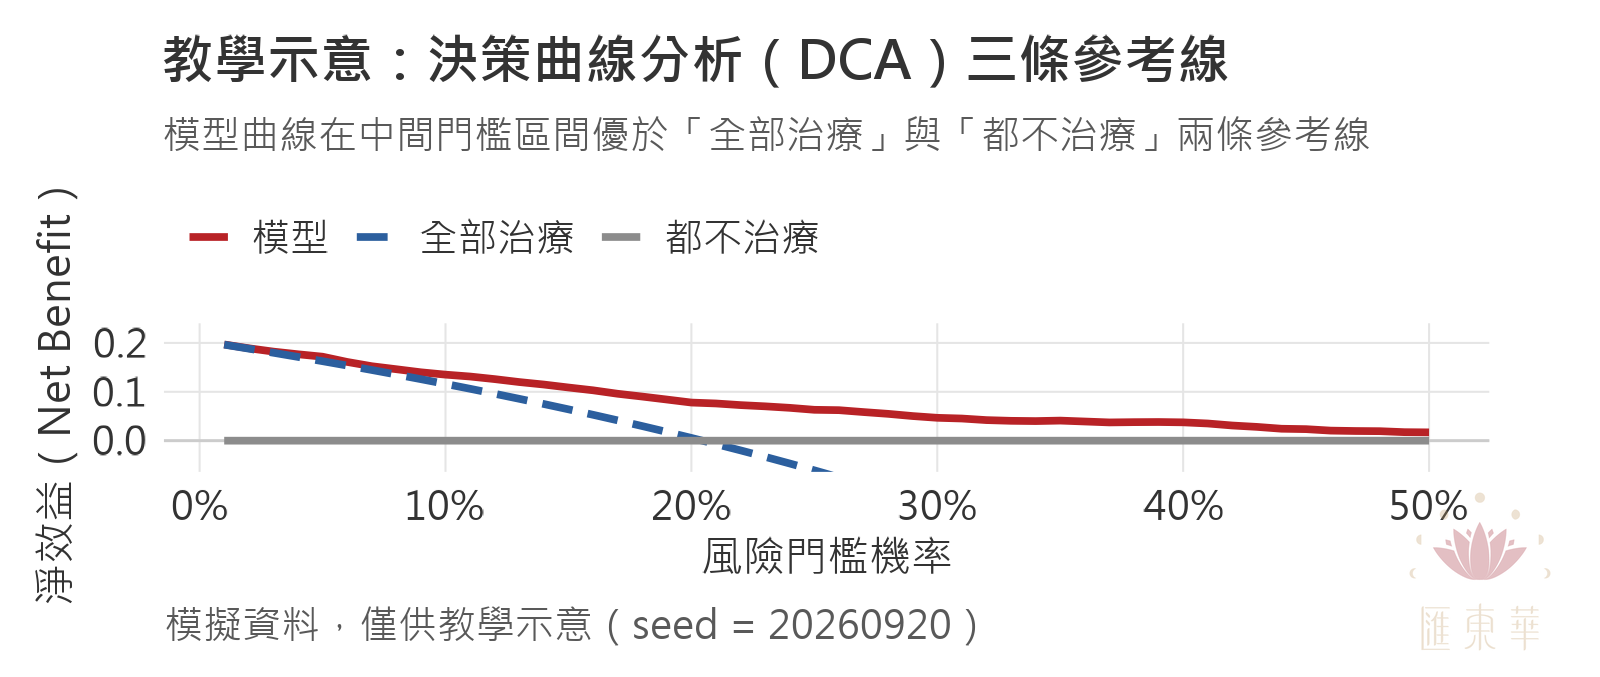
決策曲線示意(模擬資料)。紅色實線為模型,藍色虛線為全部治療,灰色零線為都不治療。圖示門檻範圍內,模型曲線高於兩項基準;門檻提高後,模型曲線逐漸接近零線,全部治療曲線約在 25% 處超出圖面下緣。
(點擊圖片可開啟原圖放大檢視)
判讀重點是臨床合理門檻內的淨效益差距;曲線較高,仍不等於差距足以支持實際導入。
真實案例:注意 y 軸尺度
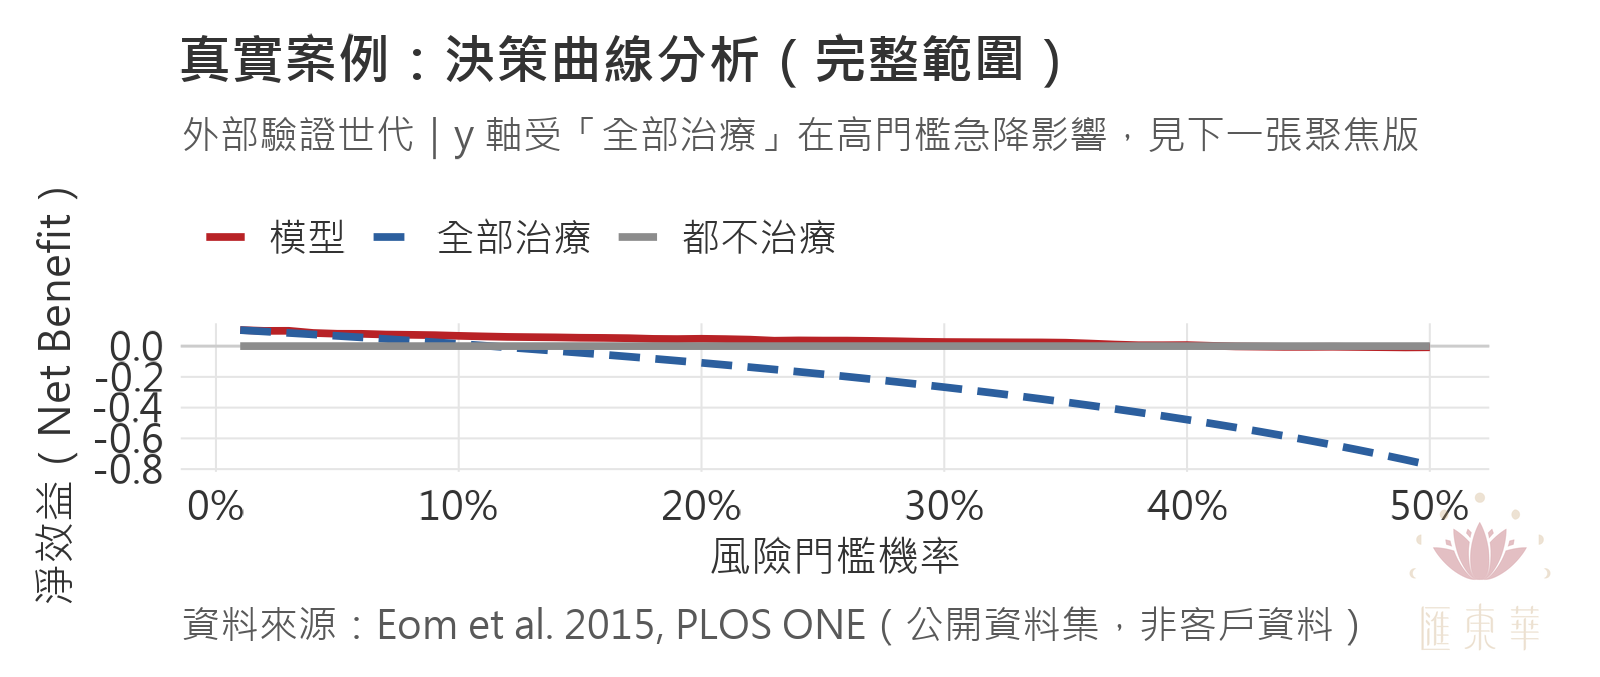
胃癌術後死亡風險模型的決策曲線(完整範圍)。全部治療策略在高門檻時降至約 -0.77,拉大 y 軸範圍,使模型與零線間的差異不易辨識。
(點擊圖片可開啟原圖放大檢視)
本圖門檻範圍為 1% 至 50%;50% 時,全部治療的淨效益約為 -0.77。較大的 y 軸範圍壓縮了模型與都不治療策略的差距。
保持 x 軸門檻範圍不變,縮小 y 軸的淨效益顯示範圍,可看清差異:
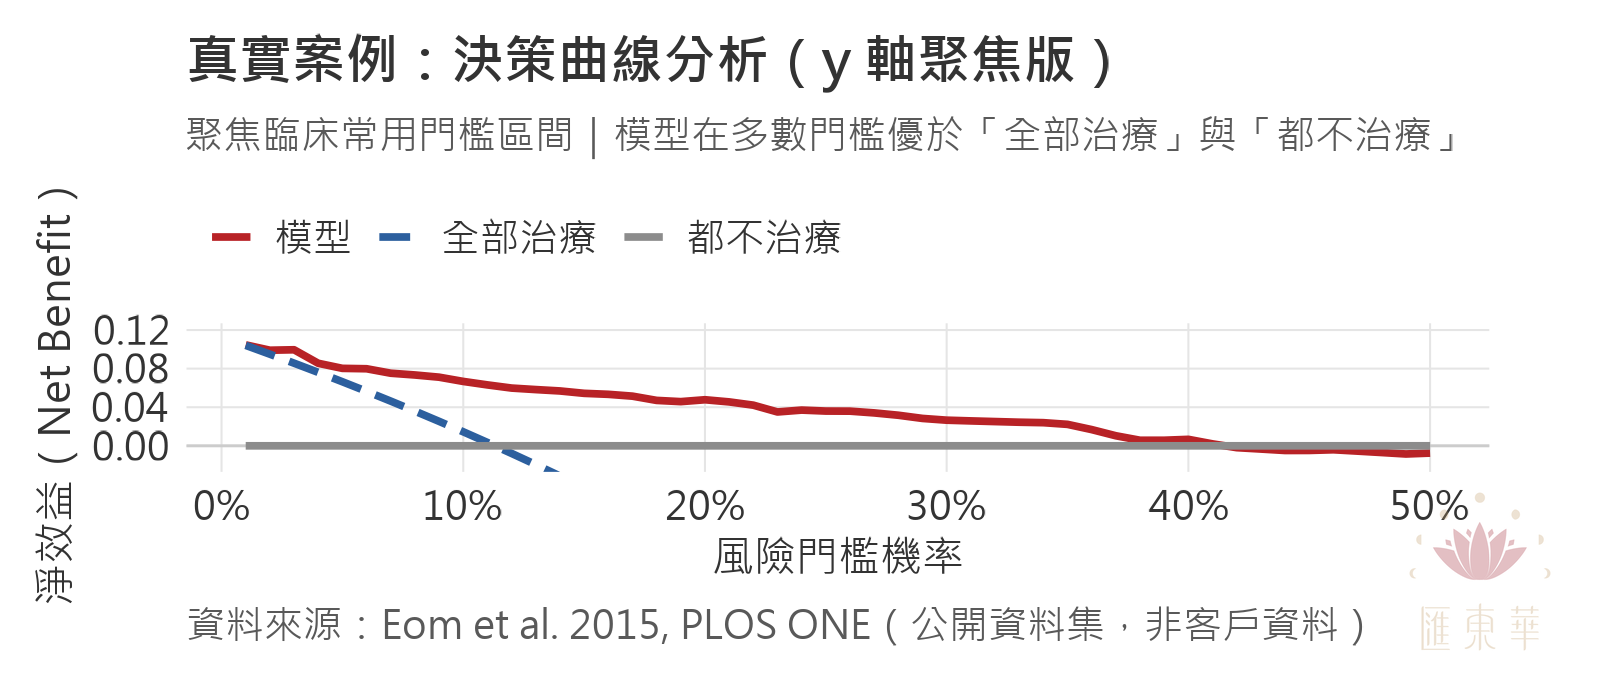
同一組決策曲線的 y 軸聚焦版(-0.02 至 0.12)。門檻機率 1% 至 41% 之間,模型曲線高於兩項基準;超過約 41% 後,模型淨效益轉負,低於都不治療。
(點擊圖片可開啟原圖放大檢視)
調整顯示尺度不會改變數值或結論。曲線看似重疊時,應先確認刻度,再判斷策略間是否確有差異;圖示優勢區間也不等於臨床已核定的介入門檻。
05|三張圖的判讀對照表
預測模型三張核心圖:判讀對照表
| ROC 曲線 / AUC | 校準圖 | 決策曲線(DCA) | |
|---|---|---|---|
| 對應的面向 | 區辨度 | 校準度 | 臨床效用 |
| 橫軸 | 偽陽性率(1 -特異度) | 模型預測的風險 | 門檻機率 |
| 縱軸 | 敏感度 | 實際觀察到的事件比例 | 淨效益 |
| 參考線 | 左下到右上的對角線(隨機猜測) | 45 度對角線(完美校準) | 全部治療、都不治療 |
| 回答的問題 | 分不分得出高低風險? | 預測機率是否準確? | 依模型決策是否增加淨效益? |
| 判讀第 1 步 | 確認兩條軸的定義與方向 | 確認兩軸等比例 | 先圈出臨床會用的門檻區間 |
| 判讀第 2 步 | 看曲線離左上角多近、AUC 與其區間 | 看曲線在對角線上方還是下方 | 在該區間內,模型是否同時高於兩條參考線 |
| 判讀第 3 步 | 看形狀,不只看數字 | 看誤差線寬度與偏離發生在哪一段 | 看高出的幅度,不只看有沒有高出 |
| 常見誤判 | 只看 AUC,忽略操作點的差異 | 只報 Hosmer-Lemeshow 的 p 值,看不出方向與位置 | 忽略 y 軸尺度,誤判曲線差距 |
| 無法單獨判斷 | 預測機率是否準確 | 依模型決策的淨效益 | 模型本身的排序能力 |
(表格較寬,手機可左右滑動檢視)
ROC 評估風險排序,校準圖檢視機率準確性,DCA 比較依模型決策的淨效益。三者互補,不能相互取代。
完整實作流程,包括 AUC、校準圖、內部驗證與列線圖,見課程: Step by Step 從零開始:R 語言預測模型實戰
結語|三張圖要一起看
評估預測模型,須同時回答三件事:能否區分風險、機率是否準確,以及決策是否有益。單一 AUC 無法涵蓋這三項判斷。
閱讀或撰寫模型論文時,應一併檢視三項評估的證據,並交代適用族群與使用限制。
這個示範案例的限制
本例採用 Eom 等人(2015)的公開附件資料;三張真實案例圖及其效能數值均為我方重分析。另引原文的 H-L 結果已於校準小節註明。使用時須注意:
一、驗證資料曾用於教材開發檢視。此世代並非完全未觸碰的最終測試集,結果僅供教學,不宜視為一次未受先前檢視影響的外部驗證。
二、本例為 36 個月死亡風險的 Logistic 教學重分析,不等同原研究的存活模型。
三、本分析以 36 個月全因死亡為結果。未滿 36 個月即設限且死亡狀態未知者排除:開發世代 48 人、驗證世代 35 人。文中 n = 398、死亡 45 例均為排除後數字。
四、AUC、事件盛行率與追蹤時間均為事後教學輸入,不代表原研究曾據此進行事前樣本數設計;用於新研究規劃時須另查依據。
下一期起
第 6 期將介紹兩個模型的 ROC 與決策曲線比較,以及如何事前訂定優劣判準。
參考文獻
- Eom BW, Ryu KW, Nam BH, Park Y, Lee HJ, Kim MC, et al. Survival Nomogram for Curatively Resected Korean Gastric Cancer Patients: Multicenter Retrospective Analysis with External Validation. PLOS ONE. 2015;10(2):e0119671. https://doi.org/10.1371/journal.pone.0119671
- Vickers AJ, Elkin EB. Decision curve analysis: a novel method for evaluating prediction models. Medical Decision Making. 2006;26(6):565-574. https://doi.org/10.1177/0272989X06295361
- Efthimiou O, Seo M, Chalkou K, Debray T, Egger M, Salanti G. Developing clinical prediction models: a step-by-step guide. BMJ. 2024;386:e078276. https://doi.org/10.1136/bmj-2023-078276
- ResourceSelection. hoslem.test: Hosmer-Lemeshow Goodness of Fit (GOF) Test. R package documentation. https://search.r-project.org/CRAN/refmans/ResourceSelection/html/hoslem.test.html
AI 使用聲明
本文由匯東華統計顧問有限公司 陳秀敏 博士撰稿,Claude Opus 5 協助原文檢索、引用核對、圖形繪製與版面排版,最終內容已由作者審閱定稿。教學示意圖(同 AUC 不同形狀的 ROC、三種校準樣態、決策曲線示意)使用模擬資料產生;真實案例的三張圖,資料來源為 Eom 等人 2015 年論文之期刊附件公開資料集,圖與數值均為我方重新擬合計算所得,非引用原文圖表,使用上之限制請見〈這個示範案例的限制〉。日期:2026 年 9 月 18 日。
同期其他單元
- 統計方法實務|p < 0.05 就有實務意義嗎?
- 研究誠信與 AI 治理系列 No. 04|醫院導入生成式 AI:五項治理重點
- 統計方法實務|SPSS 常態性檢定怎麼做?
匯東華電子報 第 5 期|2026.09.18|看本期網頁版 →
聯絡我們
- LINE:@medatatw
- Email:info@medatatw.com
- 電話:07-9721586
- 官網:www.medatatw.com

統計分析
服務價目表 (未含5%營業稅)
透過嚴謹的數據整理,提供有價值的資訊,形塑知識,提高決策品質。包括信達雅三執行原則。
信:確保資料品質可信賴
達:確保統計方法適切性
雅:確保圖文表格正規化
協助代執行統計分析與進一步加值服務。
在匯東華與夥伴的專業背景知識配合下,能有效地處理面對的問題。
統計分析成果

數據串接與清洗
數據是礦藏,數據清洗是挖出鑽石的第一步,尤其是巨量知識。數據清洗或串接執行過程需要細心與專注,且有可能會消耗許多時間和精力,就由我們來替各位處理掉這個大麻煩。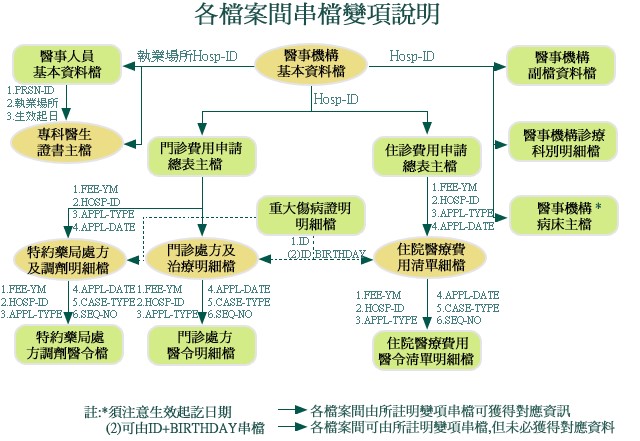
全民健保研究資料庫、國外大型資料庫資料非常齊全,種類多,需要串接與清洗,進行正規化後才能更進一步進行資料探勘與統計分析。
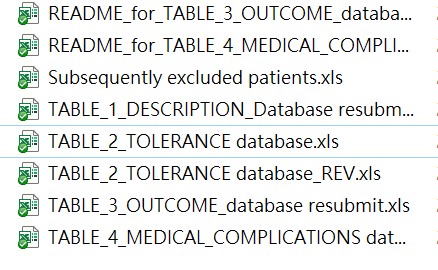
Fig1.同一個Project資料散落在不同tables,無法使用
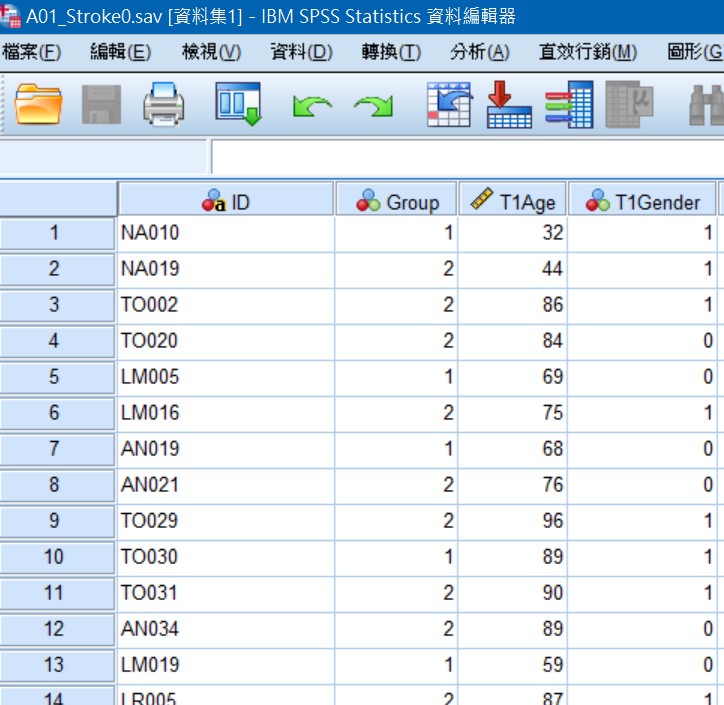
Fig2.整併與清理為可分析的table
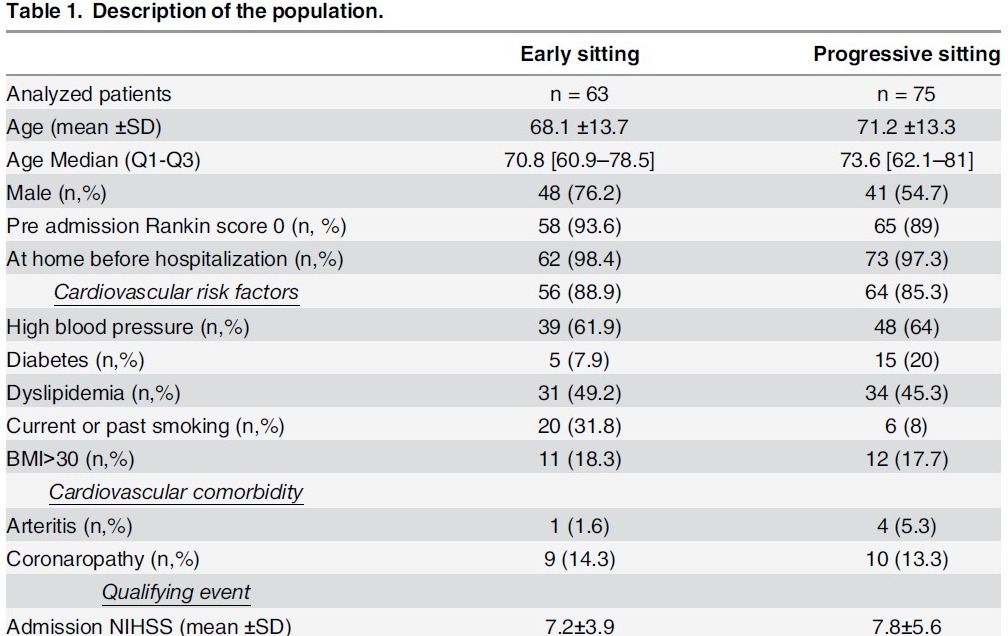
Fig.3整理和分析後形成有意義的知識
概念與流程示意圖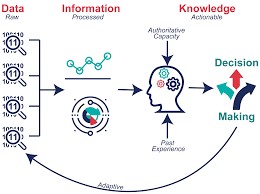

計畫撰寫與統計諮詢
為了讓匯東華的顧客與學員有更好的合作和消費體驗,故匯東華特別依據營業項目開發周邊產品,提供使用、購買。目前已有針對公共衛生師的題庫以及模擬試題,未來將針對醫學研究領域發展產品。