 匯東華統計顧問有限公司
(點擊圖片可開啟原圖放大檢視)
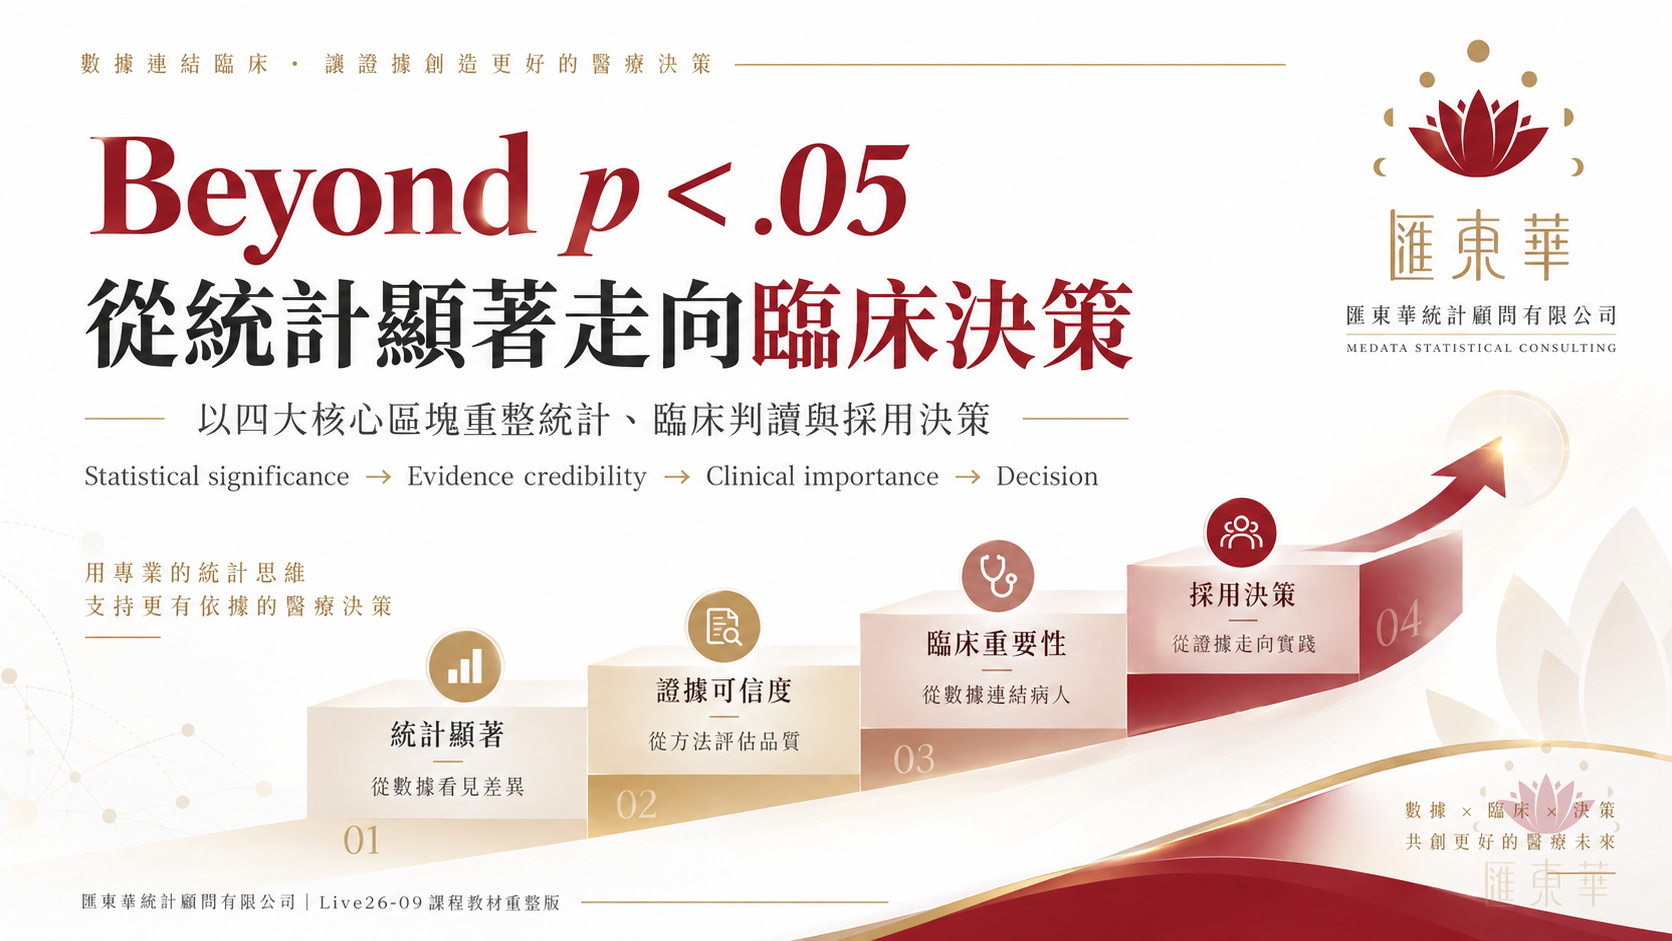
一頁先懂|核心判斷
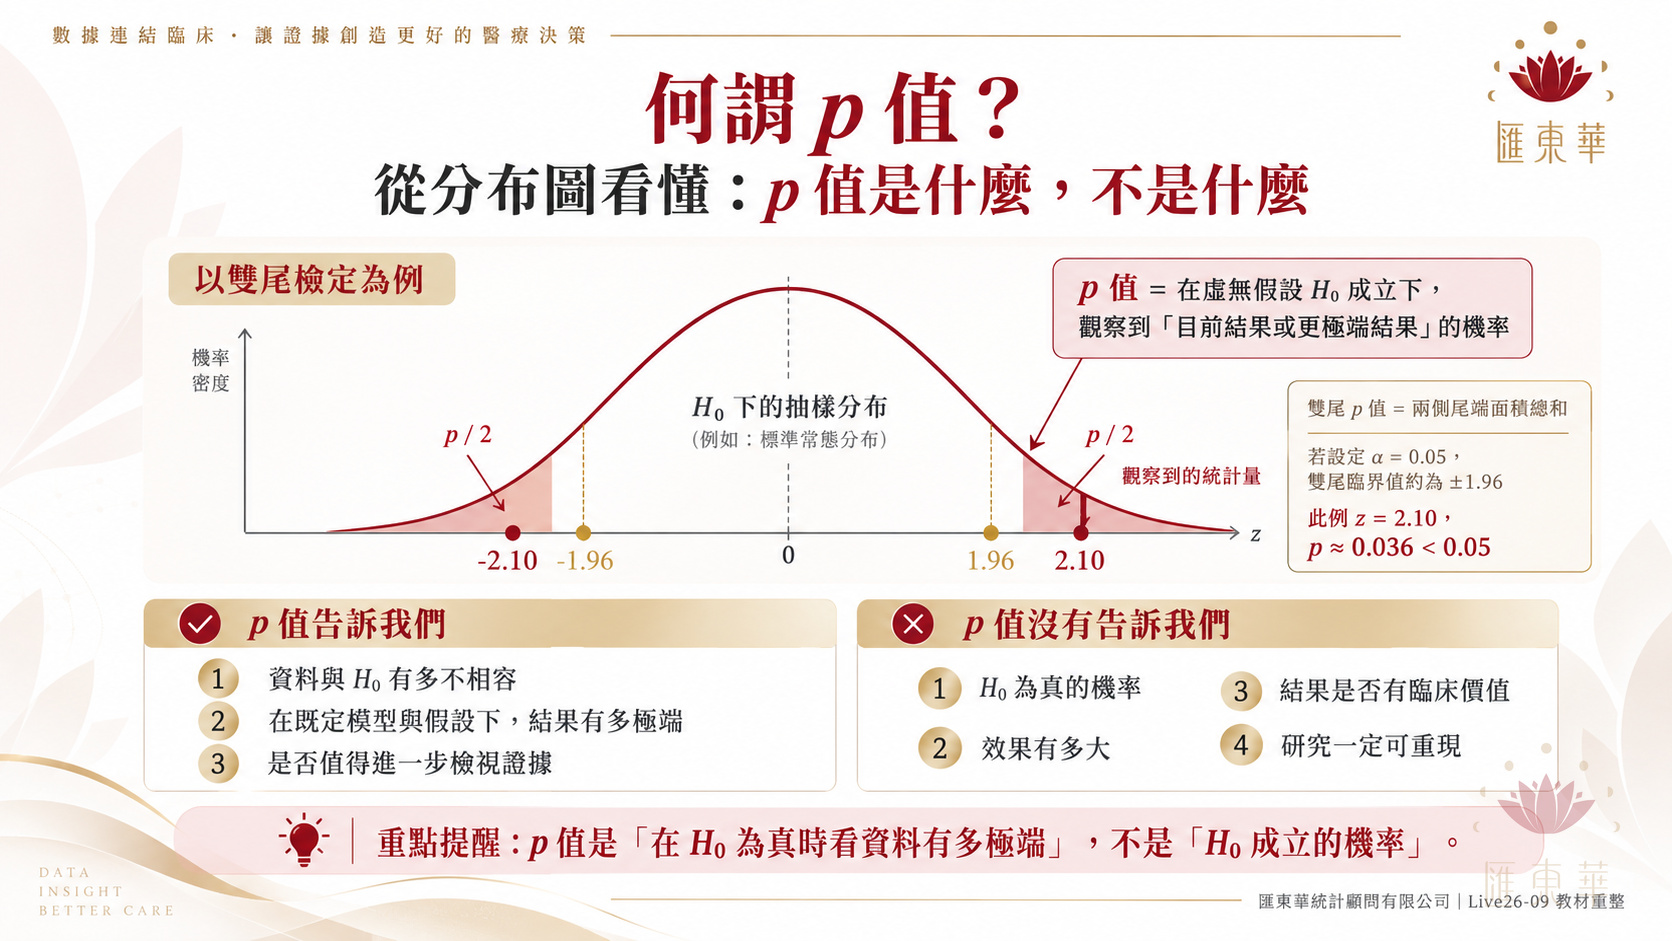
p 值為機率值,回答的是一個很窄的問題:在虛無假設與模型假設都成立的前提下,看到現在這筆資料(或更極端的資料)的機率有多不尋常。它沒有回答「差多少」,也沒有回答「這個差距值不值得改變做法」。
要回答實務意義,需要三個數字一起出現:
效果量(差多少)、信賴區間(這個「差多少」的不確定範圍有多寬)、最小重要差異(差多少才值得改變做法)。
判讀的動作只有一個:把區間的兩端,分別跟最小重要差異比一次。
本文說明三者各自的用法、如何一起判讀、在論文裡分別該寫成什麼句子,文末附一頁對照表與一張送審前的改寫對照表。
01|p 值回答的是哪一個問題
美國統計學會(American Statistical Association, ASA)在 2016 年發布一份罕見的正式聲明,專門說明 p 值該怎麼用、不該怎麼用。其對 p 值定義如下:
「非正式地說,p 值是在一個特定的統計模型之下,資料的某個估計值(例如兩個比較組的樣本平均數差)等於或比實際觀察值更極端的機率。」
注意本句話的兩個限定條件:在一個特定的統計模型之下、資料的某個估計值。p 值談的自始至終是「資料」與「模型」之間的關係。
同一份聲明的六項原則中,第五項直接回答了本文的標題:
「p 值,或統計顯著性,並不衡量效果的大小,也不衡量結果的重要性。統計顯著性不等於科學上、人類意義上或經濟上的顯著性。較小的 p 值不必然代表存在較大或較重要的效應,較大的 p 值也不代表缺乏重要性、甚至不代表缺乏效應。任何效應,無論多麼微小,只要樣本數夠大或測量夠精準,都能產生小的 p 值;而大的效應,若樣本數小或測量不精準,也可能產生不起眼的 p 值。」
(點擊圖片可開啟原圖放大檢視)
p 值的大小同時受效果大小、樣本數與測量精準度三者影響,因此單看 p 值無法反推其中任何一項。 一個微不足道的差距,在幾千人的世代研究裡可以輕鬆跑出 p < 0.001;一個足以改變治療決策的差距,在三十個人的前驅研究裡可能落在 p = 0.09。
2026 年發表在《Journal of Evaluation in Clinical Practice》的一篇批判性回顧,將 2015 至 2025 年間討論 p 值判讀之回顧、社論、指引與方法學論文進行檢索,再用引文追蹤補入 2015 年以前的經典文獻,最後納入 46 篇。其中 38 篇(82.6%)明確批評單獨或二分式使用 p 值;另外 8 篇立場較折衷,主張 p 值仍有補充價值,但必須搭配信賴區間、效果量或貝氏方法一起解讀。納入的 46 篇當中,沒有任何一篇主張 p 值可以單獨作為科學決策的判準。
該回顧另外指出一件對判讀很關鍵的事:p 值本身是不穩定的。在條件完全相同的重複實驗裡,單憑抽樣變異,結果就可能從 p < 0.001 擺盪到 p > 0.20,底層的效果與研究設計完全沒變。把研究結論綁在一個會這樣擺盪的數字跨不跨過 0.05,本身就是一個脆弱的做法。
那麼,該報什麼?
02|效果量:把「有沒有差」換成「差多少」
該回顧最核心的一項建議,是把研究問題本身重新提一次:
改成問:A 和 B 差多少?
前一個問題只能得到「有」或「沒有」,後一個問題得到的是一個帶單位的答案,而帶單位的答案才能直接跟臨床經驗對照。
效果量就是這個帶單位的答案。 依結果變數的型態,常用的有:
| 結果變數型態 | 常用效果量 |
|---|---|
| 連續變數(檢驗值、量表分數、距離、時間) | 平均差(mean difference)、標準化平均差(如 Cohen's d) |
| 二分類結果(發生/未發生) | 絕對風險差(absolute risk reduction)、相對風險(relative risk)、勝算比(odds ratio)、需治療人數(NNT) |
| 多組比較的變異數分析 | 廣義 eta 平方(generalized eta-squared) |
(表格較寬,手機可左右滑動檢視)
一個實用原則:能用原始單位就用原始單位。 該回顧整理的文獻中,有作者明確建議優先報告未標準化的效果量。理由很直接:「平均多走 32 公尺」為臨床人員可以直接判斷的數值,而「d = 0.41」不是,讀者還得知道標準差才換得回去。標準化指標的用途在於跨研究比較與統合分析,該用的時候用,但不該取代原始單位。
論文裡怎麼寫:結果段的每一個主要結果,都要有一個帶單位的效果量,而非僅有一個 p 值。
03|信賴區間:一次給你方向、幅度與精確度
效果量是一個點估計,為從目前手上樣本觀察值計算所得,當換另一組樣本時,可能得到另一個數值不同之點估計。信賴區間標示的就是這份不確定有多大:與這份資料相容的效果值,大致落在哪一段範圍。
該篇回顧將信賴區間指出功能有三:它同時傳達方向(往哪一邊差)、幅度(差多少)與精確度(估計有多穩)。 p 值無法做到任何一項。
此有一個常見的用法需要調整。拿到 95% 信賴區間之後,若只看「它有沒有跨過 0(或跨過 1)」,與看 p 值有沒有小於 0.05 幾乎完全一樣。等於把區間能提供之資訊又壓回成一個二分判斷,區間所能提供更豐富的訊息又被刪除。
該回顧引述的多位方法學作者主張,信賴區間應該依臨床相關性來讀,而非只看它含不含虛無值。有一派做法更進一步,建議把「信賴區間」改名為「相容區間」(compatibility interval),因其真實意涵為:在本模型與這些假設下,區間內的每一個值,都與你手上的資料能夠相容。 目的在於提醒讀者,區間的兩端不是門檻,而是一段連續的可能範圍。
報告效果估計值與信賴區間並非一個新主張或前衛立場,早已行之有年。兩份最通行的報告指引早已將其列入:
- CONSORT 2010(臨床試驗)第 17a 條要求:每一個主要與次要結果,均要報告各組結果以及「估計的效果量及其精確度(例如 95% 信賴區間)」。
- STROBE(觀察性研究)第 16(a) 條要求:報告未校正的估計值,以及(若適用)校正干擾因子後的估計值,並附上「它們的精確度(例如 95% 信賴區間)」。
換句話說,若你的目標期刊要求遵循這兩份指引之一,效果量與信賴區間就是投稿的必要欄位,而非加分項。
論文裡怎麼寫:每一個效果量後面,緊跟著它的區間在同一個括號裡。
04|最小重要差異:預先指定值,分析結果再與其比較
效果量與信賴區間為實際由觀察資料計算而得。最小重要差異(MCID)不是,為預先指定之外部效標。
最小重要差異(minimal clinically important difference, MCID;不同領域也稱 minimal important difference, MID)要回答的問題為:此結果變數至少要差多少,才值得實務上改變做法?
本門檻有三個來源:
- 既有文獻:先用你的結果變數名稱加上
minimal important difference這組關鍵字檢索一次,看看你的領域是否已有估算過的門檻值。 - 使用者或病人調查:直接問受試者「改善到什麼程度,你會覺得有差」。
- 專家或團隊事先共識:在沒有現成文獻時,由研究團隊事先定義,並在方法段說明依據。
三類均可,但有一個時間點的要求:門檻必須在看到結果之前決定。 該回顧整理的文獻中,有作者明確建議事先(a priori)設定臨床上相關的差異。若是看到結果後才決定多大算重要,則門檻就變成配合結果的裝飾。
需要提醒的是,最小重要差異本身非常數值,具備不確定性。同一個量表,不同研究、不同族群、不同估計方法,可能給出不一樣的門檻值。因此,指定的MCID值必須說清楚理由與來源。 讀者要看得到你採用的是哪一個值、出自哪裡,才有辦法判斷你的結論。
論文裡怎麼寫:在方法段寫明「本研究採用 ___ 作為 ___ 的最小重要差異,依據為 ___」,在討論段把結果跟它對照進行討論。
05|三個一起看:把區間的兩端各對一次門檻
三個數字分開講完,真正的判讀要放在一起看。
以下為一個說明用的假設情境,數字是為教學所設計,非任何一項研究的結果。
情境:比較兩種復健方案對六分鐘行走距離的效果。研究團隊在收案前,依文獻把最小重要差異定為 30 公尺。
| 結果 | 怎麼讀 |
|---|---|
| 平均多 45 公尺(95% CI:32 至 58 公尺) | 區間整段都在 30 公尺以上。與資料相容的所有可能值,都達到事先認定的重要程度。可下結論。 |
| 平均多 45 公尺(95% CI:5 至 85 公尺) | 點估計很高,但區間橫跨 30 公尺這條線。同一份資料同時相容於「明顯值得採用」與「幅度不足以改變做法」。點估計好看,不足以據此下決定。 |
| 平均多 8 公尺(95% CI:−4 至 20 公尺) | 區間整段落在正負 30 公尺之內。這是一種可以下結論的「沒有差別」:即使真的存在效果,幅度也小到不足以改變做法。 |
| 平均多 8 公尺(95% CI:−40 至 56 公尺) | 區間兩端都越過門檻,一端指向明顯有益、另一端指向明顯有害。這份資料分辨不出來,不能寫成「兩組相當」。 |
(表格較寬,手機可左右滑動檢視)
注意第三列與第四列:點估計同樣是 8 公尺,一個可以下結論、一個不行,差別完全在區間的寬度。若只看 p 值,此兩種情況均會顯示為「不顯著」,看起來一模一樣。
由此,帶出一句實務上最容易寫錯的話:
「未觀察到顯著差異」不等於「兩組沒有差異」。
前者是關於這份資料的描述,後者是關於真實世界的宣稱。要從前者走到後者,需要的是「區間整段都落在最小重要差異之內」這個額外條件,而不是一個大於 0.05 的 p 值。
(點擊圖片可開啟原圖放大檢視)
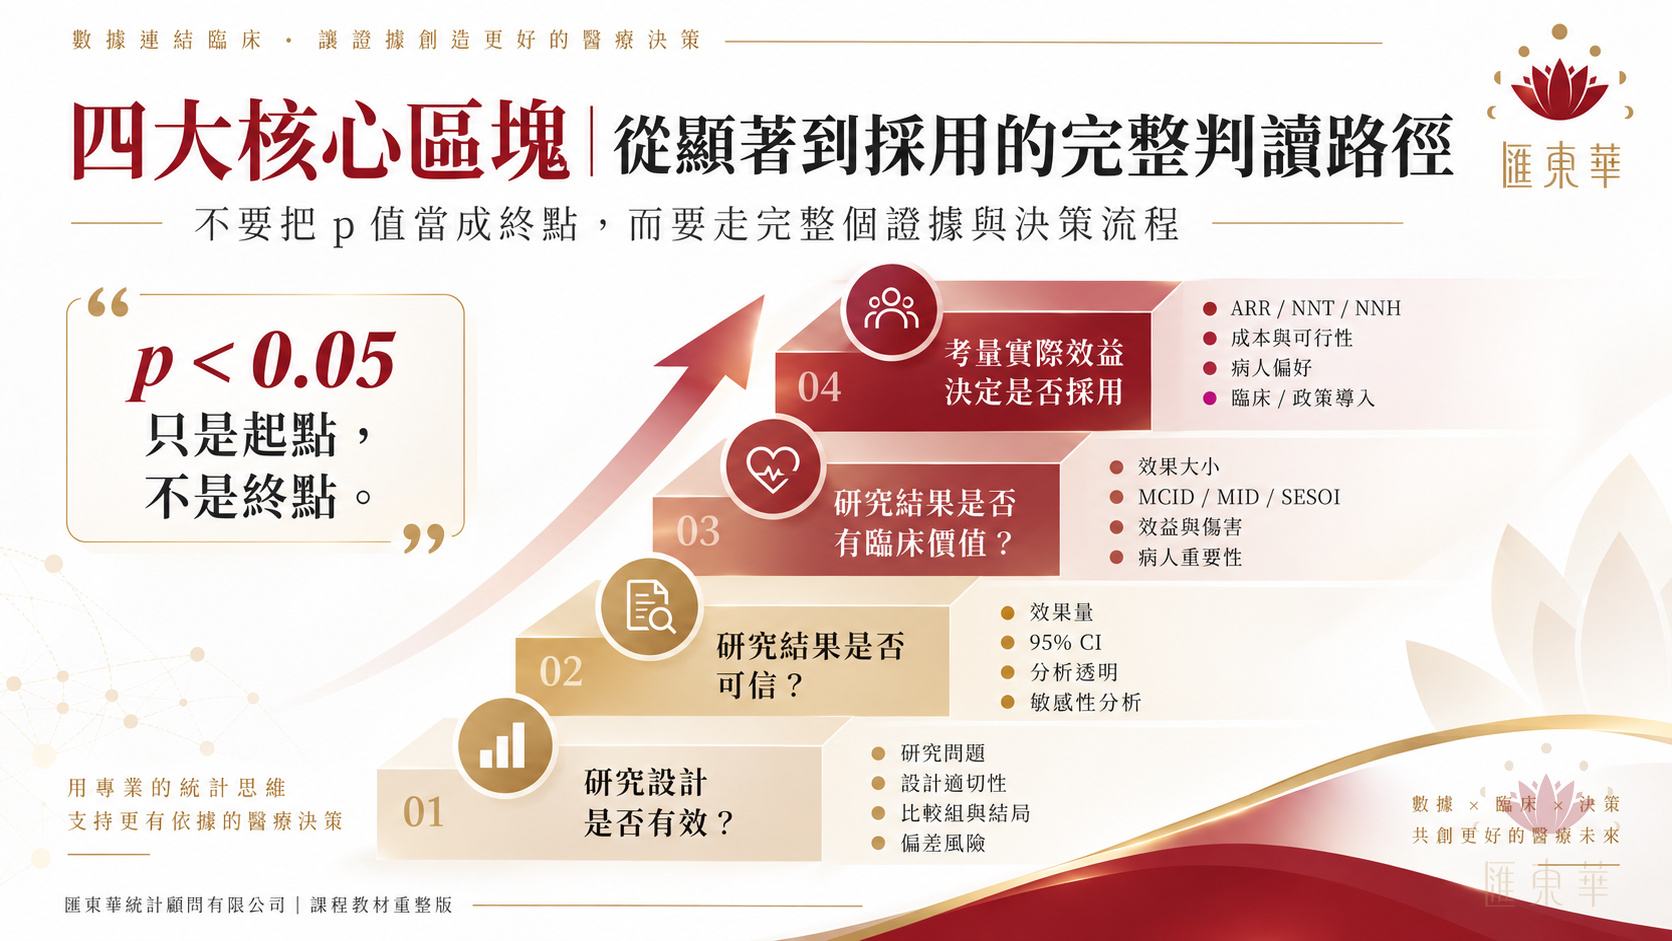
再往上一層:統計結果成立,與值得採用,還是兩件事。 一個效果明確、區間也夠窄的介入,接下來還要經過成本、可行性、病人偏好與傷害這幾關。效果量與區間讓你走到第三關,不是走到終點。
06|一頁對照表:三個數字怎麼報
除了 p 值還該報什麼:效果量、信賴區間、最小重要差異一覽
| 效果量 | 信賴區間 | 最小重要差異 | |
|---|---|---|---|
| 定義 | 兩組實際差了多少,用結果變數本來的單位或比值表示 | 與這份資料相容的可能值,從哪裡到哪裡 | 差多少才值得改變做法 |
| 回答的問題 | 差多少? | 這個「差多少」有多不確定? | 這個差距重要嗎? |
| 數字從哪來 | 你自己的資料 | 你自己的資料 | 資料以外:既有文獻、病人或使用者調查、團隊事先共識 |
| 什麼時候決定 | 分析時 | 分析時 | 研究設計階段,看到結果之前 |
| 寫成什麼樣子 | 「介入組平均多 32 公尺」 | 「多 32 公尺(95% CI:11 至 53 公尺)」 | 「本研究採用 ___ 作為 ___ 的最小重要差異,依據為 ___」 |
| 放在論文哪裡 | 結果段,每一個主要結果都要有 | 緊跟在每一個效果量後面,同一個括號 | 方法段(事先定義)+討論段(與結果對照) |
| 容易踩到的地方 | 只報標準化指標(如 Cohen's d),讀者換不回臨床單位 | 只看區間跨不跨過 0 或 1,等於把它變回一個 p 值 | 看到結果之後才決定門檻 |
(表格較寬,手機可左右滑動檢視)
三者的關係可以用一句話記住:效果量給你答案,信賴區間告訴你這個答案有多可靠,最小重要差異告訴你這個答案夠不夠格改變你的做法。
07|送審前,把這幾句話換掉
以下五組是統計結果段常見的寫法,右欄是建議的替代寫法。數字仍為說明用的假設情境。
| 常見寫法 | 建議改成 | 為什麼 |
|---|---|---|
| 兩組有顯著差異(p = 0.03) | 介入組平均多 32 公尺(95% CI:11 至 53 公尺);事先設定的最小重要差異為 30 公尺 | p 值不衡量效應大小或結果的重要性 |
| 兩組無顯著差異,因此兩種做法效果相當 | 本研究未觀察到兩組差異(平均差 10 公尺,95% CI:−14 至 34 公尺);區間上界已超過事先設定的 30 公尺,仍相容於具實務意義的差距,尚不足以判定兩者相當 | 「不顯著」不等於「沒有效果」 |
| 兩組差異有趨向顯著的情形(p = 0.07) | 直接報效果量與區間,不使用「趨向顯著」這個說法 | 該回顧整理的文獻中,多篇明確建議避免此用語 |
| 本研究結果具高度顯著性(p < 0.001) | 保留精確的 p 值,並把結論建立在效果量與區間上 | p 值小代表資料與虛無假設很不相容,不代表效果大 |
| 結果在統計上顯著/不顯著 | 報出精確 p 值,改以「與資料相容的效果範圍為⋯」描述結果 | 該回顧中最常出現的建議之一,就是不再使用「統計上顯著」這個標籤 |
(表格較寬,手機可左右滑動檢視)
這五句是我們在協助客戶回覆審稿意見時最常遇到的措辭。把它們換成右欄的寫法,改的只是呈現方式;效果量與信賴區間本來就在同一份模型輸出裡,不需要重跑分析。唯一的例外是前兩列用到的最小重要差異:那必須在看到結果之前就先訂好,事後補上不算數(呼應上方「容易踩到的地方」那一列)。
如果你想把結果段與統計呈現的常見問題一次看完,我們有一門專門處理這件事的課程: StatErrors 論文統計分析與報告常見錯誤
結語|p 值是起點,不是終點
回到標題的問題:p < 0.05 表示有實務意義嗎?
答案是:這個問題 p 值答不了,它答的是另一題。 p 值告訴你的是資料與虛無假設有多不相容;效果量告訴你差多少;信賴區間告訴你這個「差多少」有多不確定;最小重要差異告訴你差多少才值得改變做法。
四個數字各司其職,缺了後面三個,第一個就沒有落腳的地方。
做法上的改變其實很小:在每一個你原本只寫 p 值的位置,多寫一個帶單位的效果量和一組區間;在方法段多一句話,說明你事先認定多少算重要。 分析不用重跑,樣本不用重收,改的是呈現與判讀。
p 值告訴你資料有多不尋常,效果量、區間與最小重要差異才告訴你該不該改變做法。
參考文獻
- Wasserstein, Ronald L., and Nicole A. Lazar. "The ASA Statement on p-Values: Context, Process, and Purpose." The American Statistician, vol. 70, no. 2, 2016, pp. 129–133. DOI: 10.1080/00031305.2016.1154108
- Ferreira, Matheus Hissa Lourenço, Lucas Caseri Câmara, and Nelson Carvas Junior. "Beyond the p Value Dichotomy: Alternatives for Statistical Inference—A Critical Review." Journal of Evaluation in Clinical Practice, vol. 32, no. 1, 2026, e70373. DOI: 10.1111/jep.70373
- Schulz, Kenneth F., Douglas G. Altman, and David Moher, for the CONSORT Group. "CONSORT 2010 Statement: Updated Guidelines for Reporting Parallel Group Randomised Trials." BMJ, vol. 340, 2010, c332. DOI: 10.1136/bmj.c332
- von Elm, Erik, Douglas G. Altman, Matthias Egger, Stuart J. Pocock, Peter C. Gøtzsche, and Jan P. Vandenbroucke, for the STROBE Initiative. "The Strengthening the Reporting of Observational Studies in Epidemiology (STROBE) Statement: Guidelines for Reporting Observational Studies." BMJ, vol. 335, no. 7624, 2007, pp. 806–808. DOI: 10.1136/bmj.39335.541782.AD
AI 使用聲明
本文由匯東華統計顧問有限公司 陳秀敏 博士撰稿,Claude Opus 5 協助原文檢索、引用核對與版面排版,最終內容已由作者審閱定稿。文中引述之聲明原則、指引條目與回顧結果,資料來源為上列四篇文獻,均取自原文並逐項核對;判讀示範所使用的數字為說明用的假設情境,非任何研究之實測結果。日期:2026 年 9 月 18 日。
同期其他單元
- 臨床預測模型系列 No. 02|預測模型的 ROC 曲線、校準圖與決策曲線:介紹與判讀
- 研究誠信與 AI 治理系列 No. 04|醫院導入生成式 AI:五項治理重點
- 統計方法實務|SPSS 常態性檢定怎麼做?
匯東華電子報 第 5 期|2026.09.18|看本期網頁版 →
聯絡我們
- LINE:@medatatw
- Email:info@medatatw.com
- 電話:07-9721586
- 官網:www.medatatw.com

統計分析
服務價目表 (未含5%營業稅)
透過嚴謹的數據整理,提供有價值的資訊,形塑知識,提高決策品質。包括信達雅三執行原則。
信:確保資料品質可信賴
達:確保統計方法適切性
雅:確保圖文表格正規化
協助代執行統計分析與進一步加值服務。
在匯東華與夥伴的專業背景知識配合下,能有效地處理面對的問題。
統計分析成果

數據串接與清洗
數據是礦藏,數據清洗是挖出鑽石的第一步,尤其是巨量知識。數據清洗或串接執行過程需要細心與專注,且有可能會消耗許多時間和精力,就由我們來替各位處理掉這個大麻煩。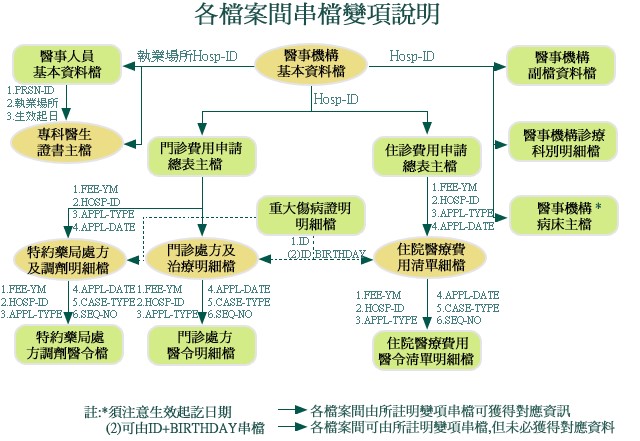
全民健保研究資料庫、國外大型資料庫資料非常齊全,種類多,需要串接與清洗,進行正規化後才能更進一步進行資料探勘與統計分析。
Fig1.同一個Project資料散落在不同tables,無法使用
Fig2.整併與清理為可分析的table
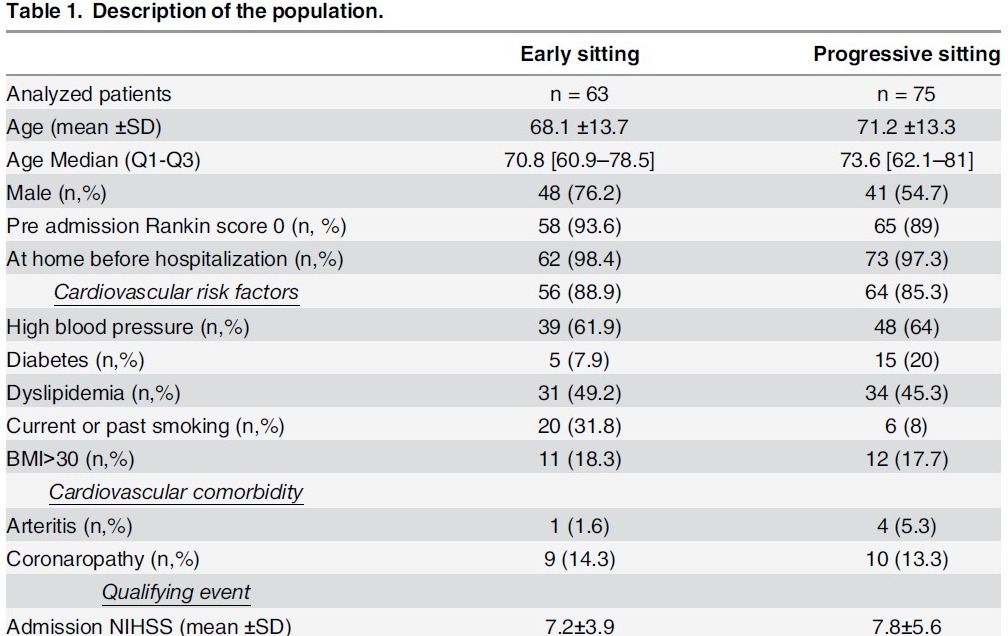
Fig.3整理和分析後形成有意義的知識
概念與流程示意圖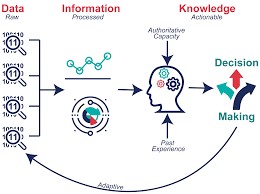

計畫撰寫與統計諮詢
為了讓匯東華的顧客與學員有更好的合作和消費體驗,故匯東華特別依據營業項目開發周邊產品,提供使用、購買。目前已有針對公共衛生師的題庫以及模擬試題,未來將針對醫學研究領域發展產品。