 匯東華統計顧問有限公司
先抓住三個重點
新模型使用更多預測變數,是否就值得改用?例如,原本只用病理分期,現在再加入年齡、腫瘤大小等資訊。對醫護人員而言,主要關注點為它能否找出高風險病人、算出的風險是否可信,以及用來決定臨床處置時,是否能帶來更多好處。而這三個問題,可使用下列三張圖來回答。
| 看哪張圖 | 想知道什麼 | 讀圖時記住 |
|---|---|---|
| ROC 曲線 | 哪個模型比較能分辨高低風險 | AUC(ROC 曲線下面積)較高,不代表預測機率較準 |
| 決策曲線 | 依模型決定處置,是否更有幫助 | 在臨床會採用的風險門檻內比較 |
| 校準圖 | 模型算出的風險,是否接近實際結果 | 例如預測 20%,實際是否也約 20% |
(表格較寬,手機可左右滑動檢視)
本文先用模擬資料,說明如何判讀 ROC 曲線、決策曲線與校準圖,再以胃癌術後的公開資料案例,示範如何比較兩個模型的表現。
比較前先說清楚用途
假設模型要協助我們決定是否安排較密集的追蹤。讀圖前,先想清楚:風險達到多少時,會考慮加強追蹤?讀圖時,就應著重這個風險門檻附近的表現,而不是只挑曲線差距最大的地方。
本文以 10% 至 30% 的風險門檻範圍,示範如何比較決策曲線,這是教學假設,不是臨床建議。也要確認兩個模型是否在同一批、未用來建立模型的病人資料上評估,才較容易公平比較。
閱讀用語
「事件」指研究要預測的結果,例如死亡、復發或再住院;「預測變數」指用來預測結果的項目,例如年齡或病理分期,圖中也稱為「變項」。藍色代表模型 A,紅色代表模型 B;在 ROC 曲線與決策曲線中,A 為虛線、B 為實線。兩個例子的 A、B 設定不同,讀到胃癌案例時會再提醒。
01 ROC 曲線看誰比較能分辨高低風險
先看模擬例子:模型 A 使用原有的預測變數;模型 B 再加入一項新標記。模擬時,模型 A 在與評估資料同類、但不同一批人的族群建立,模型 B 則刻意在事件比例較高的族群建立,用來示範後面的校準問題。兩個模型都用同一批 2,000 人評估,其中 329 人發生事件。這批人未用來建立這兩個模型。
本圖重點:加入新標記的模型 B,較能把之後會發生事件的人排在高風險的位置。
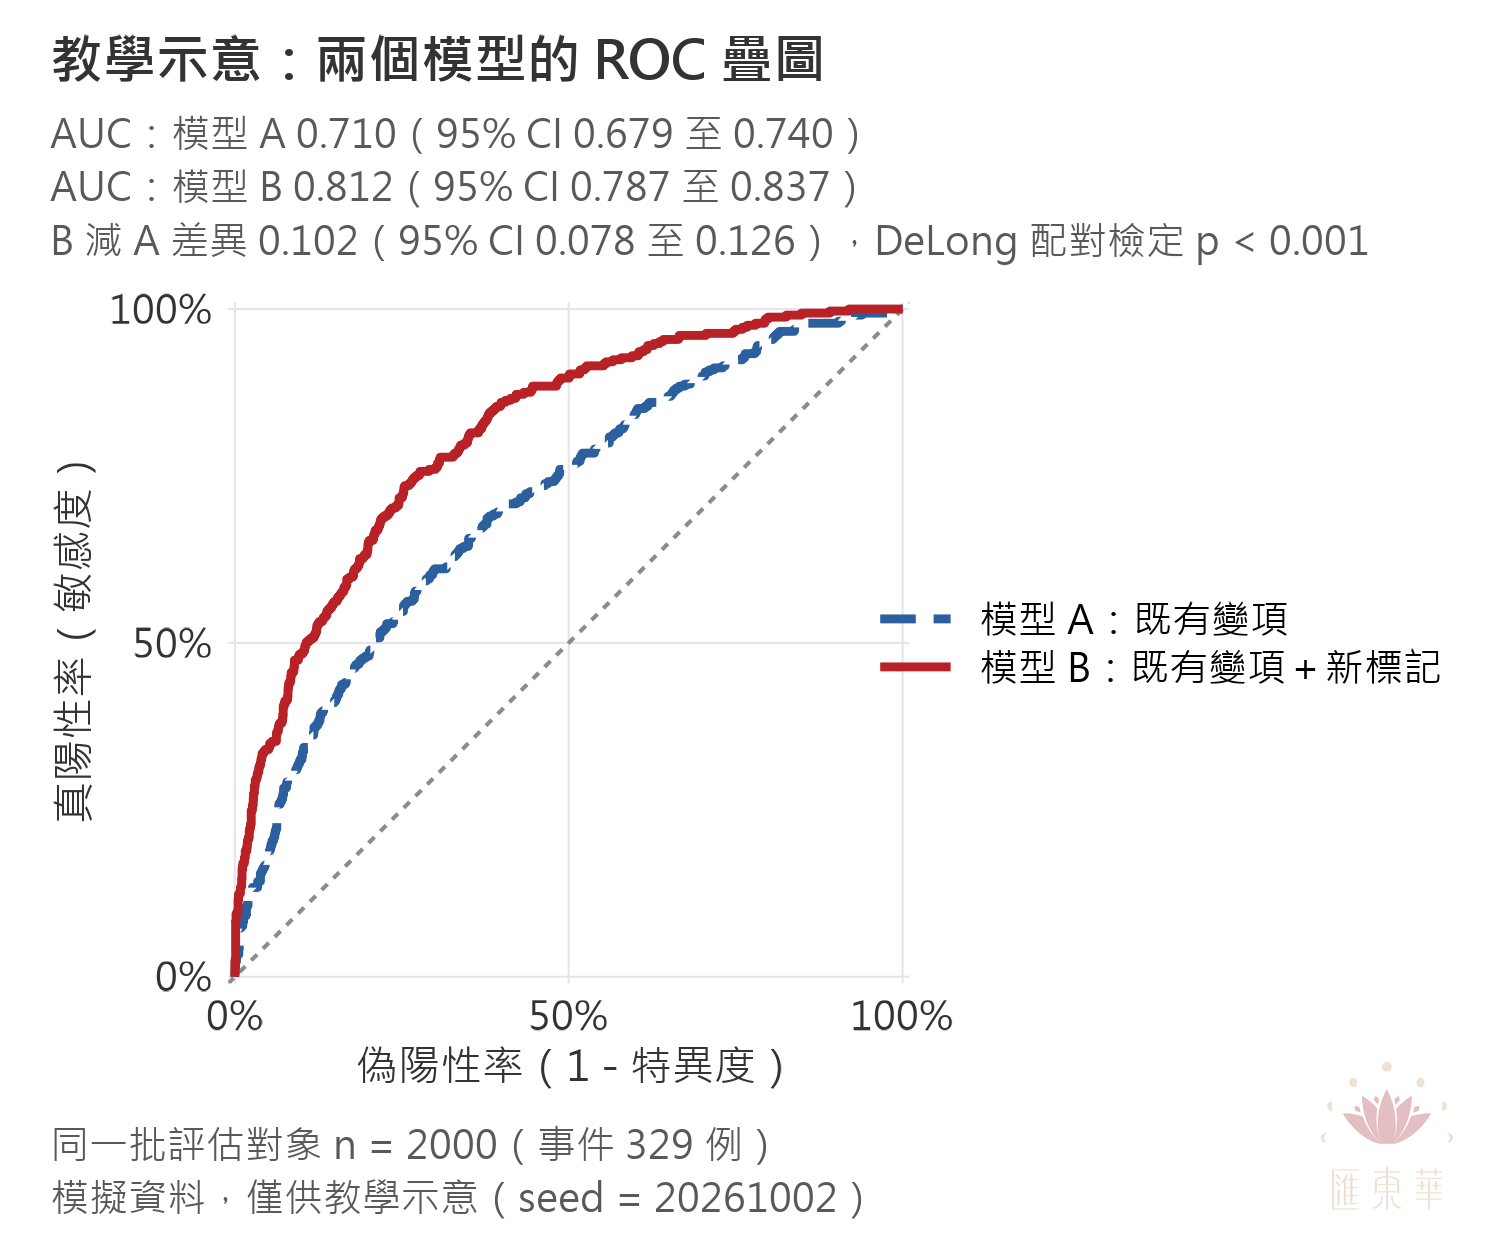
圖 1 模擬資料的 ROC 曲線。模型 B 為紅色實線,模型 A 為藍色虛線。
(點擊圖片可開啟原圖放大檢視)
怎麼讀這張圖
先看座標:橫軸是在「沒有發生事件的人」當中,被判為高風險的比例,稱為偽陽性率;縱軸是在「有發生事件的人」當中,被找出來的比例,稱為敏感度。比較同一個橫軸位置時,曲線越高,代表找出的事件者越多。圖中灰色對角虛線代表完全靠猜的模型,曲線離它越遠越好。
再看 AUC(ROC 曲線下面積)。本例模型 B 為 0.812,模型 A 為 0.710,表示 B 的整體區辨能力較好。兩者差異為 0.102,95% 信賴區間為 0.078 至 0.126,未包含 0,也支持這項差異。[1]
AUC 反映模型分辨高低風險的能力,不能讀成「預測正確的百分比」。若曲線交叉,要留意在不同位置可能各有優勢。即使 AUC 較高,也還不能判定哪個模型的風險機率較準,或哪個更有助於臨床處置。
02 決策曲線看依模型決定處置是否有幫助
本圖重點:在本文假設的 10% 至 30% 風險門檻內,依模型 B 決定處置,整體得失比模型 A 好(下文說明這叫淨效益);但改善是否值得換模型,仍要考量差距與使用負擔。
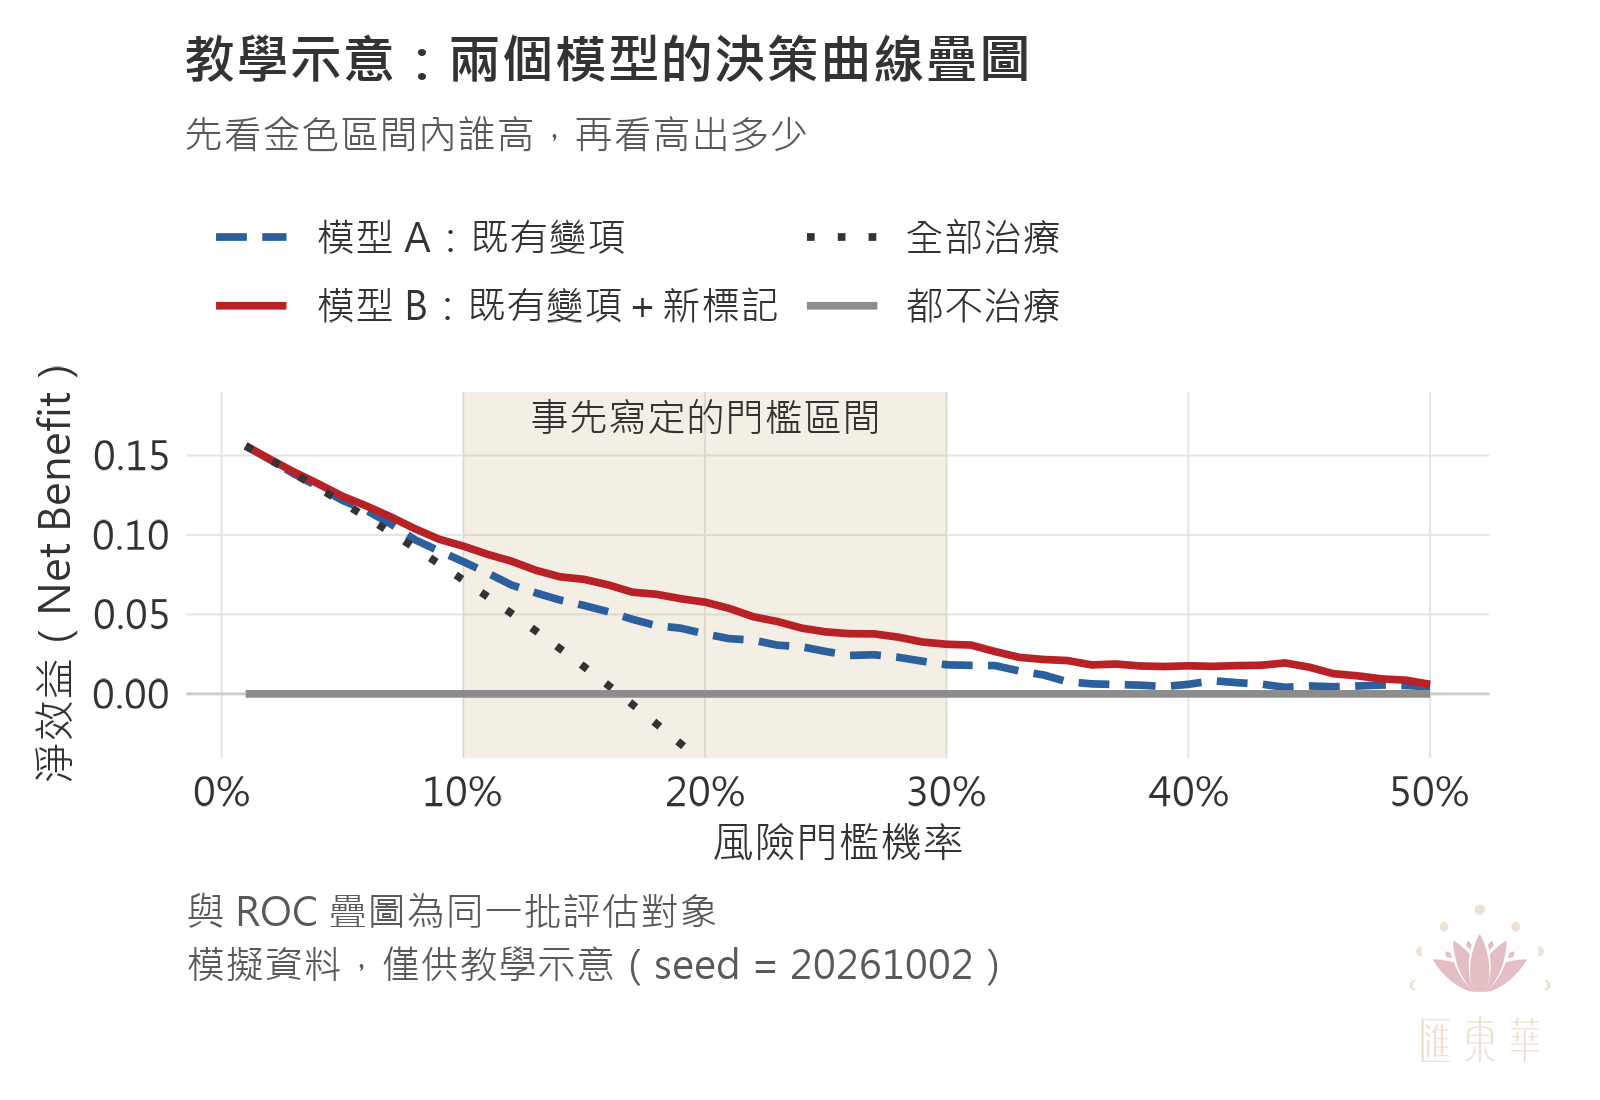
圖 2 模擬資料的決策曲線。金色區域為教學設定的門檻範圍;紅線為模型 B,藍線為模型 A。
(點擊圖片可開啟原圖放大檢視)
先懂風險門檻與淨效益
「風險門檻」就是考慮採取處置的最低風險。例如門檻設為 20%,表示模型預測風險達到 20% 時,就考慮安排該項處置;低於 20% 則不安排該項處置。
「淨效益」把正確選出事件者接受處置的好處,扣掉不必要處置的代價,換算成一個數值。門檻越低,表示越願意接受一些不必要的處置,以減少漏掉事件者的機會。[2]
依序判讀
第一步,只看臨床會採用的門檻範圍,本例為金色區域。第二步,比較模型曲線與兩條參考線:「全部治療」是所有人都接受該項處置;「都不治療」是所有人都不接受。模型曲線高於兩條參考線,表示依模型選擇處置對象的淨效益較高。圖上的「治療」,也可以是檢查或加強追蹤。
第三步,再比較兩個模型。在金色區域內,模型 B 的紅線都高於模型 A 的藍線。以門檻 20% 為例,B 的淨效益約為 0.058,A 約為 0.038,差約 0.020。淨效益 0.058 可以理解為:每 100 人中,相當於正確找出約 5.8 位事件者,而沒有任何不必要的處置。0.020 這個差距已扣除不必要處置的代價,不能直接讀成事件發生率降低 2%,或實際多找到 2% 的病人。
曲線較高,也要看差異有多不確定。以門檻範圍上緣 30% 為例,淨效益差異,其 95% 信賴區間為 −0.001 至 0.027,包含 0;因此仍不能排除兩個模型在這個門檻沒有差異。
03 校準圖看模型算出的風險是否可信
本圖重點:模型 B 雖然較能分辨高低風險,算出的風險卻普遍偏高。這也說明,AUC 較高與風險機率較準,是兩回事。
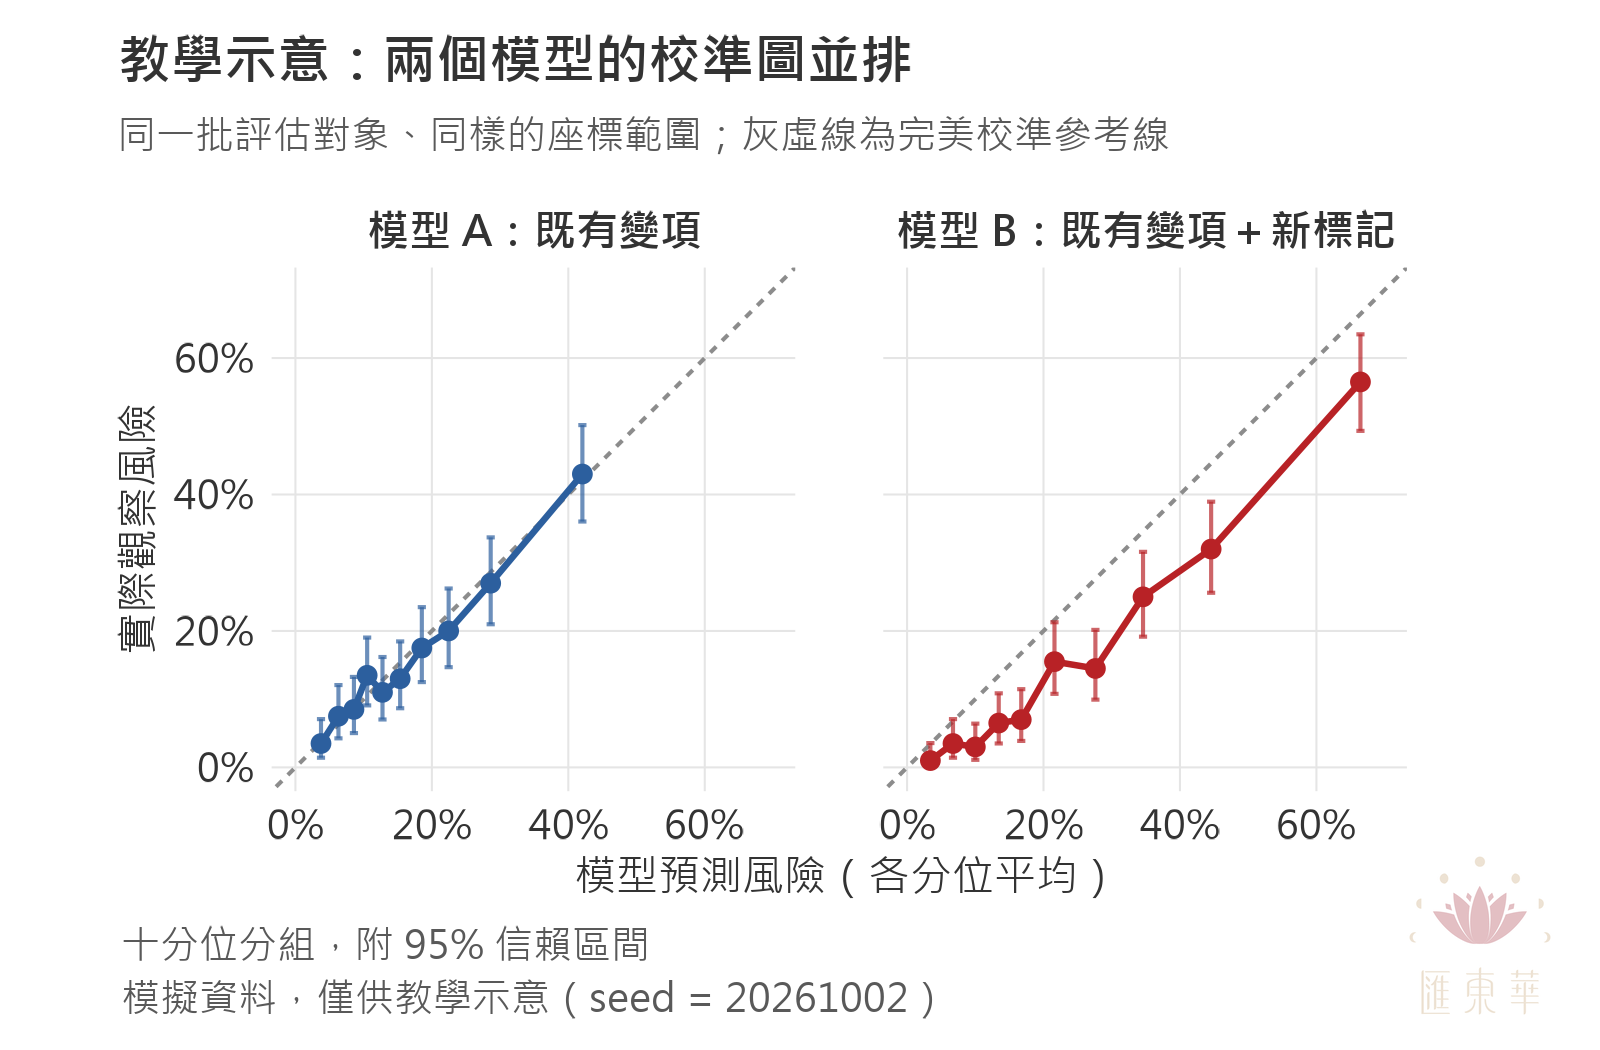
圖 3 模擬資料的校準圖。左圖為模型 A,右圖為模型 B;兩張圖的座標範圍相同。
(點擊圖片可開啟原圖放大檢視)
怎麼讀這張圖
橫軸是模型預測的風險,縱軸是實際發生事件的比例。每個點代表一組預測風險相近的人;灰色斜線表示預測與實際一致。點在斜線下方,表示預測高於實際,模型高估風險;點在斜線上方,則表示模型低估風險。
例如模型說一組病人的風險平均是 20%,而實際約有 20% 發生事件,這組的預測就接近實際。圖中的誤差線是實際比例的 95% 信賴區間,反映這個估計仍有不確定性。
比較時,先看哪個模型的點更接近斜線,再看哪一段偏差較大。模型 A 的點大致貼近斜線;模型 B 的十個點都在斜線下方。例如 B 有一組平均預測 27.6%,實際只有 14.5% 發生事件,顯示風險被高估。
對臨床使用有何影響
這個模擬例子的模型 B,是在事件比例較高的族群建立的,拿到另一個族群使用時出現風險高估。它雖然較能分辨高低風險,預測機率仍須調整並重新評估,才適合用來與病人討論風險。
讀圖時也要看誤差線。誤差線很長,表示估計仍有較大的不確定性;涵蓋斜線,並不等於已證明模型準確。校準圖比較的是一群人的預測與實際比例,也不能保證每位病人的個別機率都正確。[3]
04 胃癌案例評估增加五個預測變數的改善程度
接著看 Eom 等人(2015)的胃癌術後公開資料。本文沿用第 5 期的教學重分析:在一批資料建立模型,再用另外兩家醫院的資料,評估 36 個月內死亡風險。[4]
注意:這次 A、B 的設定與模擬例子不同:模型 A 使用 7 個預測變數,模型 B 只用 pT(原發腫瘤侵犯程度)與 pN(區域淋巴結轉移情形)兩個病理分期變數。以下簡稱「7 變項模型 A」與「2 變項模型 B」(圖中標為「模型 A:7 個變項」與「模型 B:僅 pT+pN」)。在胃癌案例中,紅線是較簡單的 2 變項模型。
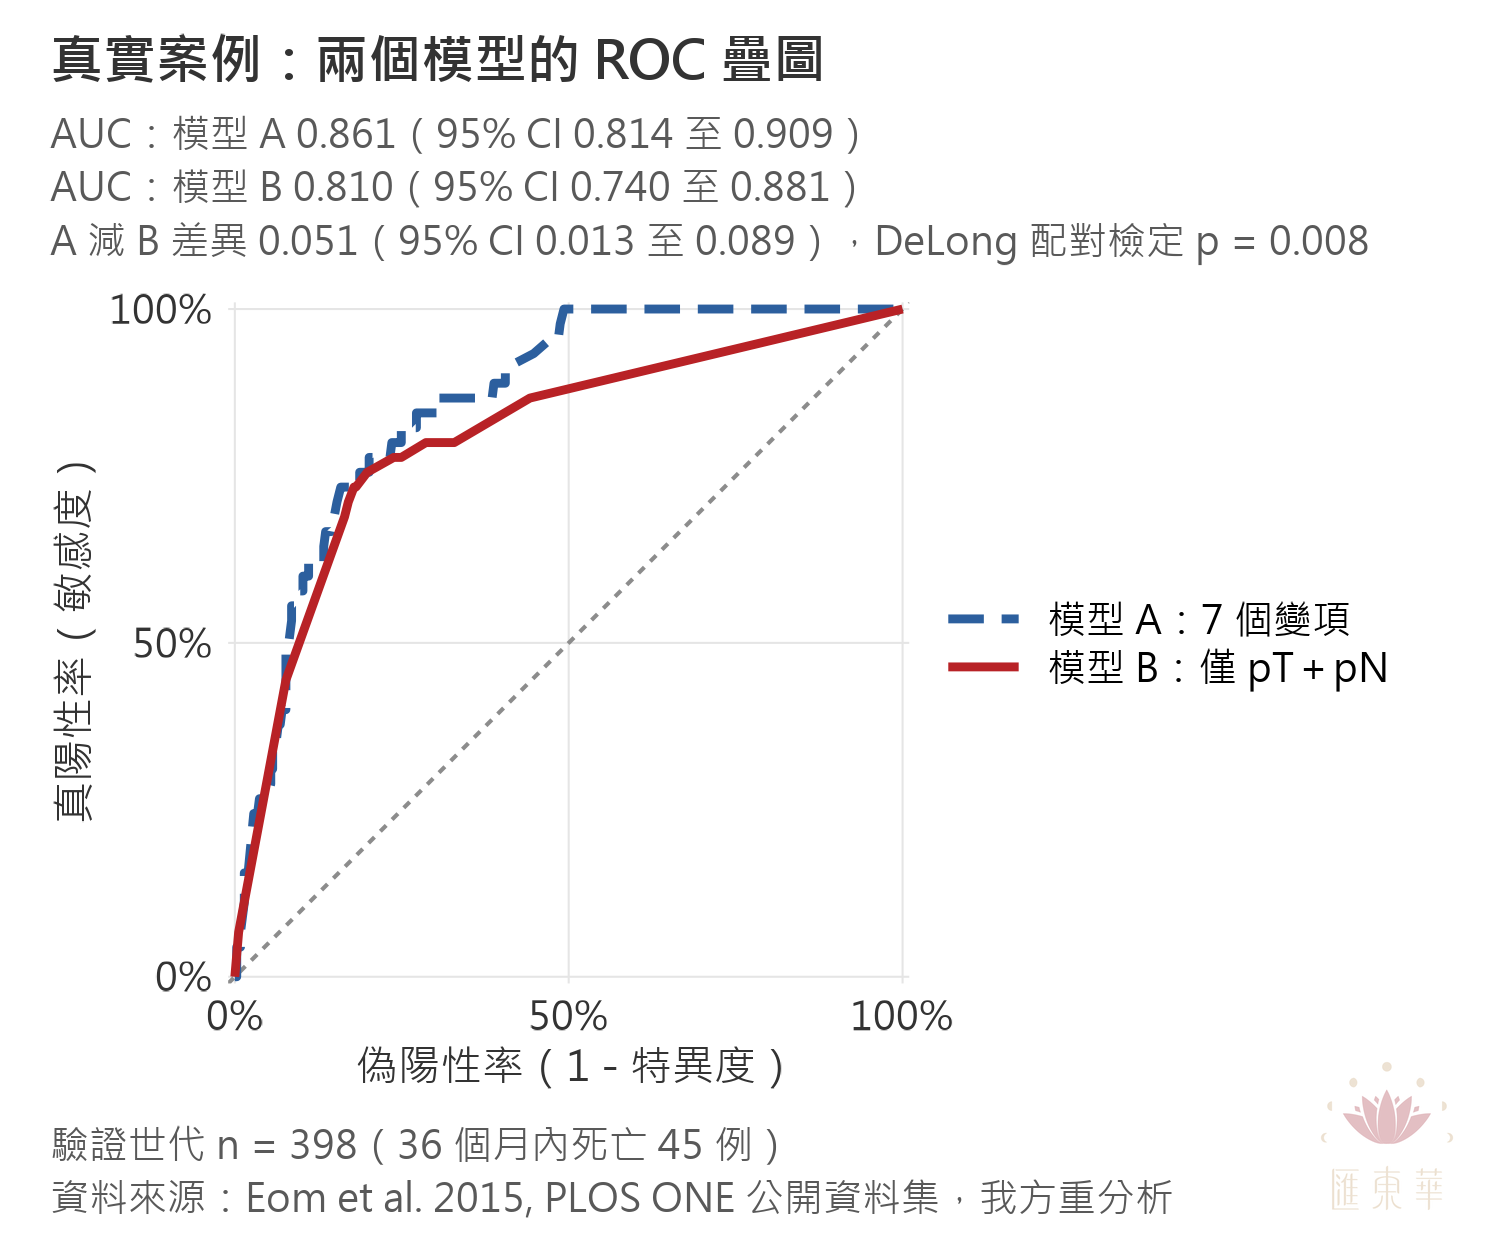
圖 4 胃癌案例的 ROC 曲線。評估資料共 398 人,36 個月內死亡 45 人。資料源自 Eom 等人的公開附件,為本文教學重分析結果。紅線為較簡單的 2 變項模型 B。
(點擊圖片可開啟原圖放大檢視)
本圖重點:7 變項模型 A 的 AUC 為 0.861,2 變項模型 B 為 0.810。差異為 0.051(95% 信賴區間 0.013 至 0.089),支持模型 A 在這批資料上的區辨能力較好。
讀圖時可看到,藍線與紅線在部分區段很接近,差距主要出現在右半段;並非每個位置都差很多。下一步要看,較高的 AUC,能否轉為更好的處置選擇。
案例提醒:本例以 Logistic 迴歸預測 36 個月內死亡,不同於原研究的存活模型。未追蹤滿 36 個月且無法確定結果者已排除。本文僅示範讀圖,不宜直接作為臨床採用模型的依據。
05 胃癌案例的決策曲線差距很小
本圖重點:7 變項模型 A 的 AUC 較高,但在 10% 至 30% 的門檻範圍內,兩個模型的決策曲線大多很接近。
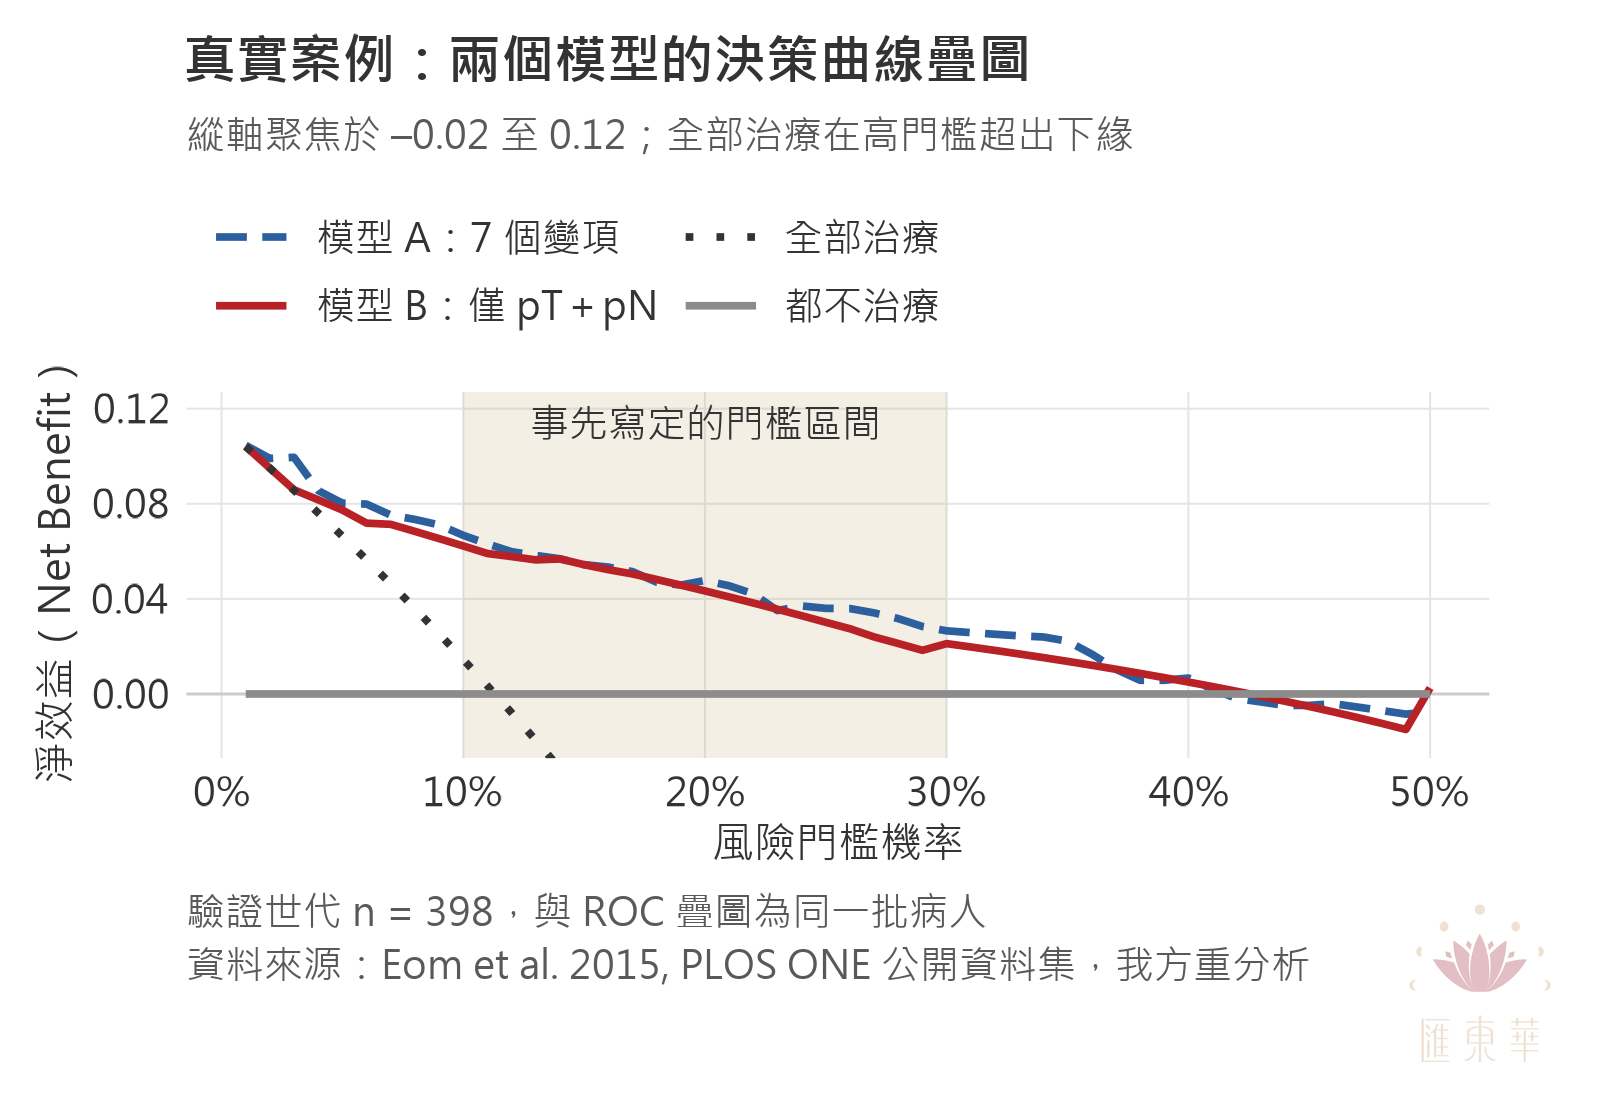
圖 5 胃癌案例的決策曲線。藍線為 7 變項模型 A,紅線為較簡單的 2 變項模型 B;金色區域是教學設定,並非建議採用的追蹤門檻。
(點擊圖片可開啟原圖放大檢視)
怎麼解讀差距
先看金色區域:兩個模型的曲線都高於「全部治療」與「都不治療」。再比較藍線與紅線:兩者大多貼得很近,7 變項模型 A 在約 25% 至 30% 的門檻附近略高。
在金色區域內,差距最大出現在門檻 28%,模型 A 的淨效益比 B 高約 0.010。但差異的 95% 信賴區間為 −0.006 至 0.026,包含 0,因此不能只憑藍線較高,就認定模型 A 確實更有利。
是否值得採用較複雜的模型
這批資料只有 45 人死亡,估計仍不確定。較適當的說法是:「7 變項模型的區辨能力較好,但淨效益的增加很小,目前仍不足以判斷是否值得增加五個預測變數。」
本文以「是否安排較密集的術後追蹤」幫助理解決策曲線;10% 至 30% 是教學設定,並未驗證加強追蹤本身的療效。是否採用模型,仍要依實際用途與使用負擔判斷。
06 胃癌案例尚無法判定誰的風險機率較準
本圖重點:兩個模型的平均預測接近實際死亡比例,但高風險組都有高估的情形。資料仍不足以明確判斷哪個模型的校準較好。
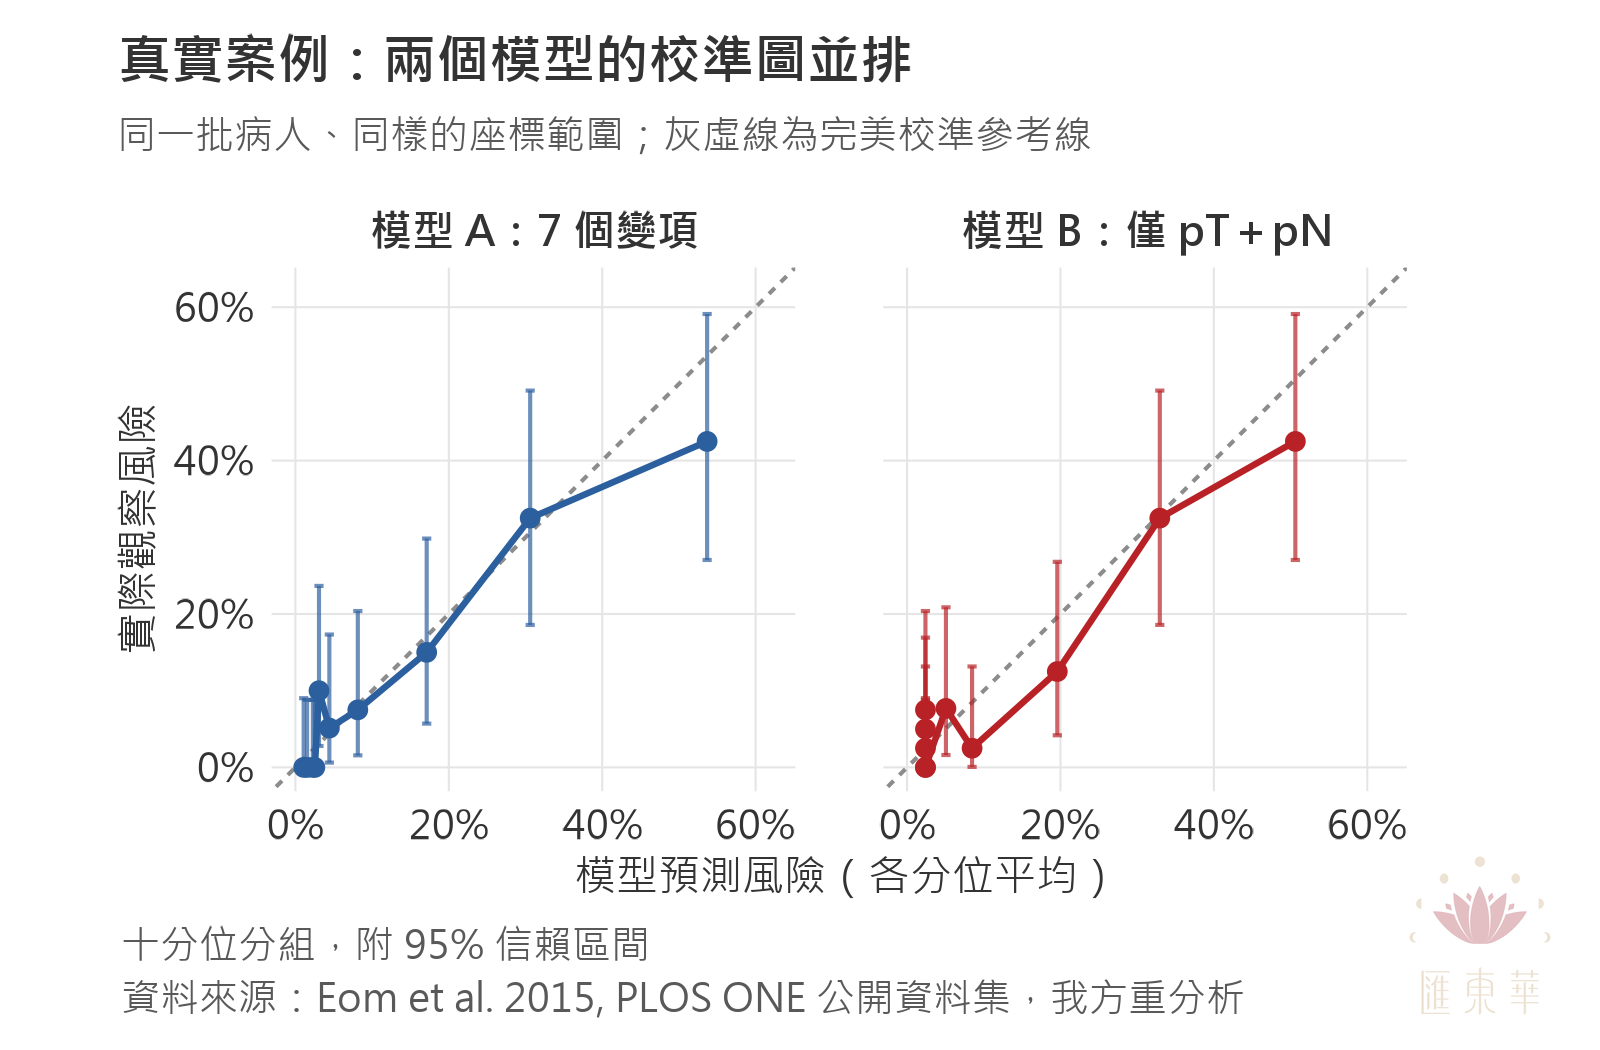
圖 6 胃癌案例的校準圖。左圖為 7 變項模型 A,右圖為較簡單的 2 變項模型 B。高風險組的誤差線較長,估計不確定性較大。
(點擊圖片可開啟原圖放大檢視)
先看預測與實際相差多少
先看兩個模型的點離斜線多遠。高風險的最後一組,模型 A 平均預測 53.7%,模型 B 預測 50.6%,實際死亡比例為 42.5%,兩者都有高估。不過,這組只有 40 人,95% 信賴區間為 27.0% 至 59.1%,估計範圍很寬。
兩個模型各十組的誤差線都涵蓋灰色斜線。結果尚不足以明確判定誰較準,不能因此推論兩個模型已被證明一樣準確。
右圖為何有好幾個點疊在一起
2 變項模型 B 有 203 人的預測值都等於 2.4%。因為模型 B 只用兩個分期變數,pT、pN 相同的人預測值必然相同。為了分成十組,同分者被分到不同組,所以右圖左下角有 5 組落在同一個橫軸位置;其中兩組實際比例都是 0%,重疊成一點,圖上看起來是 4 個點。這幾組的實際比例高低不一,不代表模型把這些同分者預測成不同風險。
因此,點重疊時,要先了解分組方式,不能視為模型表現不穩定之證據。正式評估校準,也不宜只數幾組誤差線涵蓋斜線。[3]
07 讀完三張圖再決定如何下結論
兩個例子最值得記住的,是三張圖可能給出不同的訊息。模型是否適合使用,要回到原本想解決的臨床問題。
| 比較項目 | 用哪張圖判斷 | 模擬例子 | 胃癌案例 |
|---|---|---|---|
| 分辨高低風險 | ROC 曲線,比較曲線與 AUC | 加新標記的模型 B 較好 | 7 變項模型 A 較好 |
| 依模型選擇處置的淨效益 | 決策曲線,比較指定風險門檻下的淨效益 | 模型 B 較高,但部分門檻差異仍不確定 | 兩者很接近,改善程度仍不確定 |
| 模型預測的風險,是否接近實際發生事件的比例? | 校準圖,比較各組預測風險與實際事件發生比例 | 模型 B 普遍高估,模型 A 較接近實際 | 兩者高風險組都偏高,尚難判定優劣 |
| 可以下的結論 | 綜合三張圖判斷 | 模型 B 有改善,但校準問題仍須處理 | 增加五個預測變數改善了 AUC,是否值得採用仍待評估 |
(表格較寬,手機可左右滑動檢視)
臨床判讀的順序
比較兩個模型表現時,先看它們是否使用同一批人評估,再分別判讀三張圖:ROC 曲線看區辨能力、決策曲線看處置的淨效益、校準圖看預測與實際是否接近。三張圖的答案可能不同,應合在一起判斷;AUC 較高,並不足以決定更換模型。
完整實作流程,包括 AUC、校準圖、內部驗證與列線圖,見課程「Step by Step 從零開始:R 語言預測模型實戰」。
參考文獻
- DeLong, E. R., D. M. DeLong, and D. L. Clarke-Pearson. “Comparing the Areas under Two or More Correlated Receiver Operating Characteristic Curves: A Nonparametric Approach.” Biometrics, vol. 44, no. 3, 1988, pp. 837–845. https://doi.org/10.2307/2531595
- Vickers, A. J., and E. B. Elkin. “Decision Curve Analysis: A Novel Method for Evaluating Prediction Models.” Medical Decision Making, vol. 26, no. 6, 2006, pp. 565–574. https://doi.org/10.1177/0272989X06295361
- Riley, R. D., et al. “Evaluation of Clinical Prediction Models (Part 2): How to Undertake an External Validation Study.” BMJ, vol. 384, 2024, e074820. https://doi.org/10.1136/bmj-2023-074820
- Eom, B. W., et al. “Survival Nomogram for Curatively Resected Korean Gastric Cancer Patients: Multicenter Retrospective Analysis with External Validation.” PLOS ONE, vol. 10, no. 2, 2015, e0119671. https://doi.org/10.1371/journal.pone.0119671
圖 1 至圖 3 為模擬資料;圖 4 至圖 6 為公開資料的教學重分析,並非原研究直接報告的模型比較結果。
同期其他單元
- 本期工具|AI 英文潤稿改了什麼?實測對照
- 本期重點|統合分析納入的試驗被撤稿了,結論會差多少?
- AI 治理 No.07(上)|AI 已經走進醫院,證據跟上了嗎?
匯東華電子報 第 8 期|2026.10.30|看本期網頁版 →
聯絡我們
- LINE:@medatatw
- Email:info@medatatw.com
- 電話:07-9721586
- 官網:www.medatatw.com

統計分析
服務價目表 (未含5%營業稅)
透過嚴謹的數據整理,提供有價值的資訊,形塑知識,提高決策品質。包括信達雅三執行原則。
信:確保資料品質可信賴
達:確保統計方法適切性
雅:確保圖文表格正規化
協助代執行統計分析與進一步加值服務。
在匯東華與夥伴的專業背景知識配合下,能有效地處理面對的問題。
統計分析成果

數據串接與清洗
數據是礦藏,數據清洗是挖出鑽石的第一步,尤其是巨量知識。數據清洗或串接執行過程需要細心與專注,且有可能會消耗許多時間和精力,就由我們來替各位處理掉這個大麻煩。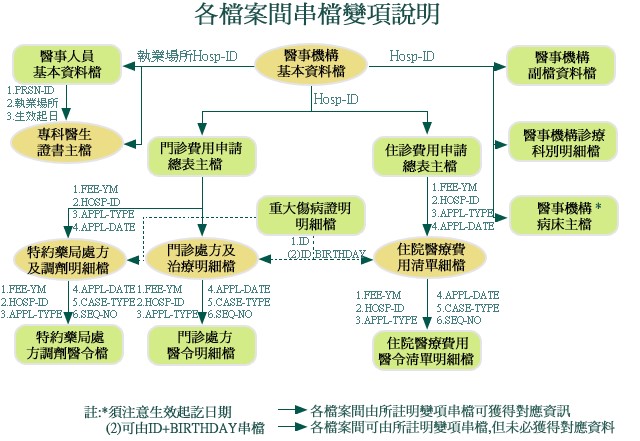
全民健保研究資料庫、國外大型資料庫資料非常齊全,種類多,需要串接與清洗,進行正規化後才能更進一步進行資料探勘與統計分析。
Fig1.同一個Project資料散落在不同tables,無法使用
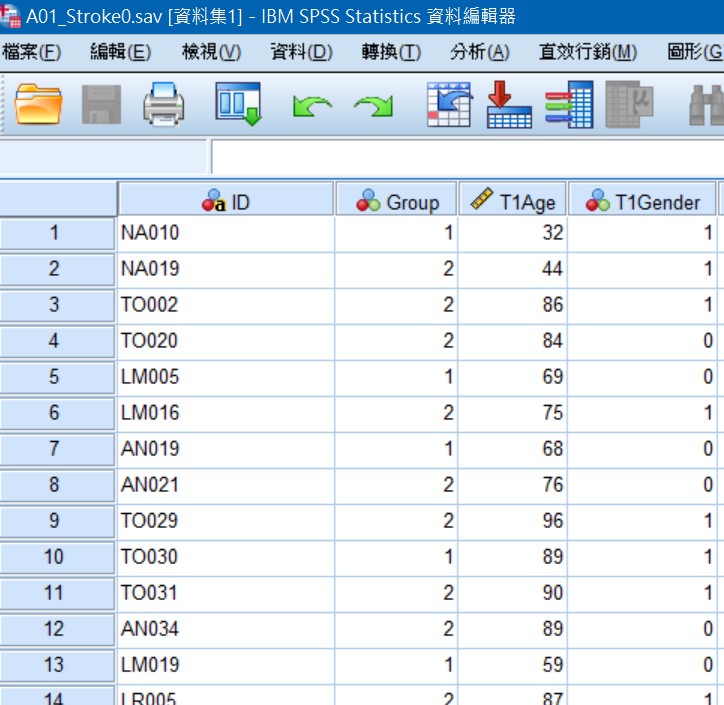
Fig2.整併與清理為可分析的table
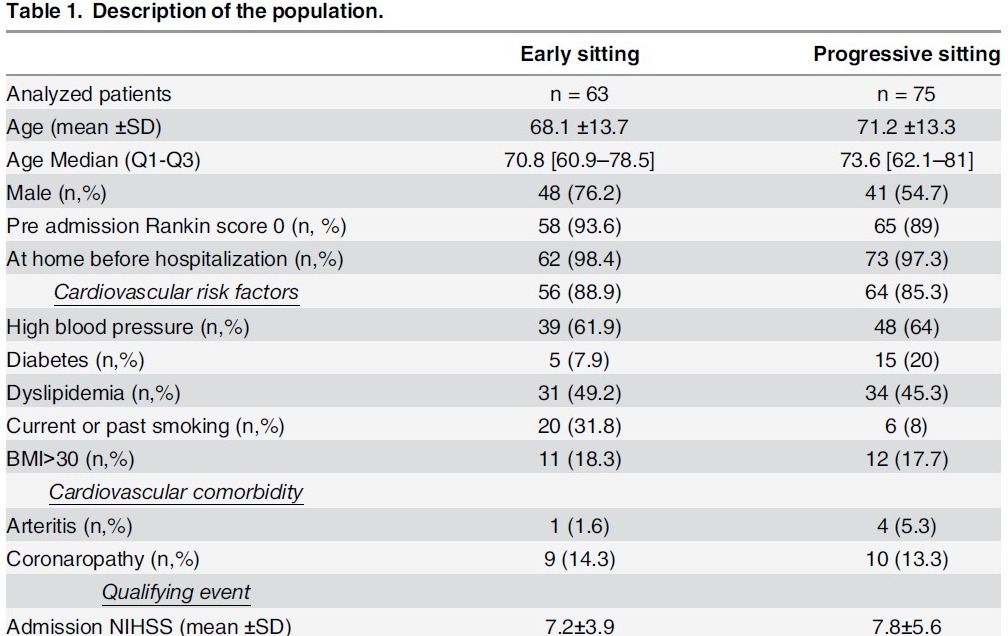
Fig.3整理和分析後形成有意義的知識
概念與流程示意圖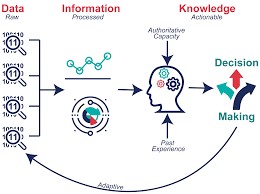

計畫撰寫與統計諮詢
為了讓匯東華的顧客與學員有更好的合作和消費體驗,故匯東華特別依據營業項目開發周邊產品,提供使用、購買。目前已有針對公共衛生師的題庫以及模擬試題,未來將針對醫學研究領域發展產品。