 匯東華統計顧問有限公司
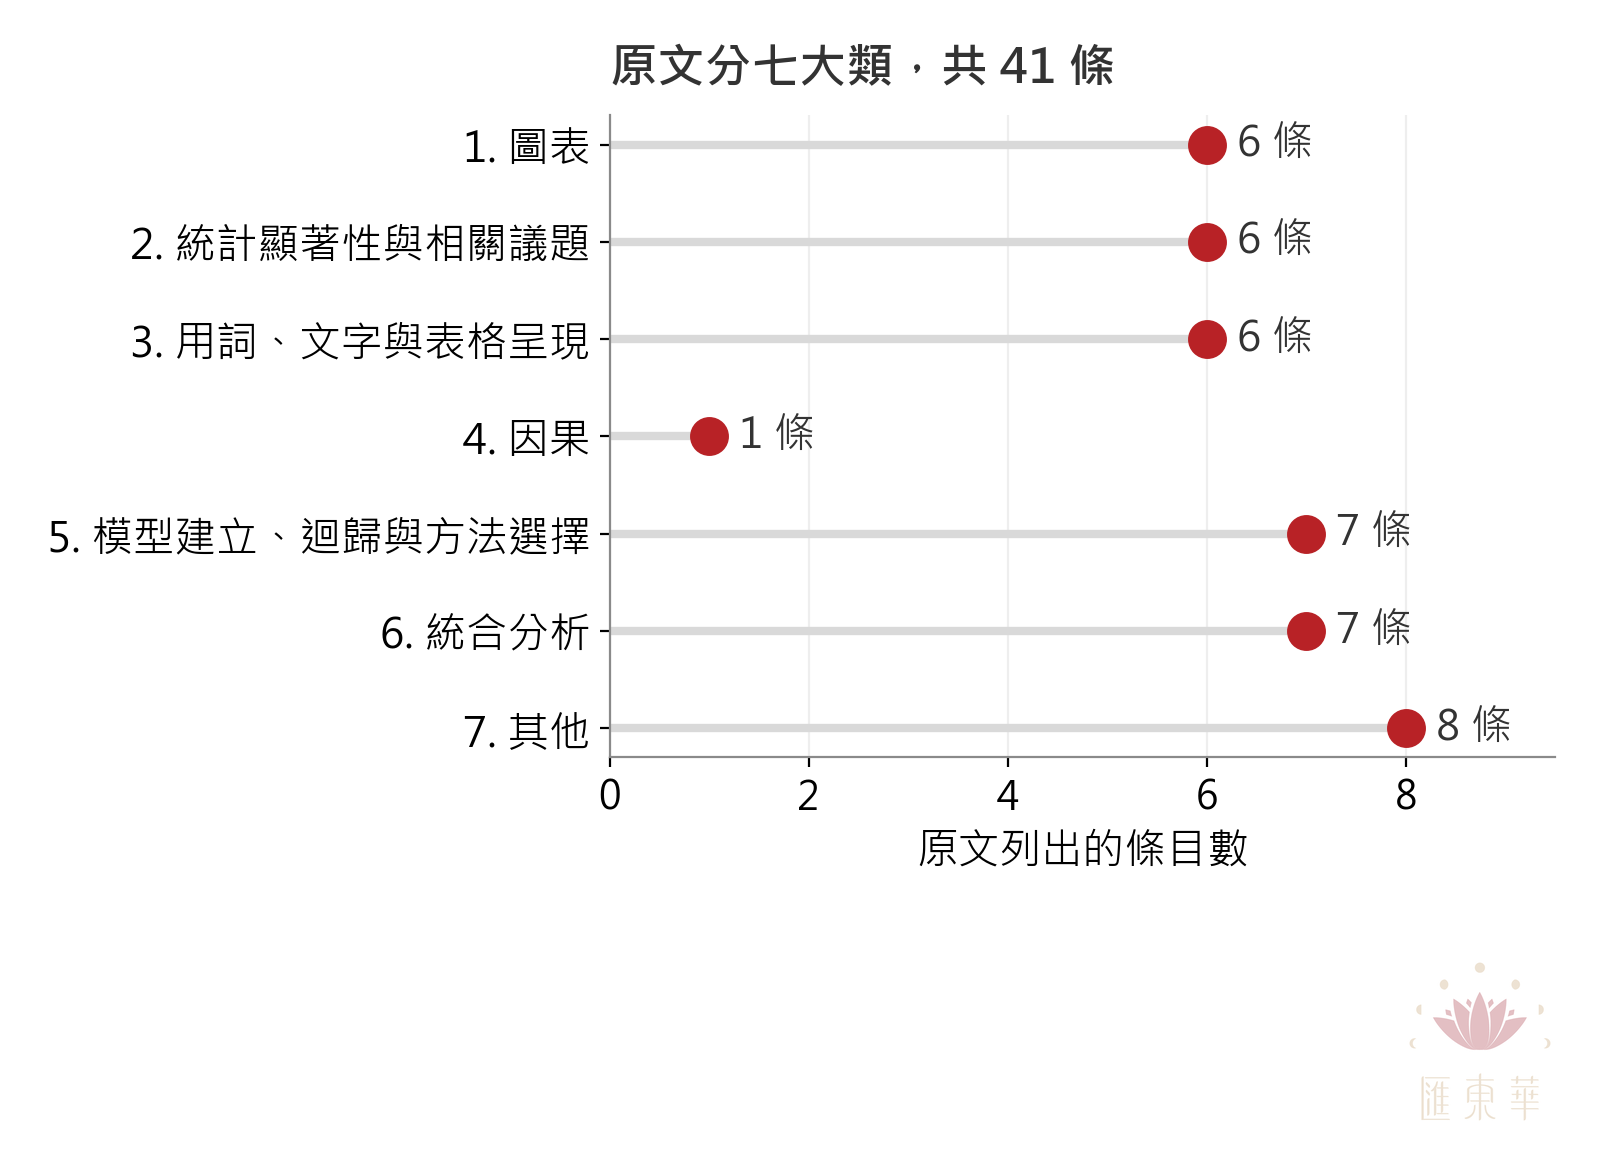
圖 1、原文分七大類、共 41 條的點圖:圖表 6 條、統計顯著性與相關議題 6 條、用詞文字與表格呈現 6 條、因果 1 條、模型建立迴歸與方法選擇 7 條、統合分析 7 條、其他 8 條。
(點擊圖片可開啟原圖放大檢視)
一頁先懂|核心判斷
2024 年,《BMJ Paediatrics Open》的統計審稿人與編輯發表一篇短文,整理他們在投稿稿件裡反覆看到的統計與方法學問題,分成七大類、共 41 條,多數附上改法。
本份清單最實用的地方,是讓你從審稿人的角度檢視自己的稿件。本文不逐條翻譯原文,我們從中挑出幾個在稿件裡很常見、也最適合用圖說明的場景,並用模擬資料做成「常見版 vs 建議版」的對照圖,說明為什麼要改、怎麼改。
文末附一份我們整理的「投稿前自查 10 問」,照稿件從方法、結果、圖表到討論的順序排列,送審前逐項自檢。
01|這篇文章目的為何、如何評讀
原文作者為該刊之統計審稿人與編輯。他們在摘要中說明做法:向刊內的統計審稿人與編輯徵集各自最常碰到的問題與好的做法,整理成圖表、統計顯著性、用詞與呈現、因果、模型與方法選擇、統合分析、其他等,共七個部分(p.1)。文章由期刊邀稿、經外部同儕審查(p.6),2024 年 9 月 15 日線上發表(p.1)。
本篇文章的價值在於具體。每一條都是一個能在稿件裡找到的寫法或畫法,多數條目後面附一句改法;多數改法無需重跑分析,而是修改呈現方式與方法段的寫法。
以下為我們挑出的幾個可具體用於寫作與檢視研究手稿時的建議。
02|圖:要能讓讀者一目了然本圖目的與結果
原文第一部分全部在談圖(p.1–2)。我們把五種圖用同一種方式重畫:同一份模擬資料,左邊是常見畫法,右邊是建議畫法。看完五張,主要原則為:確認本圖要表達的目的,並選擇能讓讀者一目了然的視覺化呈現。
圓餅圖
原文建議類別很少時用表格或文字,類別多時改用點圖(p.1)。
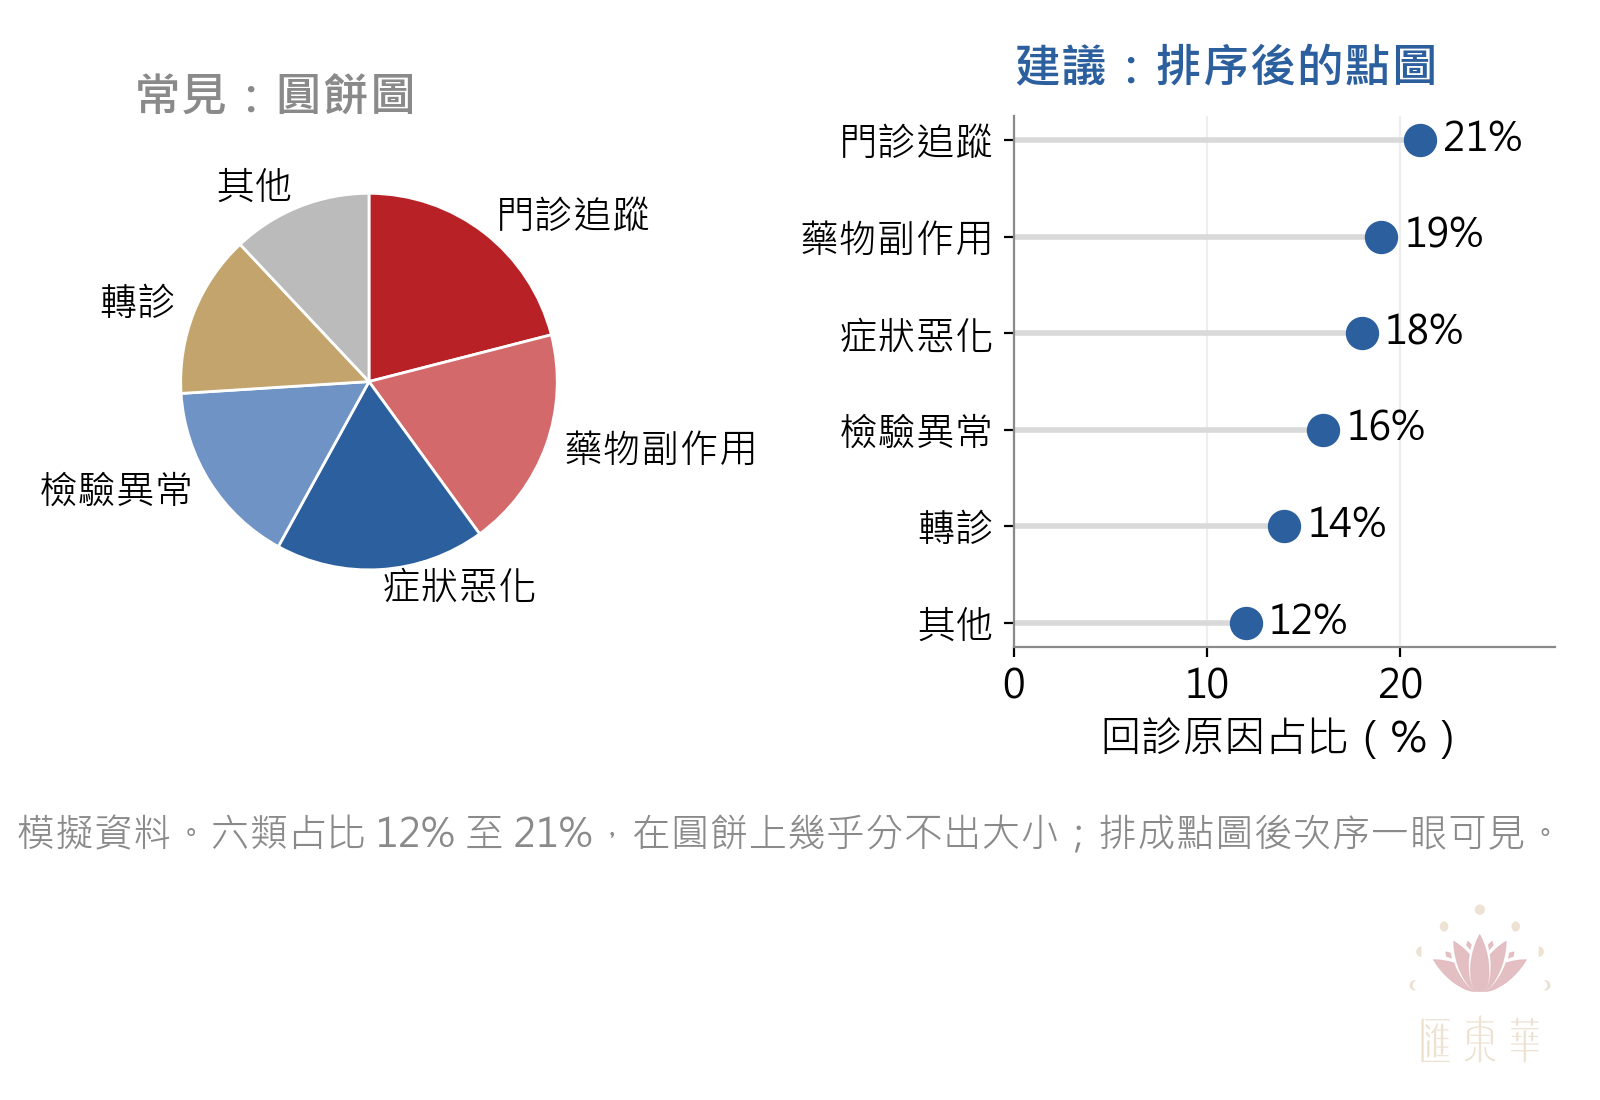
圖 2、左圖為圓餅圖,六類回診原因占比 12% 至 21%,扇形大小幾乎分不出來;右圖為依大小排序的點圖,次序與數值一眼可見。
(點擊圖片可開啟原圖放大檢視)
六個類別占比從 12% 到 21%,在圓餅圖上,判斷「藥物副作用」和「症狀惡化」哪個大相對困難。排序後畫成點圖,次序與差距均能立即判斷。我們的建議是:若讀者需要的是確切數字,一張小表往往比任何圖都清楚。
長條加誤差線(炸藥圖)
原文稱這種圖為 dynamite plot,並引述 Koyama 列出的四個問題,其中包括顯示的資訊太少、看不到實際資料;原文建議樣本不大時直接畫出每個資料點,或改用盒鬚圖、小提琴圖(p.1)。
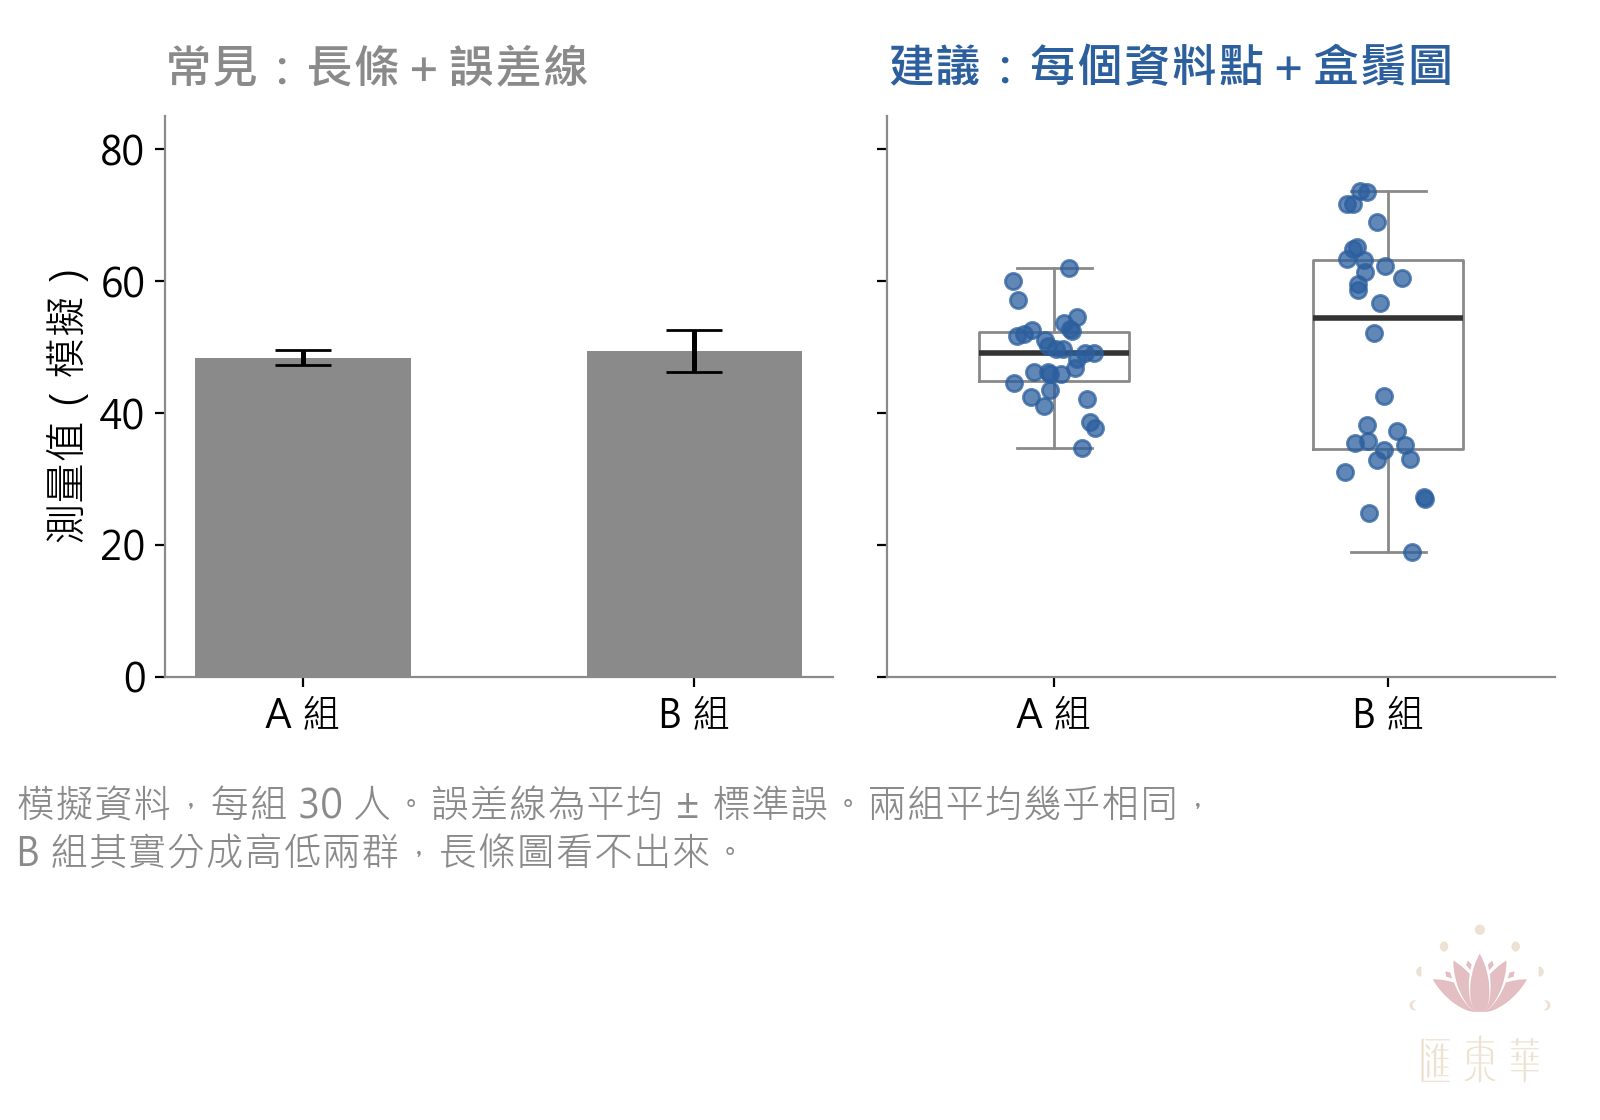
圖 3、左圖為兩組的長條加誤差線,平均值幾乎相同;右圖將每位受試者的數值畫成點並疊上盒鬚圖,可看出 B 組分成高低兩群。
(點擊圖片可開啟原圖放大檢視)
左圖給人的印象是「兩組差不多,B 組變異大一點」。右圖才看得出 B 組其實是兩群人,平均值剛好落在兩群中間、沒有任何人的地方。這類結構一旦壓縮成一根長條,讀者就無法回推資料原始分布。例如對治療有反應與沒反應的病人混在同一組時,就可能出現這種「平均相同、其實分成兩群」的分布。
雙 Y 軸圖
原文指出,只要改動任一邊座標軸的範圍,圖的樣子就會大幅改變,建議改畫差值或比值,或拆成兩個面板(p.1)。
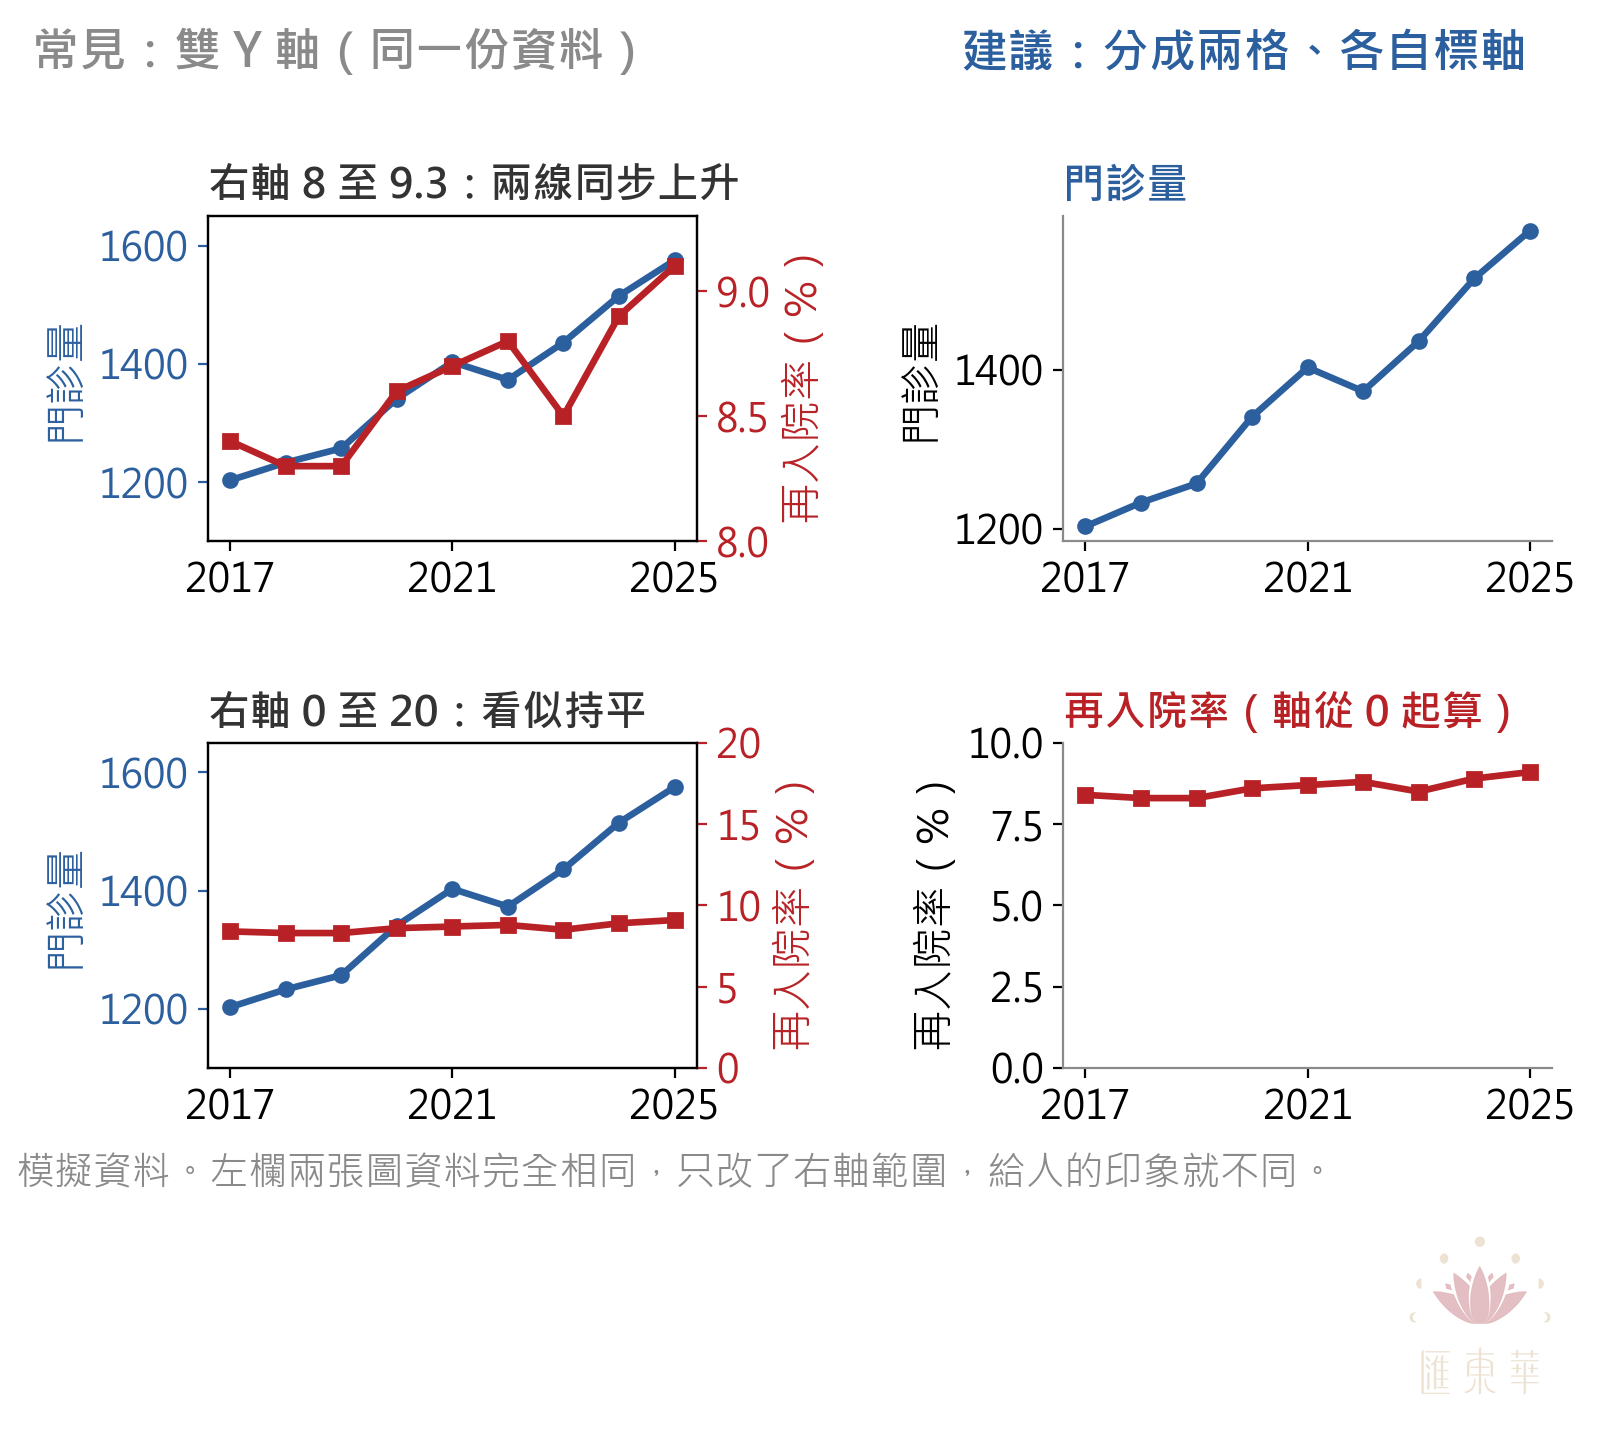
圖 4、左欄兩張雙 Y 軸圖使用完全相同的資料,右軸範圍分別為 8 至 9.3 與 0 至 20,前者看似兩線同步上升,後者看似再入院率持平;右欄將門診量與再入院率拆成兩個面板,各自標示座標軸。
(點擊圖片可開啟原圖放大檢視)
左欄兩張圖的資料一模一樣,只修改右軸範圍:上面看起來「兩者同步上升」,下面看起來「再入院率幾乎不變」。兩個印象都來自作者對座標軸的選擇。拆成兩格之後,讀者可以分別判斷每個變項,也不會被兩條線是否交叉誤導。
直方圖
原文引用統計圖學專家 Cleveland 的評語,並指出直方圖的樣子會被起始點與組距強烈影響,建議改用密度圖或分位數圖(p.1)。
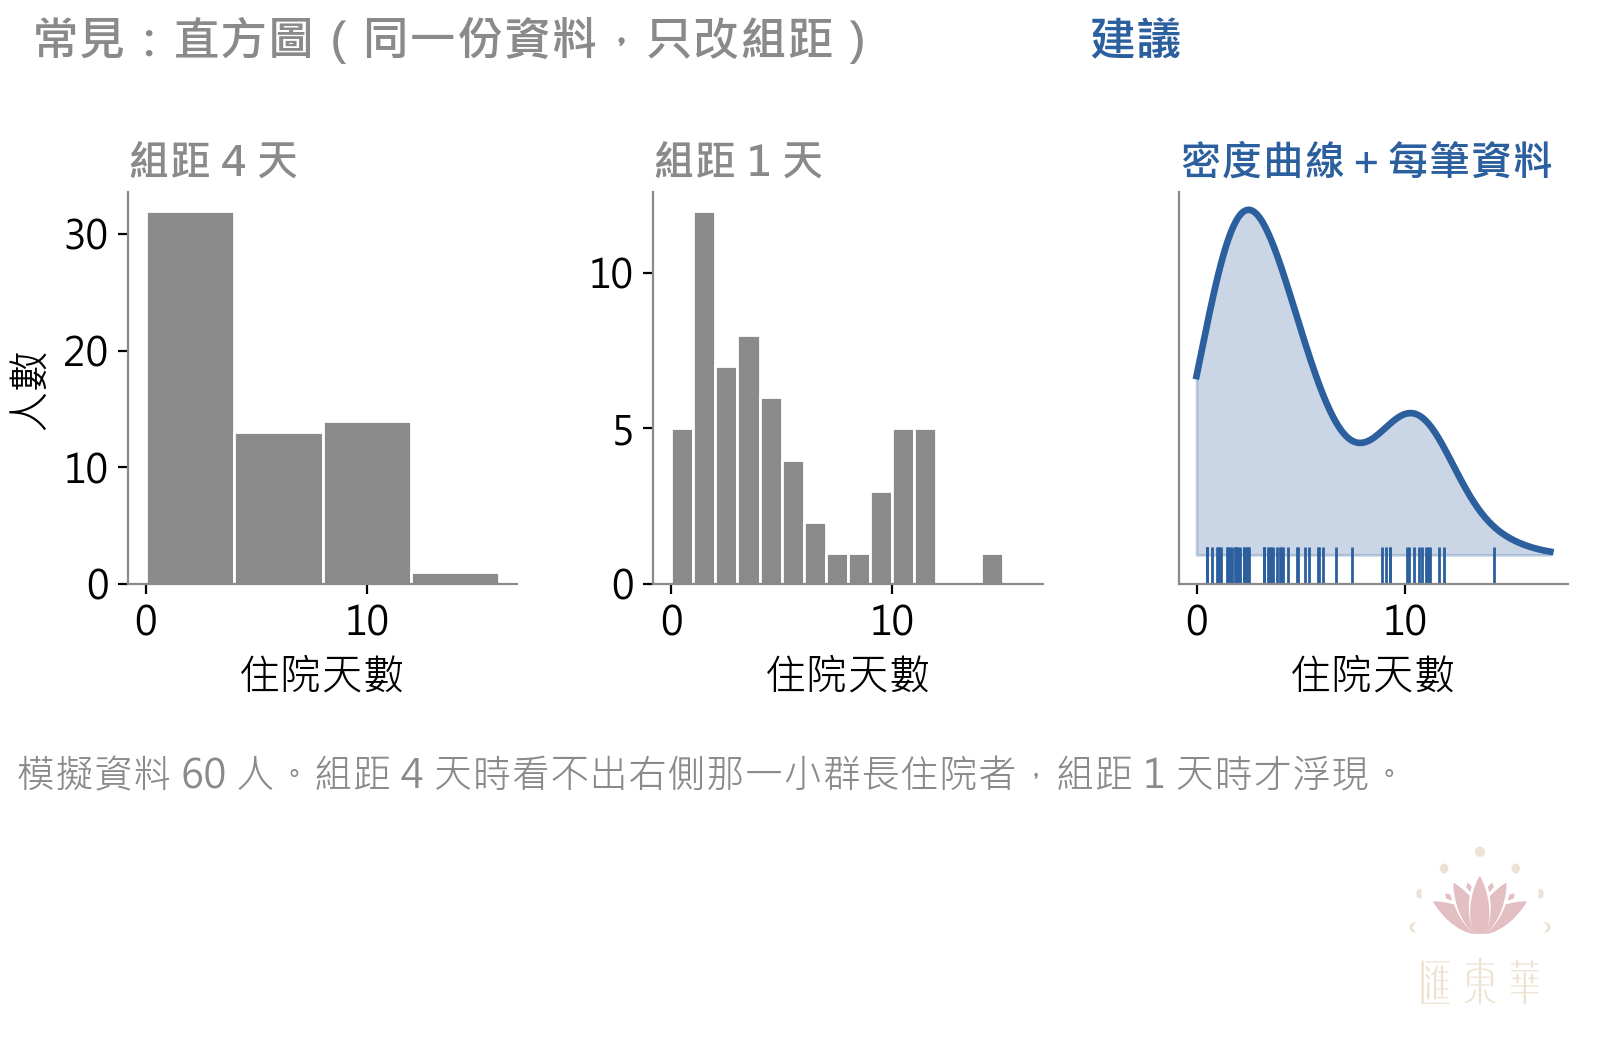
圖 5、同一份 60 人的住院天數資料:組距 4 天的直方圖看不出右側那群長住院者,組距 1 天時才出現第二個高峰;右側的密度曲線加上每筆資料的短線,可同時看到兩個高峰與每一筆資料的位置。
(點擊圖片可開啟原圖放大檢視)
同一份住院天數資料,組距 4 天時,右側那群住院十天以上的人被吞進長條裡;組距 1 天時才出現。讀者無從得知換一種切法的分布形狀,所以我們建議使用密度曲線呈現,並在底部標出每筆資料的位置。
堆疊長條圖
原文指出,堆疊長條的各段起點不對齊,難以跨組比較,建議改用並列長條圖、折線圖或馬賽克圖(p.1)。
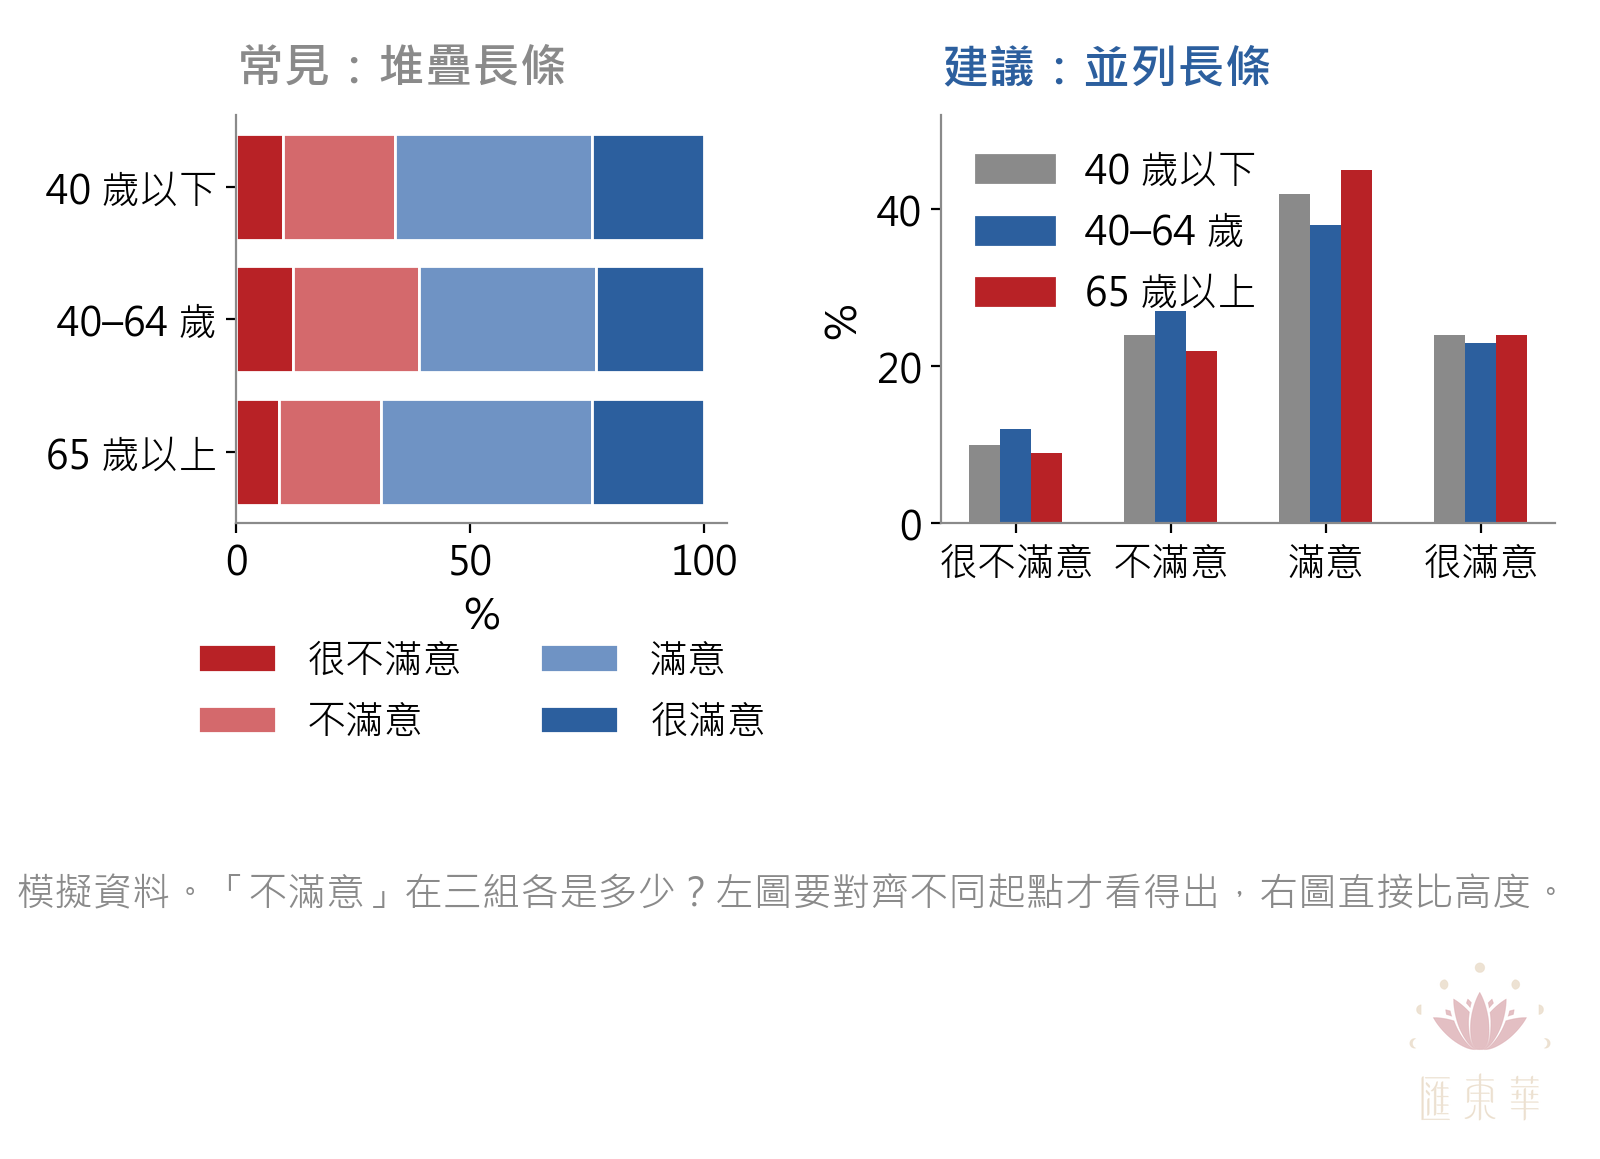
圖 6、左圖為三個年齡組的滿意度堆疊長條,除第一段外各段起點不對齊;右圖為並列長條,四種滿意度在三組間可直接比較高度。
(點擊圖片可開啟原圖放大檢視)
試著用左圖回答「哪一個年齡組回答『不滿意』的比例最高」:你得在腦中把三段不同起點的長條對齊。右圖只要比高度。
03|結果段:p 值可以留,效果量一定要有
原文在這一部分有句話值得記下:若字數只容許在效果量與 p 值之間二選一,他們會選擇拿掉 p 值(p.2)。理由是效果量回答的是讀者真正關心的問題:病人多活多久、風險降低多少。原文也建議效果量要附信賴區間,p 值寫精確值,極小的寫「< 0.001」而不寫「0.0000」(p.2)。
例如結果段只寫「兩組有顯著差異(p < 0.05)」,沒有差多少、區間多寬。這些數字其實都在原本的軟體輸出裡,補上不需要重跑分析。第 5 期的本期重點談過效果量、信賴區間與最小重要差異怎麼一起報,可以搭配閱讀。
04|二分類結果:比值和差值都報
原文建議,二分類結果除了相對風險或勝算比,也要報風險差,範例為:試驗組改善機率 0.5、對照組 0.3(p.4)。我們把這組數字畫成兩張各 100 格的圖:
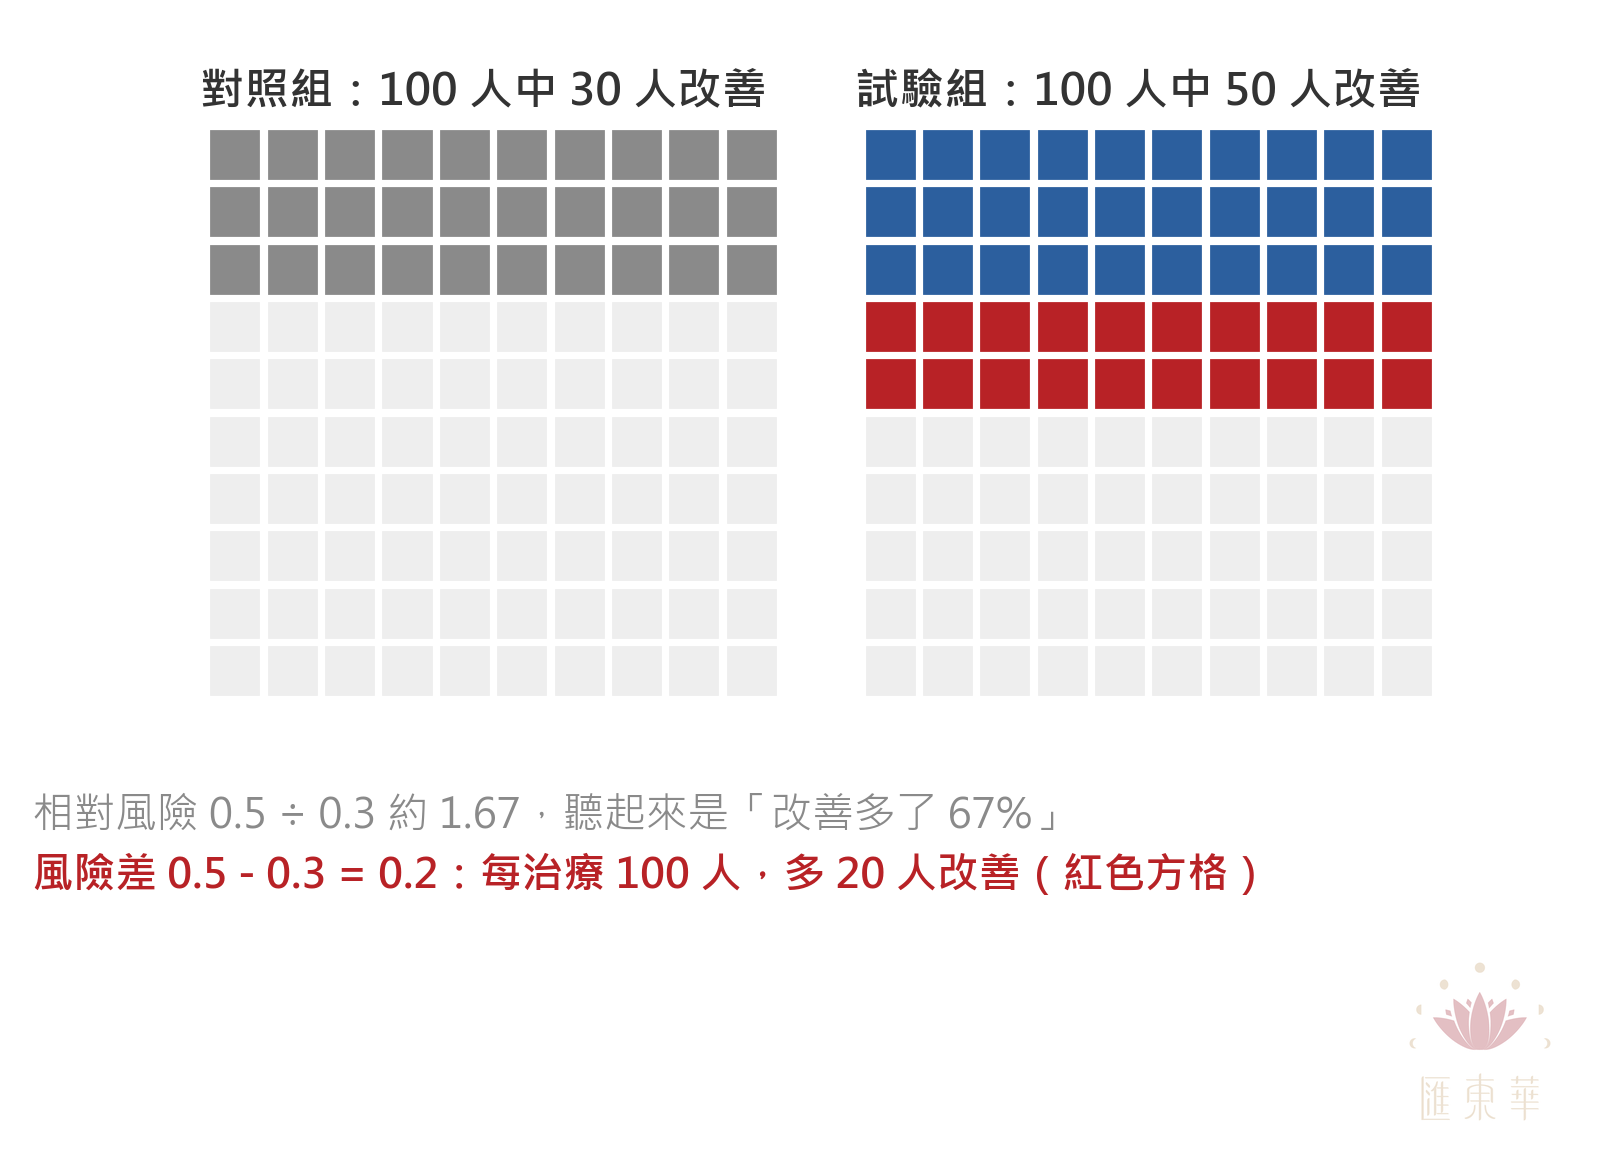
圖 7、兩個 10 乘 10 的方格圖。對照組 100 人中 30 人改善,試驗組 100 人中 50 人改善,其中多出的 20 人以紅色標示。相對風險約 1.67,聽起來是改善多了 67%;風險差 0.2,代表每治療 100 人多 20 人改善。
(點擊圖片可開啟原圖放大檢視)
「相對改善 67%」與「每治療 100 人,多 20 人改善」描述的是同一件事,給人的感受差很多。只報前者,讀者很容易高估效果。臨床讀者做決定時需要的,通常是後者。
與比值有關的另一個提醒,原文放在「勝算不等於風險」一條:勝算比不等於風險比,結果越常見兩者差得越多(p.5)。原文舉了一個真實事件,說明把勝算誤讀為風險的後果:1995 年英國的「避孕藥恐慌」,靜脈血栓風險「增加將近一倍」,實際上是從約七千分之一增加到七千分之二,許多女性因此停藥,隨後懷孕率與人工流產率上升(p.5–6)。
05|子群分析:一組顯著、另一組不顯著,不代表兩組有差
研究者常把資料分成男女、年齡層等子群各自分析,再依 p 值下結論:「只對某一組有效」。原文引用 Gelman 與 Stern 的文章指出,「顯著」與「不顯著」之間的差異本身不一定會顯著,建議在模型中放入交互作用項直接檢定,並用圖呈現(p.6)。
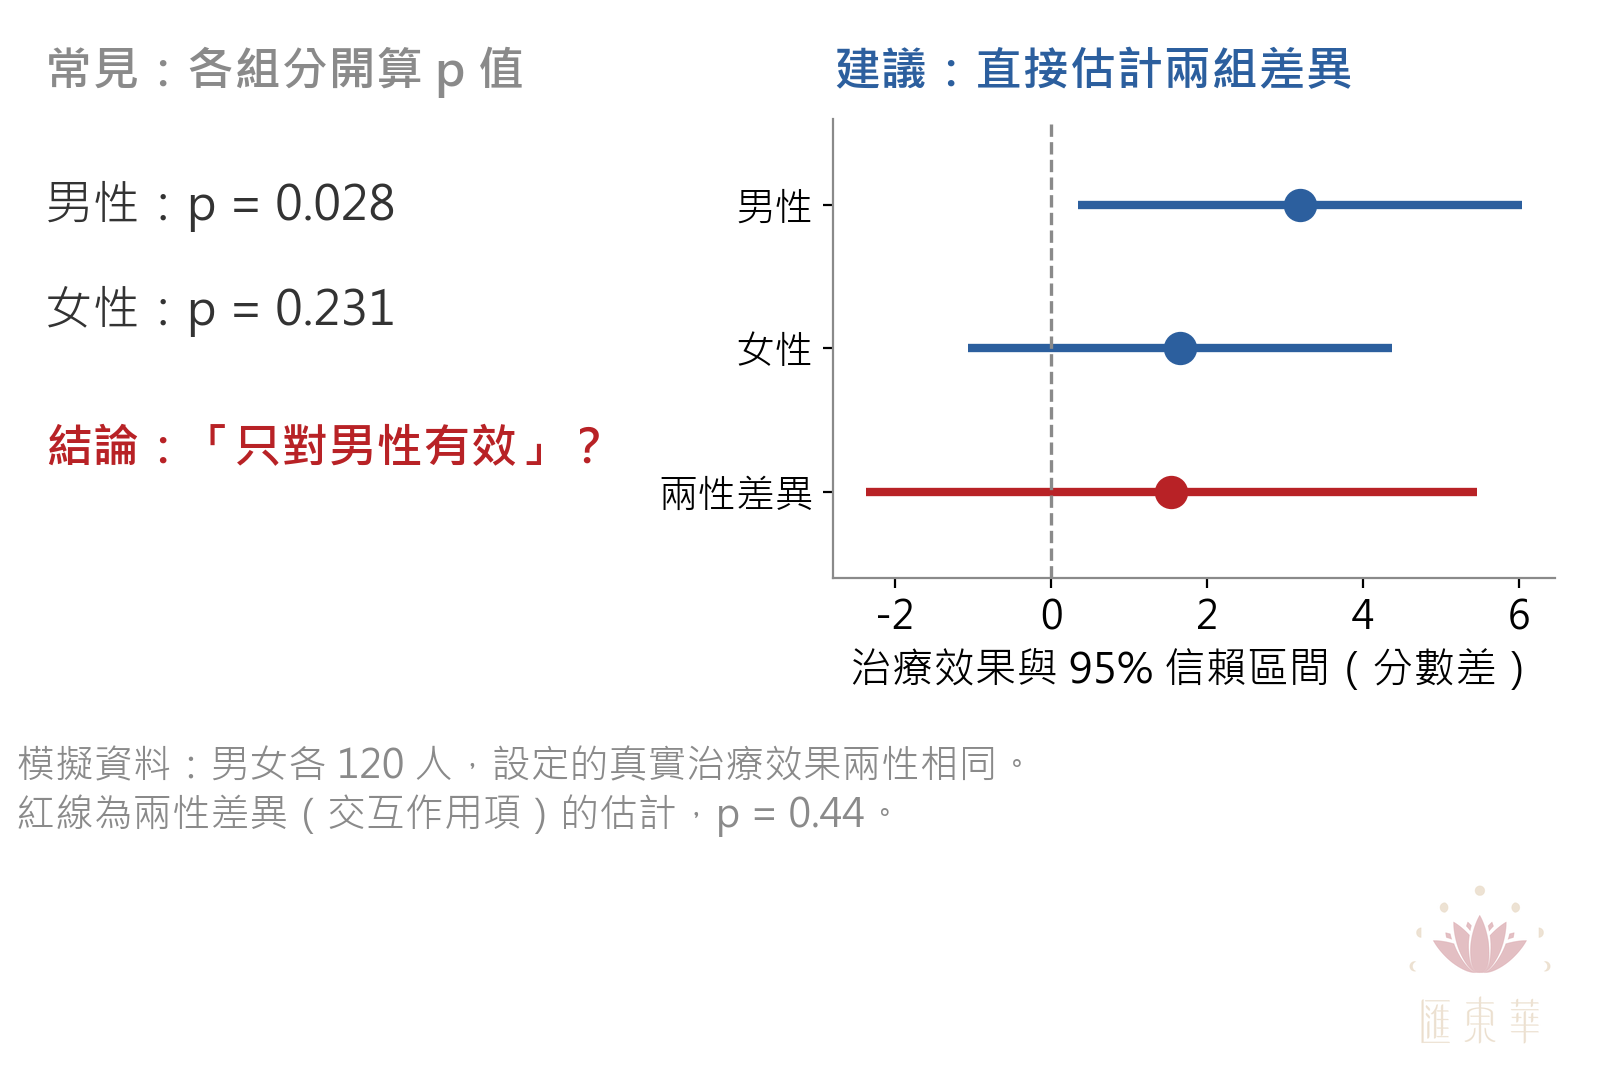
圖 8、左側列出男性 p = 0.028、女性 p = 0.231,並下結論「只對男性有效」;右側森林圖顯示男性與女性的治療效果與 95% 信賴區間,以及兩性差異(交互作用項)的估計,其信賴區間跨越 0,p = 0.44。
(點擊圖片可開啟原圖放大檢視)
這組模擬資料裡,我們刻意設定治療對男女的真實效果完全相同,男女各 120 人。分開檢定卻得到一個 0.028、一個 0.231,很容易寫成「只對男性有效」。右圖的紅線才是回答「男女效果有沒有不同」的估計:它的信賴區間大幅跨過 0。兩組人數相同,估計的精確度也相近(兩組治療效果估計值的標準誤約 1.44 與 1.37;這是估計值的不確定程度,不是資料本身的標準差);一個 p 值小、一個大,是因為兩組的點估計在抽樣變異下剛好一個是 3.2、一個是 1.7。真實效果相同的兩組,單憑機率就可能出現這種落差。這裡呈現的是一次模擬結果:我們從 1 至 3999 的亂數種子中選出一個能呈現此現象的種子,換成其他種子,兩組的 p 值會不同。
06|另外四個我們想特別提醒的地方
以下四點原文都有談到,特別說明是因為它們會動到分析或結論本身,投稿前才發現可能會太遲。
因果用語。 原文說,編輯常因為觀察性研究使用因果語言而直接不送外審(p.3)。「與⋯相關」和「降低⋯風險」在讀者眼中差很多;研究設計無法支撐因果,就避免使用因果的動詞。
把連續變項切成組別。 原文指出切組會同時增加第一型與第二型錯誤,並以兒童生長遲緩的切點為例:−1.99 與 −2.01 個標準差的孩子並沒有實質差別(p.4)。我們的建議是:分析時保留連續變項,需要時只在呈現上分組。
用逐步法挑變項。 原文的評語是此類作法會讓 p 值太小、標準誤太小、估計值偏離 0,理想做法是依專業知識挑選變項(p.3)。實務上,此為審稿人容易在方法段一眼看到的地方。
統合分析裡的 I²。 原文提醒 I² 是相對的不一致性指標,不宜訂通用門檻,也不該用「I² 超過 50% 就改用隨機效應」這種規則選模型;模型應依想做的推論事先決定(p.4–5)。同一部分也提醒,PRISMA 是報告指引,不是執行指引(p.4)。
07|投稿前自查 10 問
下列十個問題為我們依協助投稿的經驗整理,照稿件從方法、結果、圖表到討論的順序排列。每一題都對著你自己的稿件回答;答不出來、或答案是「沒有」的,建議送審前補齊。
方法段
- 別人照著你的方法段,能重做一次分析嗎? 找出軟體名稱與版本、用到的附加套件,以及較少見方法的做法說明與引用文獻,確認都寫了。
- 樣本數是怎麼決定的,寫得出能重算的依據嗎? 若做過檢定力分析,確認效果量、顯著水準、檢定力、樣本數與效果量的出處都在文中。
- 遺漏值怎麼處理、要做哪些敏感度分析,是看資料前就定好的嗎? 若是看完結果才加的,文中要說明理由。
- 模型裡的每一個變項,是怎麼選進來的? 如果答案是「單變項分析 p 值夠小」或逐步法,建議回頭用研究問題與專業知識重新檢視。
結果段
- 每一個主要結果,都有帶單位的效果量與信賴區間嗎? 同時確認 p 值是精確值,Table 1 沒有被拿來篩選變項。
- 二分類結果,讀者看得到「每 100 人差幾人」嗎? 只有勝算比或相對風險時,考慮加報風險差或需治療人數。
- 文中若有「某組有效、某組無效」,背後有直接比較兩組差異的分析嗎? 沒有的話,改用交互作用項檢定,或把結論改成描述性的說法。
圖表與數字
- 每張圖要讀者比較的東西,在圖上能直接比嗎? 把圖拿給沒看過資料的同事看,請他說出這張圖的重點;說不出來,就換一種畫法。
- 同一個數字,在摘要、表格、正文與圖中都一致嗎? 順便檢查小數位數是否合理,± 後面是否寫明是標準差、標準誤還是信賴區間。
討論段
- 結論的動詞,研究設計撐得起嗎? 觀察性研究的討論與摘要裡,逐一找出「導致」「效果」「降低風險」這類字眼,確認沒有超出設計能支持的範圍。
讀這篇文章時要知道的事
- 這是一份期刊的經驗整理,不是系統性調查。 原文沒有統計各項問題的出現次數,也不能讀成退稿原因的比例。
- 期刊背景是兒科。 原文的例子多來自兒童營養、新生兒出生體重等領域,但所談的問題並不限於兒科。
- 部分建議屬作者立場。 例如原文認為統合分析選隨機效應「幾乎不會錯」(p.5)、一定要自動挑變項時 LASSO「還算可以」(p.3),都只有簡短說明。投稿到其他期刊時,仍以該刊的作者須知與統計審查意見為準。
- 本文只挑了原文部分內容。 原文共 41 條,本文沒有逐條介紹;想完整對照的讀者,請直接閱讀原文(開放取用,連結見參考文獻)。
- 對照圖使用模擬資料。 除第 04 節方格圖的 0.5 與 0.3 取自原文示例外,所有圖中數字都是我們為說明而產生的模擬資料。
結語|先用審稿人的眼睛看一次
原文的 41 條,多數改的是寫法與畫法,真正會動到分析的只有少數幾條,而那幾條最好在設計階段就避開。投稿前留一個下午,用上面的 10 個問題把稿件從頭看一遍。
審稿人會停下來的地方,先由你自己停下來。
參考文獻
- Flom, Peter, Katie Harron, Javier Ballesteros, Chester Kalinda, Eirini Koutoumanou, Jeremy Miles, Sarah Jane Nevitt, and Peter Rohloff. "Common Errors in Statistics and Methods." BMJ Paediatrics Open, vol. 8, no. 1, 2024, e002755. DOI: 10.1136/bmjpo-2024-002755
- Gelman, Andrew, and Hal Stern. "The Difference Between 'Significant' and 'Not Significant' Is Not Itself Statistically Significant." The American Statistician, vol. 60, no. 4, 2006, pp. 328–331. DOI: 10.1198/000313006X152649
原文授權說明:原文 Flom 等人(2024)以創用 CC 姓名標示-非商業性 4.0 國際授權(CC BY-NC 4.0)開放取用,出處見上列第 1 筆(DOI: 10.1136/bmjpo-2024-002755)。本文為評述與導讀,非原文翻譯或改作;第 02 節依原文第一部分(圖表)的條目順序逐項評述;文中圖片皆為本公司自行繪製,未使用原文圖片。
AI 使用聲明
本文由匯東華統計顧問有限公司 陳秀敏 博士撰稿,Claude Opus 5.5 協助原文整理、引用核對、模擬資料繪圖與版面排版,最終內容已由作者審閱定稿。文中引述之資料來源為上列原文,並標註原文頁碼;對照圖皆為本公司以模擬資料自行繪製(Python 輸出),僅第 04 節方格圖的 0.5 與 0.3 取自原文示例。日期:2026 年 10 月 2 日。
同期其他單元
- 研究誠信與 AI 治理系列 No. 05|大型語言模型於醫療與醫學的倫理考量
- 方法論/工具|論文不只是拿來讀的:把研究論文變成可互動、可靠的 AI 智能體
匯東華電子報 第 6 期|2026.10.02|看本期網頁版 →
聯絡我們
- LINE:@medatatw
- Email:info@medatatw.com
- 電話:07-9721586
- 官網:www.medatatw.com

統計分析
服務價目表 (未含5%營業稅)
透過嚴謹的數據整理,提供有價值的資訊,形塑知識,提高決策品質。包括信達雅三執行原則。
信:確保資料品質可信賴
達:確保統計方法適切性
雅:確保圖文表格正規化
協助代執行統計分析與進一步加值服務。
在匯東華與夥伴的專業背景知識配合下,能有效地處理面對的問題。
統計分析成果

數據串接與清洗
數據是礦藏,數據清洗是挖出鑽石的第一步,尤其是巨量知識。數據清洗或串接執行過程需要細心與專注,且有可能會消耗許多時間和精力,就由我們來替各位處理掉這個大麻煩。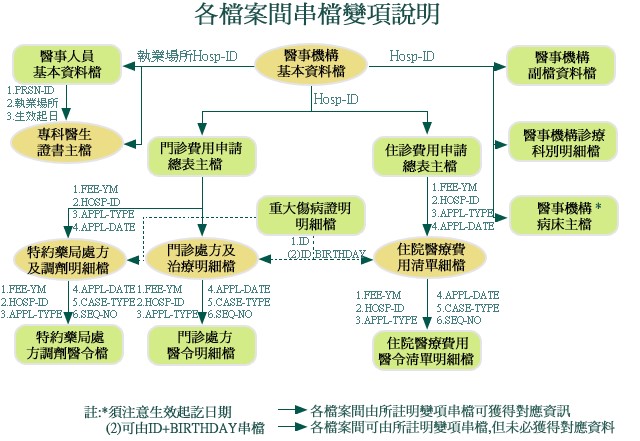
全民健保研究資料庫、國外大型資料庫資料非常齊全,種類多,需要串接與清洗,進行正規化後才能更進一步進行資料探勘與統計分析。
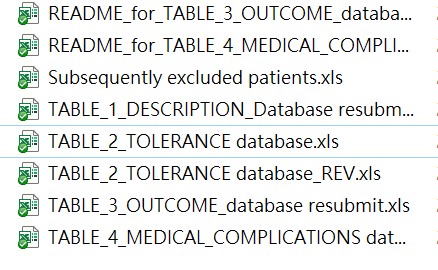
Fig1.同一個Project資料散落在不同tables,無法使用
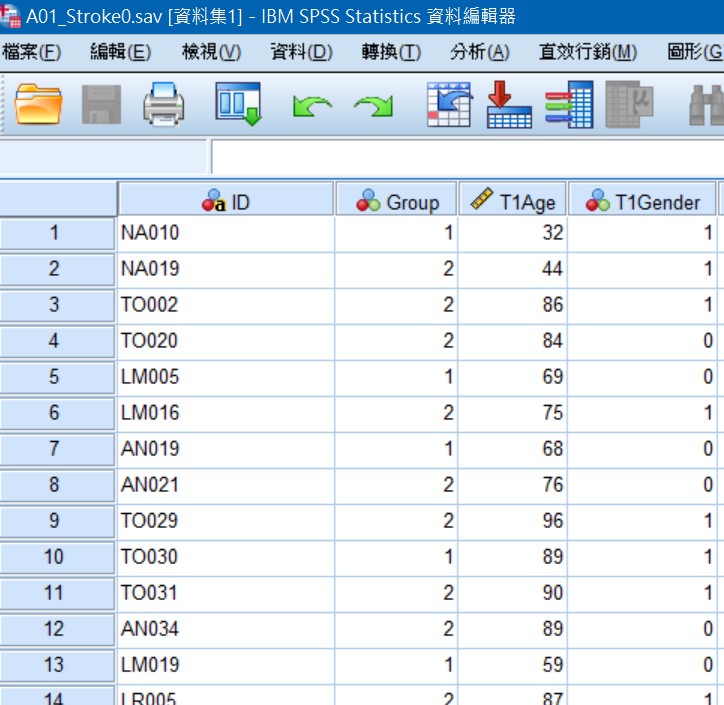
Fig2.整併與清理為可分析的table
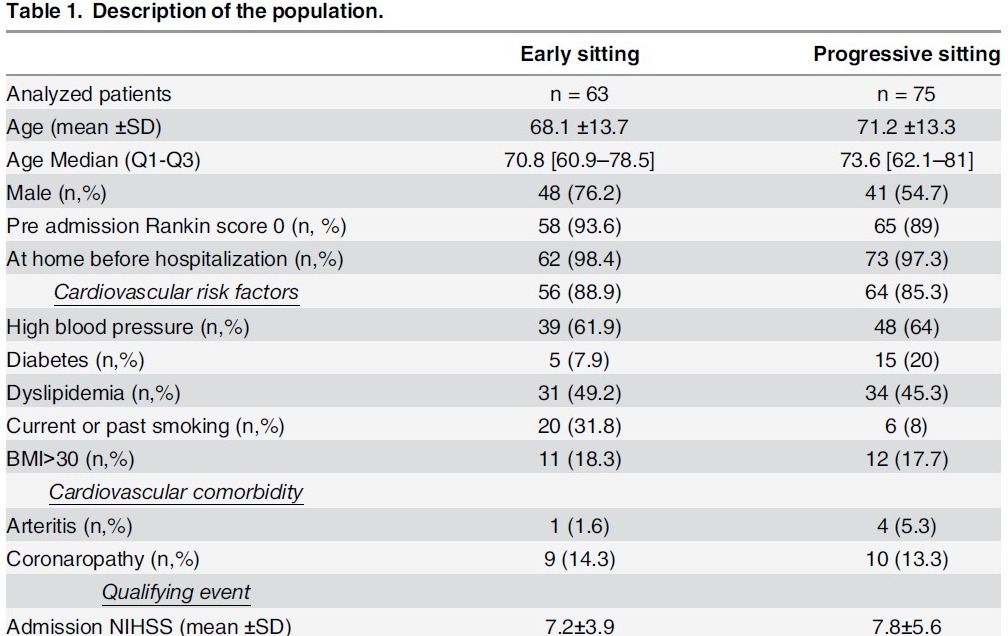
Fig.3整理和分析後形成有意義的知識
概念與流程示意圖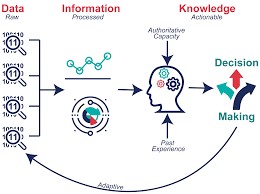

計畫撰寫與統計諮詢
為了讓匯東華的顧客與學員有更好的合作和消費體驗,故匯東華特別依據營業項目開發周邊產品,提供使用、購買。目前已有針對公共衛生師的題庫以及模擬試題,未來將針對醫學研究領域發展產品。