 匯東華統計顧問有限公司
一頁先懂|核心判斷
在臨床或研究中使用大型語言模型(LLM),如何判斷倫理風險?先辨識此用法歸於哪類議題,再確認對應的把關是否到位。
Fareed 等人 2025 年發表的系統性回顧,檢索五個資料庫中 2017 年 1 月至 2025 年 6 月出版的英文開放取用文獻,納入 27 篇。最常討論的是偏誤與公平(7 篇),其次為安全與可靠、透明與可解釋、當責與法律責任(各 4 篇),以及隱私與資安(3 篇)。
第 5 期整理衛福部的醫院導入生成式 AI 五項治理重點;本文回答另一個問題:那些流程所防為何。
27 篇中只有 9 篇明確引用法律或倫理框架;作者也觀察到,許多納入研究完成倫理審查程序,但在一般受試者保護之外,針對 AI 的防護較少著墨。
文末附「倫理面向 × 臨床情境 × 自問」對照表,可用於撰寫研究計畫、準備倫理審查申請,以及院內導入前的評估。
01|27 篇研究最常討論哪些倫理議題
本回顧由 Fareed 等人發表於 Frontiers in Digital Health(2025 年 9 月),依 PRISMA 2020 執行。檢索 ACM Digital Library、SpringerLink、World Scientific、Wiley Online Library 與 PubMed 五個資料庫,最後一次檢索為 2025 年 6 月 10 日,最終納入 27 篇同儕審查研究。納入條件限定英文、開放取用文獻,付費期刊與非英文研究未納入,作者自己也指出這可能漏掉重要研究;篇數多寡反映的是研究熱度,不是風險大小。
作者把每篇研究歸入一類主要倫理議題,分布如下:
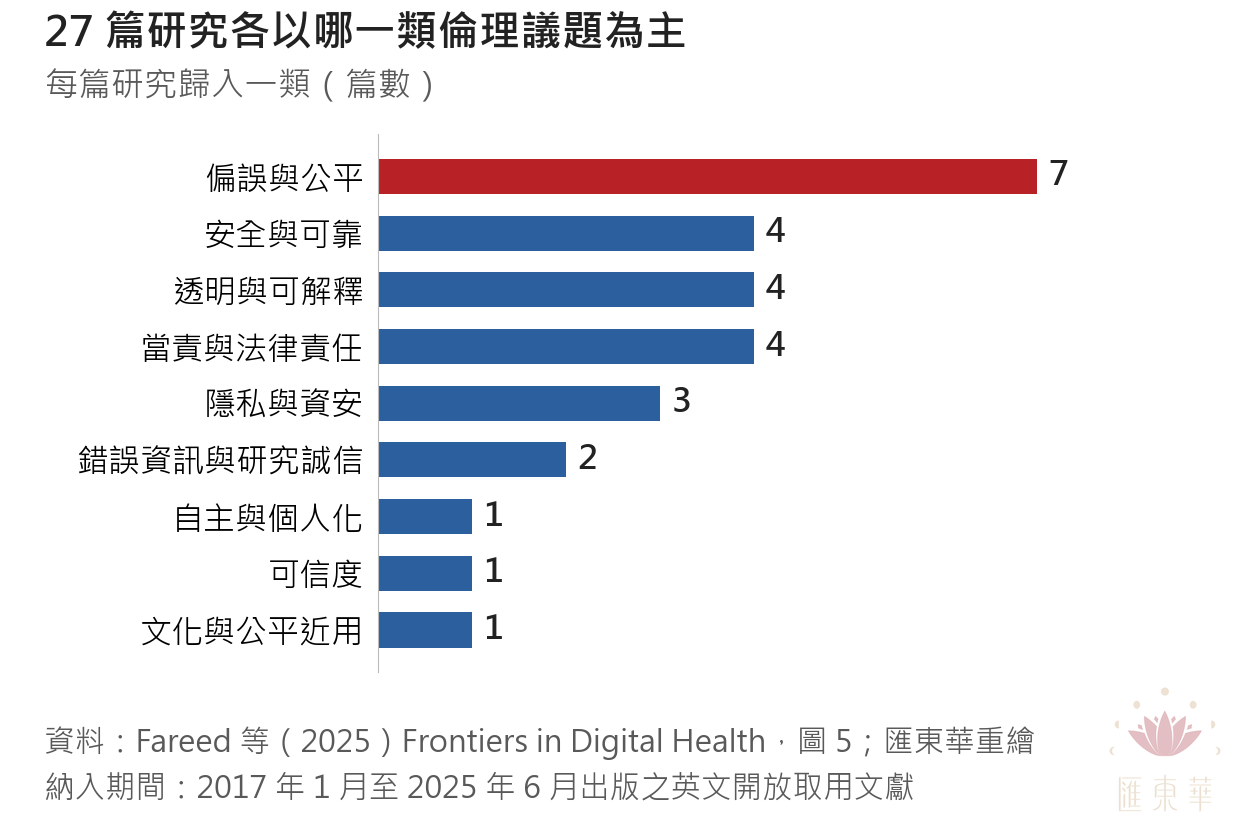
圖 1、27 篇研究的倫理議題分布
(點擊圖片可開啟原圖放大檢視)
前五類合計 22 篇,為本文逐一說明之重點。錯誤資訊與研究誠信雖只有 2 篇,但與研究者的日常最相關,另立一節。
從研究情境來看,臨床決策支援最多(7 篇),其次是心理健康與病人參與及自我管理(各 4 篇)。被分析的模型以 GPT 系列為主,占 14 篇(51.8%)。
以下各節依同一個順序寫:這類問題之研究發現、把關在做什麼、使用前可以問自己哪幾句話。
02|偏誤與公平:同樣的問題,不同病人得到不同答案
研究發現
- 以 GPT-4 進行診斷與治療規劃,輸出出現人口學偏誤,包括疾病盛行率估計偏差,以及對不同群體給出不同建議;作者認為這可能擴大健康不平等。
- 以已被推翻的「種族醫學」情境詢問多個商用 LLM,回答前後不一致,有時帶有種族偏見的內容;研究情境為醫學教育。
- 以 Schwartz 價值理論比較 Bard、Claude、GPT-3.5 與 GPT-4,模型輸出呈現偏向西方的價值取向,並影響臨床建議。
- 臨床語言模型 Clinical BERT 在性別、語言、族裔與保險身分間存在表現差距;對抗式去偏只能部分改善。
回顧作者也指出,去偏方法多半停留在概念層次,缺少真實臨床場域的驗證。
把關在做什麼
導入前的測試若只看整體準確率,群體間的差距會被平均。分組檢視結果,是讓這類偏誤現形之最低要求。
使用前自問
- 測試案例有無涵蓋不同性別、年齡、族群與保險身分?結果有無分組檢視?
- 模型的訓練資料以哪些族群、語言為主?和我們的病人組成差多少?
03|安全與可靠:看起來合理的錯誤最難抓
研究發現
- 飲食障礙康復聊天機器人研究發現,使用者可能不加質疑地接受建議,帶來不安全建議的風險;作者建議介面設計要促使使用者保持批判。
- GPT-3.5 與 GPT-4 對醫療資料交換標準 FHIR 的理解,未達臨床任務所需的準確度,影響資料完整性與病人安全。
- 在病人就醫路徑規劃的情境,將規則檢核(形式化驗證)與 LLM 輸出結合,可減少幻覺與違反限制條件的情形。
蔡甫昌等人在《台灣醫學》的論文也提醒,醫師不一定能分辨幻覺內容的真偽,容易對錯誤的診斷或治療建議過度自信。
把關在做什麼
錯誤的內容若寫得流暢,最容易直接被採用。把關的重點在於輸出送到使用者面前之前,有明確的核對對象(原始病歷、臨床指引)與核對負責人。
使用前自問
- 誰負責核對輸出?依據什麼核對?
- 使用者知道這是待確認的草稿嗎?介面上有作提醒嗎?
04|透明與可解釋:說不出依據,就無法覆核
研究發現
- 比較 LLM 與自殺學專家對自殺介入回應的評分,LLM 系統性地高估回應的適切性;作者認為未經專家基準比對就部署,會帶來倫理風險。
- 一般提示方式下,模型的推理過程不透明;改用程式碼形式的提示,可讓醫療決策的邏輯得以檢驗。
回顧作者指出,可解釋 AI 的方法在醫療領域多仍屬理論,少有大規模的實地評估。
把關在做什麼
覆核的人要能看到輸出依據的來源,才有辦法判斷對錯;看不到依據時,覆核只剩下「看起來對不對」。
使用前自問
- 看得到輸出所依據的資料或出處嗎?
- 模型的判斷有無與專家判斷做過對照?差距方向為何?
05|當責與法律責任:出事時,責任落在誰身上
研究發現
- 在急診輕度創傷性腦損傷的分流情境,GPT-4 能提供清楚的指引,但可能遺漏關鍵細節,可讀性也有落差。
- 以 ChatGPT 草擬病例報告可加快作業,但會遺漏關鍵病史;臨床人員必須仔細審閱。
- 放射與出院摘要的生成,引發責任歸屬不明、偏誤與內容效度的疑慮。
- 外科決策支援的研究建議:由第二位臨床人員覆核、明確區分 AI 建議與醫師判斷、嚴格去識別化,並取得知情同意。
台灣的脈絡
蔡甫昌等人整理:依醫師法第 12 條,醫師製作病歷須簽名或蓋章,實質上即要求醫師為病歷內容負責。以 AI 語音工具製作病歷,即使視為軟體輔助工具,仍有爭議,包括可能須依醫療器材規定管理,以及醫師須為輸入的資料負責。作者也強調,生成式 AI 本身並非為病人負責的主體。
把關在做什麼
責任要落實,紀錄上就要能分辨出哪些為 AI 產出、哪些是醫師判斷,並且知道簽名者核對內容。
使用前自問
- 在紀錄中,AI 草稿與醫師判斷分得開嗎?
- 簽名前核對哪些欄位?遺漏的內容由誰補齊?
06|隱私與資安:模型記得的,可能是不該留的
研究發現
- 語音健康聊天機器人加入長期記憶後,使用者參與和自我揭露增加,但在回想敏感細節時引發隱私疑慮。
- 聯邦式微調結合差分隱私,讓多個機構在不交換原始資料的情況下改良模型。
- 以個人資料儲存與智慧合約設計的去中心化聊天機器人,讓慢性病病人掌控自己的健康紀錄。
蔡甫昌等人另提醒兩種風險:模型合成的資料可能重新識別出個人;有心人士也可能以取得的真實病人紀錄攻擊模型,取回訓練資料中的資訊。
台灣的脈絡
《行政院及所屬機關(構)使用生成式 AI 參考指引》自 2023 年 10 月 3 日生效,規定不得向生成式 AI 提供涉及公務應保密、個人及未經同意公開的資訊;封閉式地端部署的模型,確認系統環境安全後,得依機密等級分級使用。公營事業、公立學校、行政法人及政府捐助之財團法人得準用。
使用前自問
- 輸入的內容含不含可識別個人的資訊?去識別化在輸入前是否已完成?
- 資料送到哪裡、保存多久、會不會被用於再訓練?契約上是否已寫清楚?
07|研究者多看一眼:錯誤資訊與研究誠信
本類在回顧中僅有 2 篇,和寫論文、做研究的人關係最直接。
研究發現
- 有研究以「AI 驅動的資訊疫情」形容風險:未受規範的模型輸出,可能讓誤導性內容大量湧入科學文獻;作者呼籲採用可被偵測的文字設計,並加強專家監督。
- 另一篇研究把社會脈絡特徵納入健康假新聞偵測器,提高偵測準確度與可解釋性。
台灣的脈絡
蔡甫昌等人整理台灣內科醫學會醫學倫理委員會 2023 年的共識,對撰寫科學性著作的規範相當具體:
- 生成式 AI 可協助撰寫研究紀錄、整理與分析資料、將數據圖表化、整理參考文獻。
- 使用情形應記載於方法,或於致謝中說明;協助產出的數據表格與圖表,應在結果中註明。
- 討論與結果應由研究者自行撰寫,不可由生成式 AI 產出。
- 生成式 AI 不應列名為作者。
- 未申明使用視為抄襲;由生成式 AI 捏造數據視為偽造。
回顧本身的提醒
作者觀察到,許多納入研究已通過或豁免倫理審查(IRB),並對敏感資料去識別化;涉及人類受試者的研究,另有知情同意程序。但在一般受試者保護之外,針對 AI 的防護較少被提及。換句話說,通過倫理審查,並不代表 AI 相關風險已經處理。
使用前自問
- 方法節有沒有寫明用了哪個模型、哪個版本、用在哪個步驟?
- 結果與討論是自己寫的嗎?AI 協助整理的參考文獻,每一筆都查過原文了嗎?
- 計畫書與倫理審查申請中,有無說明 AI 的使用範圍與資料去向?
08|帶得走的對照表:倫理面向 × 臨床情境 × 自問
回顧作者依 27 篇研究,提出一個暫行的四層整合框架:法規層(法律與政策保障)、技術防護(偏誤稽核、差分隱私、聯邦學習等)、人為監督(臨床人員覆核、知情同意、參與式設計)、透明與當責(可解釋方法、稽核軌跡、紅隊測試)。
第 5 期介紹的衛福部指引,則把這類要求落成醫院內可執行的流程。流程所對應的即為下表各面向;可逐條確認,進行把關。
| 倫理面向 | 可能發生在哪裡(納入研究的情境) | 使用前自問 | 回顧篇數 |
|---|---|---|---|
| 偏誤與公平 | 診斷與治療規劃、醫學教育問答、臨床價值判斷 | 測試結果有沒有依性別、年齡、族群、保險身分分組看?訓練資料和我們的病人差多少? | 7 |
| 安全與可靠 | 病人自助聊天機器人、醫療資料交換、就醫路徑規劃 | 誰核對輸出?依據什麼核對?使用者知道這是待確認的草稿嗎? | 4 |
| 透明與可解釋 | 症狀診斷模型、自殺介入評估、居家健康監測 | 看得到輸出依據的出處嗎?和專家判斷對照過嗎? | 4 |
| 當責與法律責任 | 急診分流、病例報告與出院摘要、外科決策支援 | 紀錄中分得出 AI 草稿與醫師判斷嗎?簽名前核對了哪些欄位? | 4 |
| 隱私與資安 | 語音健康聊天機器人、跨機構模型微調、慢性病管理 | 輸入前完成去識別化了嗎?資料去哪裡、存多久、會不會再訓練? | 3 |
| 錯誤資訊與研究誠信 | 論文撰寫輔助、健康假訊息 | 方法節寫明模型、版本與用途了嗎?結果與討論是自己寫的嗎?文獻逐筆查過嗎? | 2 |
| 自主、可信度與公平近用 | 運動健康建議、眼科病人問答、孕產照護聊天機器人 | 建議是否配合病人的決策方式?是否讓病人知道有 AI 參與?設計時有沒有納入弱勢使用者的意見? | 各 1 |
(表格較寬,手機可左右滑動檢視)
表中「情境」取自回顧納入的研究,「自問」為匯東華依各類問題整理的檢核句。九類之中,自主與個人化、可信度、文化與公平近用三類各只有 1 篇,因此合併為最後一列。
蔡甫昌等人引用 Ong 等人的整理,提供另一個角度,用生命倫理四原則來對照:行善對應當責與可靠,不傷害對應避免幻覺,自主對應資料隱私與知情同意,正義對應透明與偏誤。熟悉四原則的臨床人員,可以用這組對應快速定位。
結語|先認出議題,再確認把關的人
每一種 LLM 用法都可以先問兩件事:它落在哪一類倫理議題?出錯時,誰會發現、誰負責?
兩個問題都答得出來,導入流程才有明確的防守對象。
每一種 AI 用法,都要說得出:出錯時誰會發現、誰負責。
參考文獻
- Fareed, Muhammad, Madeeha Fatima, Jamal Uddin, Adeel Ahmed, and Muhammad Awais Sattar. "A Systematic Review of Ethical Considerations of Large Language Models in Healthcare and Medicine." Frontiers in Digital Health 7 (2025): 1653631. https://doi.org/10.3389/fdgth.2025.1653631
- 蔡甫昌、周昱辰。〈大型語言模型醫學應用之倫理挑戰與監理〉。《台灣醫學》29 卷 1 期(2025):75-85。https://doi.org/10.6320/FJM.202501_29(1).0010
- 衛生福利部。《醫療機構應用生成式人工智慧指引》。115 年 5 月 29 日衛部醫字第 1151663164 號函頒。衛生福利部醫事司。https://www.mohw.gov.tw/cp-18-86695-1.html (查閱日期:2026 年 9 月 13 日)
AI 使用聲明
本文由匯東華統計顧問有限公司 陳秀敏 博士撰稿,Claude Opus 5.5 協助原文檢索、內容整理、圖表繪製與版面排版,最終內容已由作者審閱定稿。文中引自兩篇期刊論文之內容,均逐頁核對原文 PDF;Fareed 等人論文之作者、年份、期刊與識別碼以 CrossRef 查證,蔡甫昌等人論文之識別碼經 DOI 註冊機構確認。圖 1 依原文數據重繪。日期:2026 年 10 月 2 日。
同期其他單元
- 統計方法實務|醫學研究常見統計錯誤
- 方法論/工具|論文不只是拿來讀的:把研究論文變成可互動、可靠的 AI 智能體
匯東華電子報 第 6 期|2026.10.02|看本期網頁版 →
聯絡我們
- LINE:@medatatw
- Email:info@medatatw.com
- 電話:07-9721586
- 官網:www.medatatw.com

統計分析
服務價目表 (未含5%營業稅)
透過嚴謹的數據整理,提供有價值的資訊,形塑知識,提高決策品質。包括信達雅三執行原則。
信:確保資料品質可信賴
達:確保統計方法適切性
雅:確保圖文表格正規化
協助代執行統計分析與進一步加值服務。
在匯東華與夥伴的專業背景知識配合下,能有效地處理面對的問題。
統計分析成果

數據串接與清洗
數據是礦藏,數據清洗是挖出鑽石的第一步,尤其是巨量知識。數據清洗或串接執行過程需要細心與專注,且有可能會消耗許多時間和精力,就由我們來替各位處理掉這個大麻煩。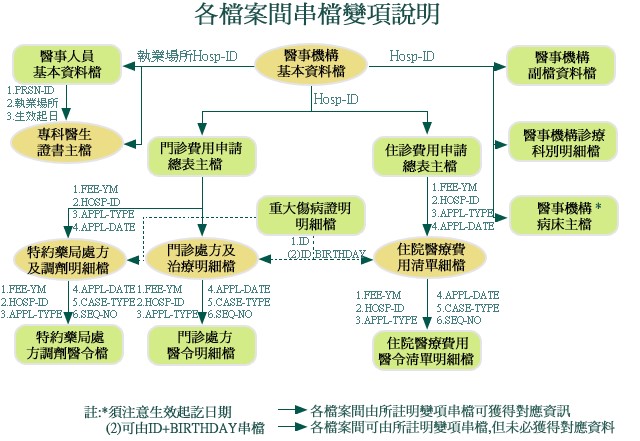
全民健保研究資料庫、國外大型資料庫資料非常齊全,種類多,需要串接與清洗,進行正規化後才能更進一步進行資料探勘與統計分析。
Fig1.同一個Project資料散落在不同tables,無法使用
Fig2.整併與清理為可分析的table
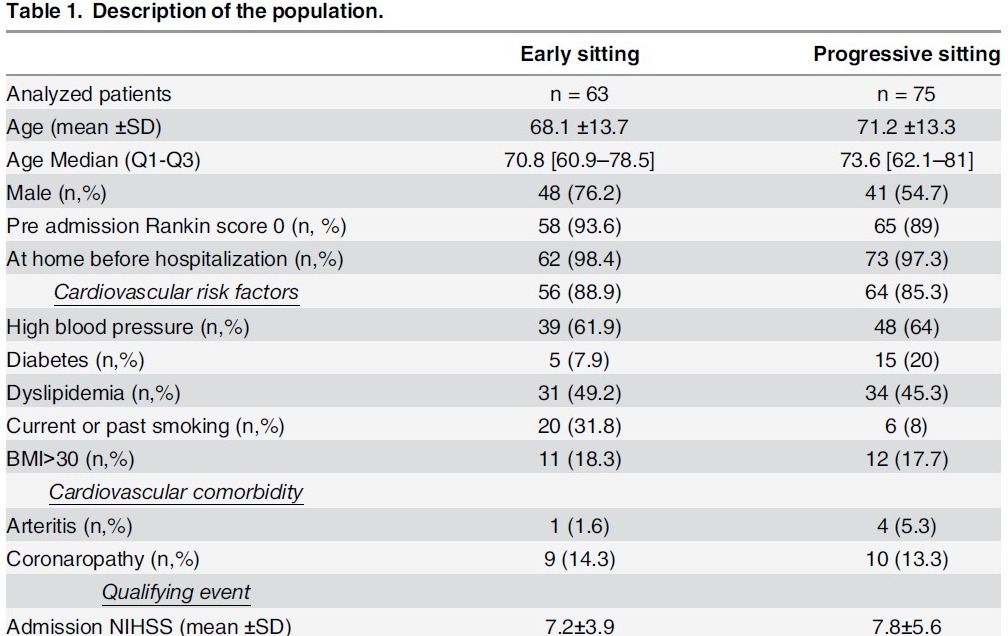
Fig.3整理和分析後形成有意義的知識
概念與流程示意圖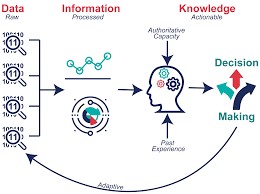

計畫撰寫與統計諮詢
為了讓匯東華的顧客與學員有更好的合作和消費體驗,故匯東華特別依據營業項目開發周邊產品,提供使用、購買。目前已有針對公共衛生師的題庫以及模擬試題,未來將針對醫學研究領域發展產品。