 匯東華統計顧問有限公司
(點擊圖片可開啟原圖放大檢視)
一頁先懂|核心判斷
讀懂一篇方法論文之後,要真正執行它的方法,中間還隔著一整段工程:找程式碼、裝套件、設定環境、弄懂輸入輸出。
史丹佛大學團隊 2026 年 9 月 16 日在《Nature》發表的 Paper2Agent,想把這一段自動化:由多個 AI 代理讀論文與程式碼、把分析步驟包成工具、用論文自己的範例資料逐一驗證,最後把論文變成一個可以用自然語言對話的 AI 智能體,由它呼叫這篇論文已驗證的工具。
作者在自己設計的測試題上,報告的正確率高於「讓 AI 直接讀程式碼庫」的做法;在 bioRxiv 上依時間往回抽出、未經篩選的 100 篇計算生物論文中,74 篇能自動轉換成功。
使用前要知道三件事:案例集中在基因體與單細胞分析;開放式的科學判斷,作者明說仍需要研究者自己負責;工具本身開源,但要搭配 AI 程式助理使用,費用依該助理的方案計。
01|讀得懂,和用得上,是兩件事
作者在前言用 AlphaGenome 當例子。這是一個預測 DNA 變異會如何影響基因調控的模型,功能強大,但要在程式裡使用它,得先安裝環境、用 API 金鑰建立連線物件、建構變異的輸入格式、選擇要輸出的資料類型,還要懂它的參數設計。原文的說法是,這對不熟悉這些抽象概念的生物學家是一條學習曲線。
這非 AlphaGenome 特有的問題。一篇論文描述新的計算方法,讀者往往要自己找到程式碼庫、安裝相依套件、設定環境、判斷正確的輸入輸出;即使程式碼維護得很好,過程通常也不簡單。
Paper2Agent 的想法是:與其讓每一位讀者各自走一遍,不如把這篇論文轉成一個可以對話的 AI 代理,由它代為執行論文的方法。作者把這個代理比作「虛擬的通訊作者」。
02|它怎麼做:把論文包成一個 MCP 伺服器
核心步驟為將論文做成一個 MCP 伺服器。MCP(Model Context Protocol)是一套標準規格,讓大型語言模型能用同一種格式找到並呼叫外部的工具與資料;作者指出它近來已成為連接 AI 代理與外部資源的業界標準。
每一個論文的 MCP 伺服器包含三部分:
- 工具:可以直接執行的分析功能,封裝論文的方法。例如 AlphaGenome 的一個工具,輸入一個基因變異,就輸出它對基因表現、染色質可及性等面向的預測與圖。
- 資源:論文全文、程式碼庫、補充資料與資料集等靜態資料。
- 提示:把論文中多步驟的分析流程寫成固定順序,引導 AI 依序完成。例如單細胞分析的前處理與分群,要按品質控制、標準化、特徵選取、降維、建圖、分群、細胞類型標註的順序進行。
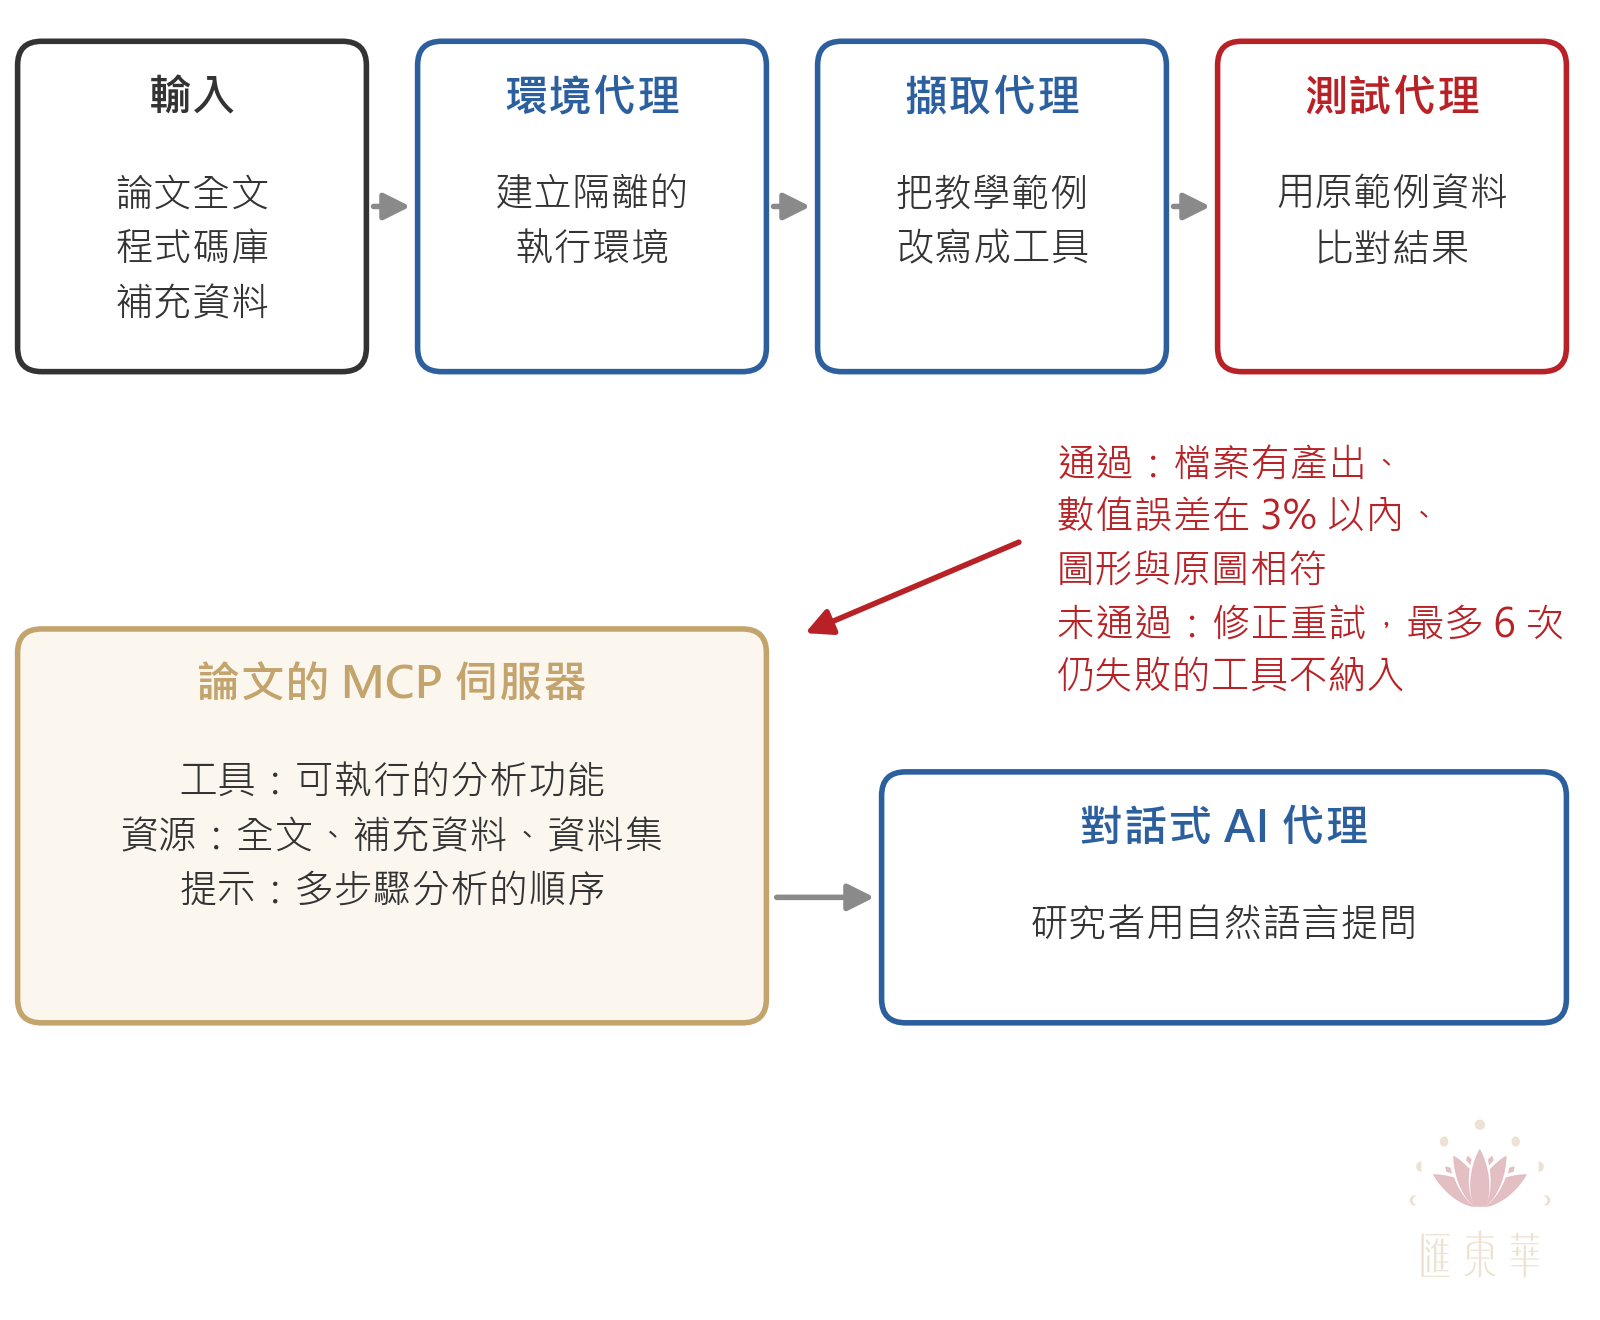
建立伺服器的工作,由幾個分工的 AI 代理完成(上方示意圖):
- 環境代理:為程式碼庫建立隔離、乾淨的執行環境
- 擷取代理:找出程式碼庫中的教學範例,把可以推廣到其他資料的步驟改寫成獨立的工具,並把寫死的檔案路徑、門檻值、欄位名稱改成參數
- 測試代理:用教學範例自己的資料當標準答案,逐一測試每個工具
完成的伺服器可以放在 Hugging Face 等遠端平台,任何相容的 AI 代理都能連上去使用。作者的實作以 Claude Code 為基礎,案例一律使用 Claude Sonnet 4 模型。
03|它怎麼防止 AI 算錯
讓 AI 寫程式執行分析,主要風險之一是它寫出看似合理、實際上有錯的程式碼,作者稱為「程式碼幻覺」。Paper2Agent 的主要防線是驗證後鎖定:
- 每個工具都要用原範例資料重現原本的結果。測試通過的條件為:預期的檔案有產生、數值結果與範例一致(浮點數容許 3% 誤差)、產生的圖與原圖相符(以影像雜湊比對)
- 未通過就診斷、修正、再測,每個工具最多嘗試 6 次;仍然失敗的工具直接排除,不放進伺服器
- 通過的工具被鎖定,確保結果可重現,也減少每次重新生成程式碼帶來的隨機性
- 每個工具都附上連回原論文程式碼的出處,可以追查
作者另執行下列檢查:把論文與問題隨機錯配,Paper2Agent 在本項測試中拒答 100% 與論文無關的問題;刻意在三個程式碼庫中植入缺少套件、路徑錯誤、拼字錯誤、過時函式四類錯誤,系統都能修復並產出可用的伺服器。
04|準不準?
(點擊圖片可開啟原圖放大檢視)
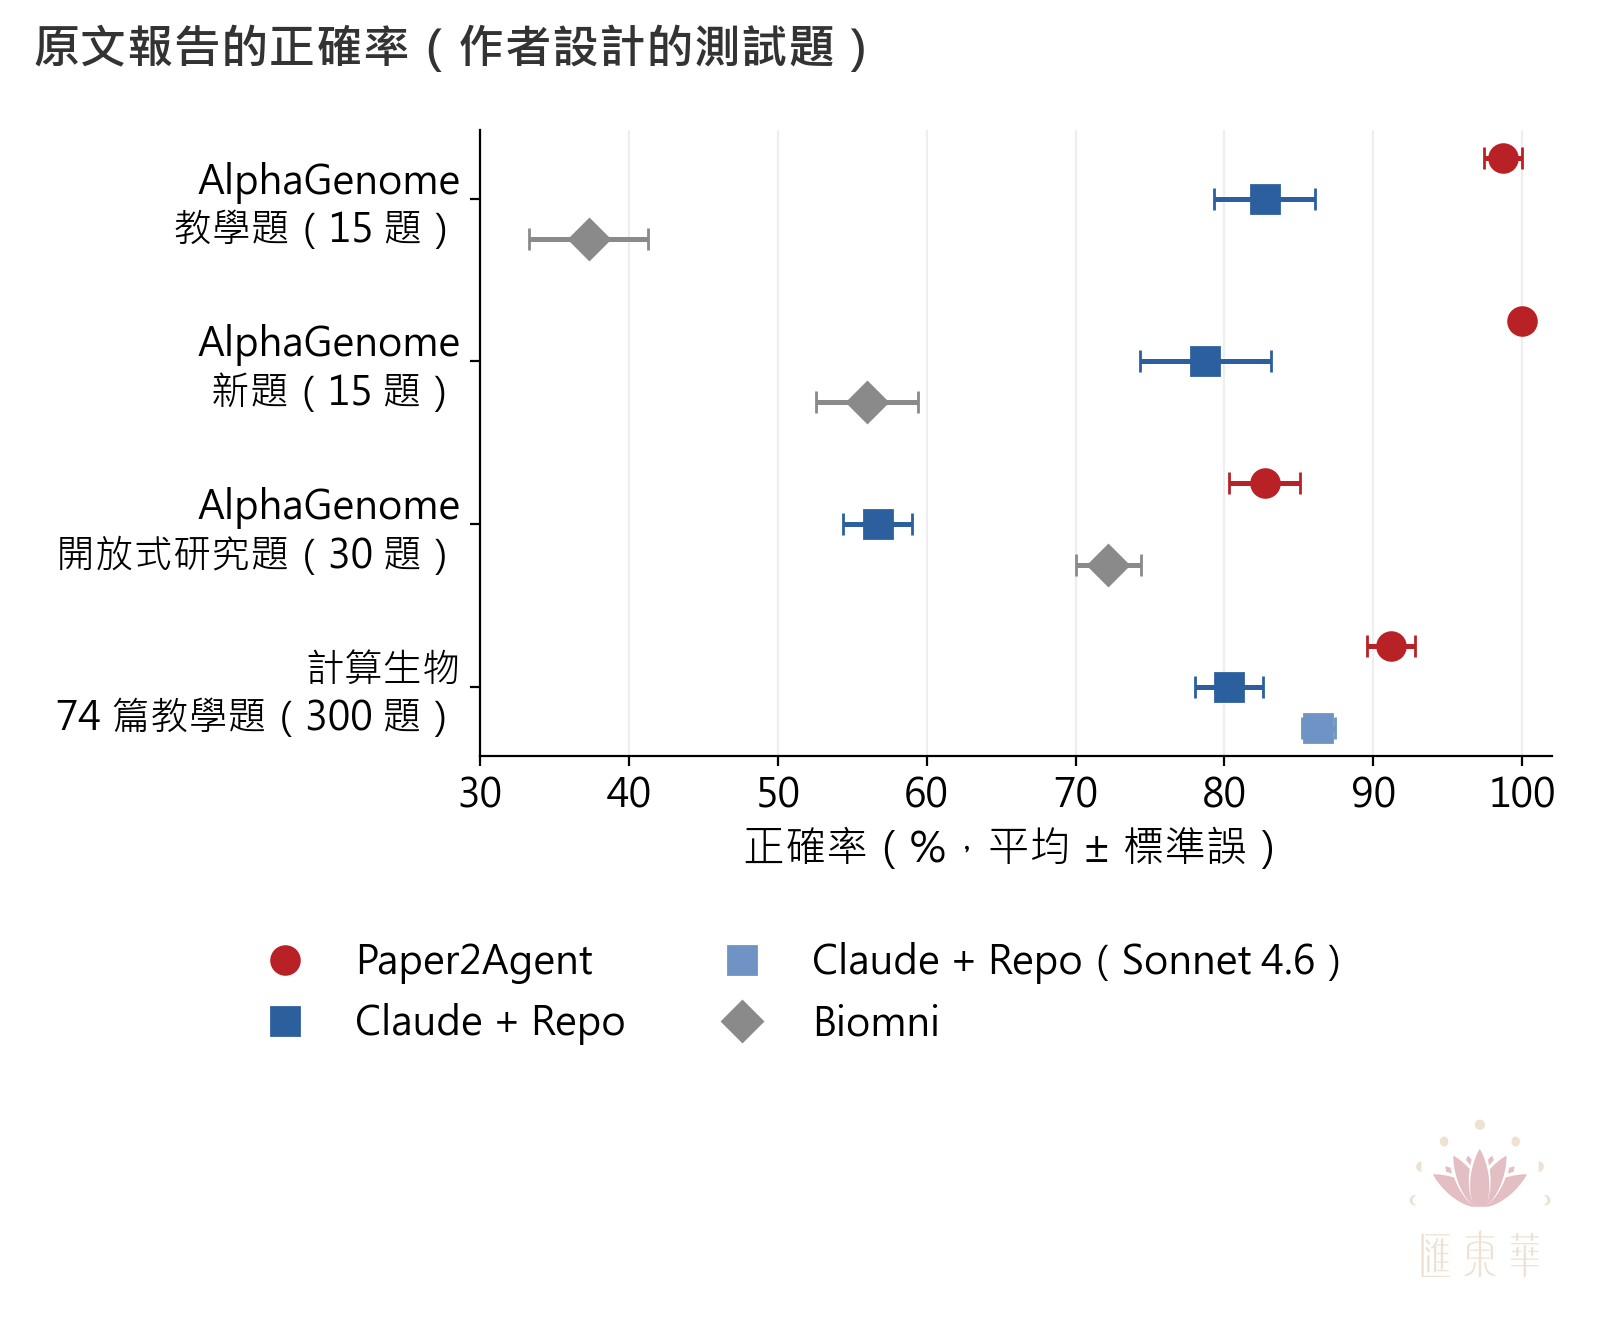
上圖每一列為一組測試題,每個點是一種做法的平均正確率,橫線是標準誤。紅色圓點是 Paper2Agent;藍色方塊是「Claude + Repo」,也就是讓 AI 程式助理直接讀取程式碼庫、自己寫程式回答;灰色菱形是另一個生物醫學 AI 代理 Biomni。
主要想了解同樣的問題,把論文先轉成驗證過的工具再回答,是否比讓 AI 直接讀程式碼更準。
怎麼看:四組題目中,紅點都在最右邊。和直接讀程式碼庫相比,差距最大的是開放式研究題(82.7% 對 56.7%),但同一組題目 Biomni 有 72.2%,差距就小得多;在 300 題的大規模測試中,把對照組換成較新的 Sonnet 4.6 模型後差距縮小,但仍在。
幾個具體數字:
- 建置成本:AlphaGenome 在個人筆電上約 45 分鐘、花費約 14 美元,產出 22 個工具,全部通過驗證;Scanpy 單細胞分析約 45 分鐘、約 13 美元,產出 7 個工具。
- 速度:AlphaGenome 代理的中位回答時間,比直接讀程式碼庫快 1.9 至 2.9 倍,比 Biomni 快 3.1 至 3.8 倍。
- 大規模測試:從 bioRxiv 生物資訊類別往回依序抽出 100 篇計算生物論文,事先沒有依程式碼品質篩選。其中 74 篇轉換成功,共提出 599 個工具,593 個通過驗證。每題花費約 0.20 美元、1.6 分鐘,直接讀程式碼庫則是 0.38 美元、4.3 分鐘。
- 非生物領域:10 篇 AI、統計、計量經濟、賽局、天文物理等領域的計算論文,42 題的正確率 98.1%。
- 沒有可執行程式碼的論文:26 篇以資料與發現為主的論文,只用資源層回答 100 題需要綜合全文與補充資料的問題,正確率 89.0%,高於讓 AI 直接瀏覽論文網頁的 82.0%,成本約為其三十四分之一。
評分方式也要知道:AlphaGenome 的測試題由兩位專家依事先訂好的評分準則獨立評分,兩人一致率 96.7%。
05|一個值得細看的例子:代理和原論文的結論不一樣
作者請 AlphaGenome 代理解釋一個與低密度脂蛋白膽固醇相關的基因變異。原本的 AlphaGenome 論文強調 CELSR2 與 PSRC1 兩個基因,代理卻把 SORT1 排為最可能的致病基因,理由是預測對 SORT1 表現的影響很極端,而 SORT1 編碼的蛋白直接參與脂蛋白分泌。作者再查公開的基因表現資料庫,確認這個變異與 SORT1 的表現有顯著關聯。
但作者也寫明:CELSR2 與 PSRC1 在同一套預測中的分數都是 0.99998,略高於 SORT1 的 0.99983,在同一資料庫中也都有顯著關聯(p.5)。一個變異同時與附近多個基因的表現相關時,要判定哪一個才是致病基因本來就很困難。
本例對使用者的意義是:代理給出一個答案,不代表是唯一合理的答案。作者把它看成一項優點:只要一句提示,就能用獨立的模型證據重新檢視已發表的結論;讀者在自己的研究裡遇到類似情況,仍需自己權衡。
另一個案例更明確地保留人的角色。作者讓三個論文代理合作,找出一個與乾癬相關變異的致病基因。AI 提出十種驗證策略,由研究者從中挑選一種執行;結果支持 GPR137,但只在 T 細胞受刺激的條件下顯著,靜止狀態下不顯著,每種條件分析的下游基因約 20 個(原文圖 4 圖說,p.8:n = 20、21、19)。
06|想自己試,需要什麼
以下依 2026 年 9 月 24 日查詢 Paper2Agent GitHub 專案頁與原文整理:
| 項目 | 內容 |
|---|---|
| 授權 | 程式碼以 MIT 授權開源(依 GitHub LICENSE 檔,查詢日期 2026-09-24),GitHub:jmiao24/Paper2Agent |
| 需要的環境 | 一個支援 skill、可執行 shell 並能平行啟動多個代理的 AI 程式助理(專案頁列出 Claude Code 與 Codex),以及 Python、Git;目標論文的程式碼若需要 R、GPU、API 金鑰等,也要另外準備 |
| 費用 | 工具本身免費;AI 程式助理依其本身方案計費。原文案例的建置花費約 13 至 14 美元,大規模測試中每題約 0.20 美元,這是作者在其設定下的數字 |
| 產出 | 一個含使用說明的壓縮檔,照說明連接到自己的 AI 程式助理 |
| 不自己建也能試 | 專案頁列出作者已部署在 Hugging Face 的 AlphaGenome、Scanpy、TISSUE 三個伺服器,可直接連接;查詢當日三個網址皆可連線。AlphaGenome 本身另需申請其 API 金鑰 |
| 版本差異 | 專案頁目前的安裝方式,是把 paper2agent 以 skill 形式裝進 AI 程式助理,包裝方式與論文方法段描述的流程不同;論文中的測試數字,是以論文所述版本與 Claude Sonnet 4 測得 |
(表格較寬,手機可左右滑動檢視)
對臨床研究者來說,可先連上現成的伺服器,用範例問題跑一次,體驗「用一句話呼叫一篇論文的方法」;若想把自己領域的論文轉成代理,需要該篇論文有公開、可執行的程式碼。
07|作者自己承認的限制
原文討論段把限制寫得很清楚,以下逐項整理:
- 不是每篇論文都轉得成功。 大規模測試中 100 篇有 26 篇失敗,常見原因是沒有可執行的程式碼、缺少資料或模型檔、環境或相依套件無法解決、腳本無法推廣到其他資料。作者認為,一篇論文能否順利轉成代理,本身可能就是可重現性的實務指標。
- 開放式的科學推理仍需要人。 作者強調,產生假說、解釋機制這類工作仍需研究者參與;研究者要負責選擇方向、評估證據。作者把 Paper2Agent 定位為輔助發現、提升可近性與重現性的工具,不是自主或權威的科學結論來源。
- 正確率量的是「忠實執行」。 開放式問題可能有多個候選答案;以單一標準答案比對的測試,主要反映 AI 忠實執行原方法程度,不等於分析本身在科學上有效。
- 需要持續維護。 上游程式碼與相依套件會更新,論文代理也需跟著維護。
- 資安、智慧財產與歸屬。 把研究程式碼開放成可執行的代理,會帶來資安、智慧財產與貢獻歸屬的問題,需要審慎處理。
另外兩點是我們讀原文時的觀察:原文詳細展示的案例都屬基因體學、單細胞與空間轉錄體分析,大規模測試雖納入統計與計量經濟的計算套件,但原文正文未展示臨床試驗或流行病學分析的案例;測試題與評分準則由作者團隊設計,原文未包含外部團隊的獨立評估。
結語|先把論文當成可以驗證的工具
Paper2Agent 最值得借鏡的,不是「AI 會替你做分析」,是它處理可靠性的方式:每個工具都先用論文自己的資料驗證,驗證不過就不上線。
作者在討論段預期,未來期刊可能在「資料可得性」「程式碼可得性」之外,再加一個「代理可得性」段落。在那之前,研究者能做的事很具體:公開可以執行的程式碼、附上帶有預期結果的範例資料,讓別人(以及 AI)能重現你的結果。
能被 AI 重現的論文,先得是能被人重現的論文。
參考文獻
- Miao, Jiacheng, Joe R. Davis, Yaohui Zhang, Jonathan K. Pritchard, and James Zou. "Reimagining Research Papers as Interactive and Reliable AI Agents." Nature, published online 16 Sept. 2026. DOI: 10.1038/s41586-026-11044-y
- Paper2Agent GitHub 專案頁. https://github.com/jmiao24/Paper2Agent(查詢日期:2026 年 9 月 24 日)
AI 使用聲明
本文由匯東華統計顧問有限公司 陳秀敏 博士撰稿,Claude Opus 5.5 協助原文整理、引用核對、示意圖繪製與版面排版,最終內容已由作者審閱定稿。文中數字與限制之資料來源為上列原文,逐項對照原文頁碼;使用門檻依查詢當日之 GitHub 專案頁。兩張圖皆為本公司依原文機制與數字自行繪製(Python 輸出),未使用原文圖片。日期:2026 年 10 月 2 日。
同期其他單元
- 統計方法實務|醫學研究常見統計錯誤
- 研究誠信與 AI 治理系列 No. 05|大型語言模型於醫療與醫學的倫理考量
匯東華電子報 第 6 期|2026.10.02|看本期網頁版 →
聯絡我們
- LINE:@medatatw
- Email:info@medatatw.com
- 電話:07-9721586
- 官網:www.medatatw.com

統計分析
服務價目表 (未含5%營業稅)
透過嚴謹的數據整理,提供有價值的資訊,形塑知識,提高決策品質。包括信達雅三執行原則。
信:確保資料品質可信賴
達:確保統計方法適切性
雅:確保圖文表格正規化
協助代執行統計分析與進一步加值服務。
在匯東華與夥伴的專業背景知識配合下,能有效地處理面對的問題。
統計分析成果

數據串接與清洗
數據是礦藏,數據清洗是挖出鑽石的第一步,尤其是巨量知識。數據清洗或串接執行過程需要細心與專注,且有可能會消耗許多時間和精力,就由我們來替各位處理掉這個大麻煩。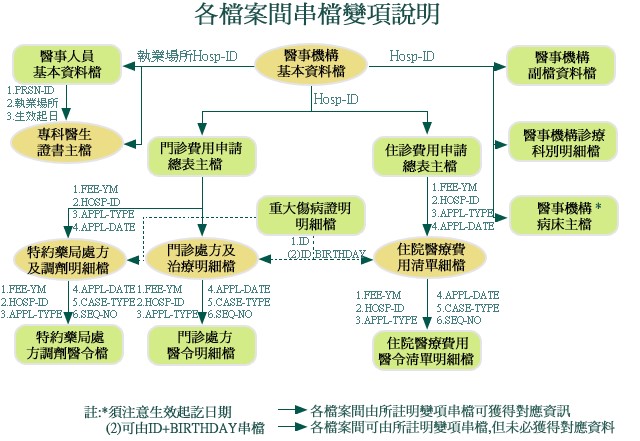
全民健保研究資料庫、國外大型資料庫資料非常齊全,種類多,需要串接與清洗,進行正規化後才能更進一步進行資料探勘與統計分析。
Fig1.同一個Project資料散落在不同tables,無法使用
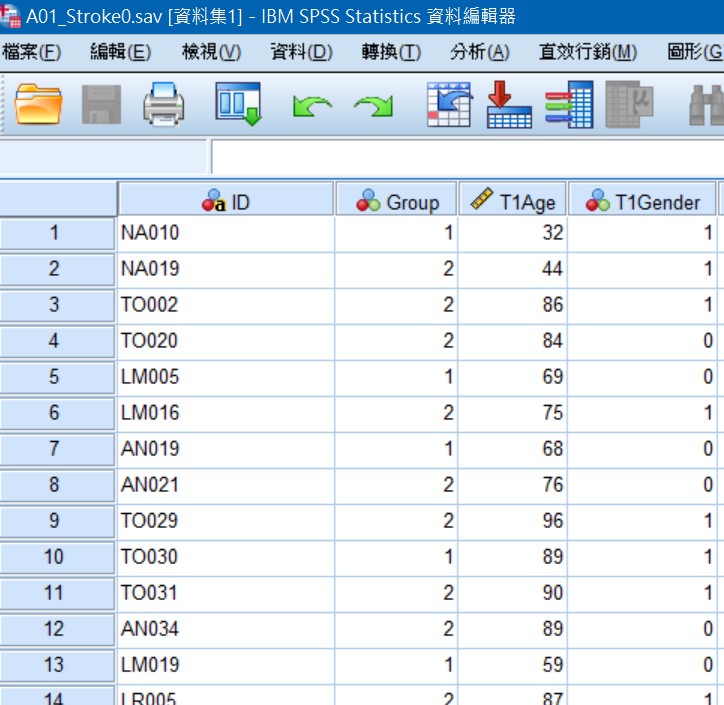
Fig2.整併與清理為可分析的table
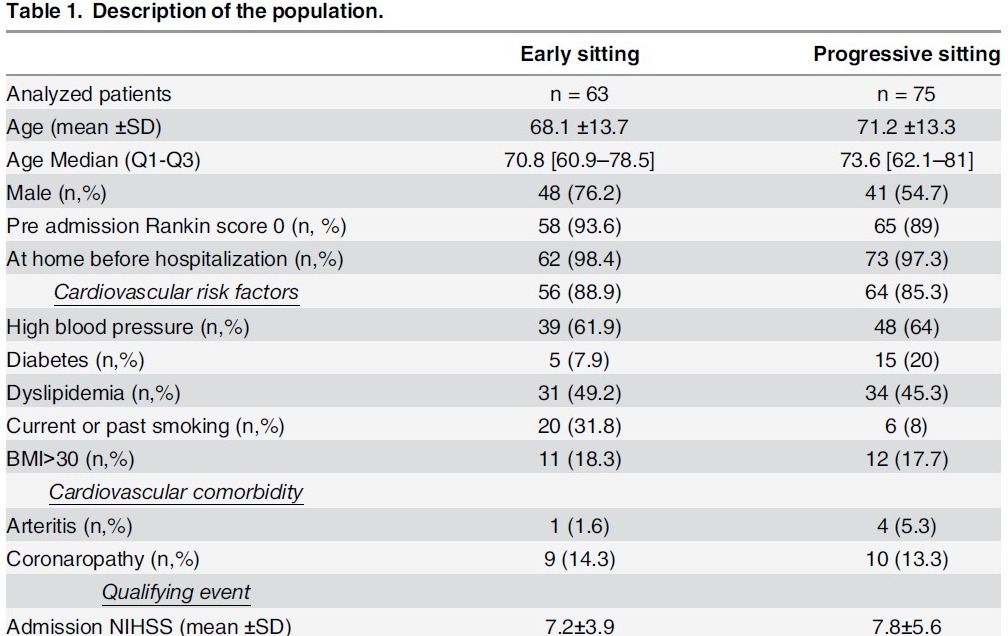
Fig.3整理和分析後形成有意義的知識
概念與流程示意圖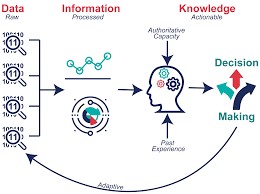

計畫撰寫與統計諮詢
為了讓匯東華的顧客與學員有更好的合作和消費體驗,故匯東華特別依據營業項目開發周邊產品,提供使用、購買。目前已有針對公共衛生師的題庫以及模擬試題,未來將針對醫學研究領域發展產品。