 匯東華統計顧問有限公司
匯東華電子報 第 3 期|方法論問答|2026.08.21
一頁先懂|核心判斷
假設我們想知道:加班時數是否增加護理人員的疲勞,而且這個關係會不會因主管支持程度不同而改變?
在線性迴歸中,可以建立:
疲勞 = 加班時數 + 主管支持 + 加班時數 × 主管支持
如果分析結果發現:
- 加班時數 × 主管支持顯著
- 主管支持的迴歸係數不顯著
主管支持還要不要留在模型裡?
原則上要留。
原因並不是「統計上習慣這樣做」,而是只要模型中保留交互項,構成交互項的低階項通常也應保留。這是迴歸模型中的 marginality principle(邊際性原則),也常被稱為 hierarchical principle。
更重要的是:
在含有交互作用的模型中,「主管支持不顯著」並不代表主管支持沒有作用。
它只代表:當加班時數等於 0 時,主管支持與疲勞之間的條件關係沒有達到統計顯著。
而「主管支持是否會改變加班與疲勞的關係」,回答這件事的是交互項。
這兩個問題不同,不能用其中一個的 p 值回答另一個。
01|交互作用顯著,為什麼低階項還要留?
以下以最常見的情況為例:結果變數、主要自變數與調節變數皆為連續變數,使用線性迴歸分析。
模型可以寫成:
疲勞 = β₀ + β₁(加班) + β₂(主管支持) + β₃(加班 × 主管支持) + ε
其中:
- β₁:主管支持 = 0 時,加班與疲勞的關係
- β₂:加班 = 0 時,主管支持與疲勞的關係
- β₃:主管支持每增加一個單位,加班與疲勞之間的斜率改變多少
關鍵在 β₃。
如果 β₃ 顯著,代表:
加班與疲勞之間的關係,不是一條固定的線;它會隨主管支持程度而改變。
既然我們的模型主張「這條斜率會隨主管支持而改變」,就必須同時保留用來定義這個關係的低階項。
Nelder(1977)所討論的 marginality principle,以及 Peixoto(1987, 1990)對 well-formulated models 的討論,都支持這項建模原則。
因此,不能因為 β₂ 的 p 值大於 .05,就把主管支持從模型刪除,只留下:
疲勞 = β₀ + β₁(加班) + β₃(加班 × 主管支持)
這樣做並不是單純「讓模型更精簡」。
它實際上對模型加入了一個額外限制:
當加班 = 0 時,主管支持的效果被強迫設定為 0。
除非這項限制是由研究理論或機制事先明確要求,否則不能只因為一個 p 值不顯著,就在分析完成後把它強加進模型。
三條線:同樣的加班,不同的疲勞增幅
把加班時數放在橫軸、疲勞程度放在縱軸,再依主管支持程度分成三組,會看到三條斜率不同的線:
- 主管支持較低:加班愈多,疲勞上升得最快
- 主管支持平均:中度上升
- 主管支持較高:上升幅度最小
交互作用要表達的正是這件事:重點不是哪一條線比較高,而是三條線的斜率不一樣。
而完整的模型由三個部分共同構成:加班時數、主管支持,以及兩者的乘積項。三者共同定義這個交互作用模型,不應依個別 p 值任意拆除。
交互作用的核心不是「某一個變項有沒有作用」,而是「一個變項的效果是否會隨另一個變項而改變」。
02|「主管支持不顯著」到底代表什麼?
這是交互作用分析最常見的誤讀。
假設 β₂ 的 p 值 > .05,很多研究者會直接寫:
「主管支持與疲勞沒有顯著關係。」
這個說法通常太廣。
因為加入交互項之後,β₂ 已經不是「主管支持在所有人身上的平均效果」。
它回答的是:
當加班時數 = 0 時,主管支持與疲勞之間的關係是多少?
同理,β₁ 也不是「加班的整體效果」,而是:
當主管支持 = 0 時,加班與疲勞之間的關係是多少?
因此,在交互作用模型中,這些低階項更精確的名稱應該是條件效果(conditional effects),而不是不附帶條件地解讀為一般性的「主效果」。
| 模型中的係數 | 真正回答的問題 |
|---|---|
| 加班時數 β₁ | 當主管支持 = 0 時,加班與疲勞如何相關? |
| 主管支持 β₂ | 當加班 = 0 時,主管支持與疲勞如何相關? |
| 加班 × 主管支持 β₃ | 主管支持改變時,加班與疲勞的斜率會改變多少? |
這也解釋了一個看似矛盾、其實完全合理的結果:
主管支持的 β₂ 不顯著,但交互項 β₃ 顯著。
兩者可以同時成立。
例如:
在完全沒有加班的護理人員中,主管支持與疲勞的差異並不明顯;但是隨著加班增加,主管支持較高者的疲勞增加幅度較小。
後半句才是這項研究真正重要的調節結果。
因此,不能因為 β₂ 不顯著,就在 Discussion 中寫成:
「主管支持對疲勞沒有作用。」
資料並沒有回答這麼大的問題。
03|先問一件事:模型中的「0」到底代表誰?
理解交互作用模型,最容易被忽略的就是「0」。
前面的例子中,「加班 = 0 小時」具有明確意義:確實可能有護理人員在觀察期間完全沒有加班。
但其他變數不一定如此。
假設研究的是:
- 年齡
- 工作年資
- 某份量表總分
- 生理指標
那麼 β₂ 可能代表:
年齡 = 0 歲時,主管支持的效果。
數學上可以計算。
但研究上未必有任何意義。
因此,在解讀交互作用模型以前,應先問:
- 0 是否落在實際資料範圍內?
- 0 是否具有臨床、研究或管理上的意義?
如果答案是否定的,那麼低階項即使有一個非常漂亮的 p 值,也可能沒有值得報導的實質意義。
這時,中心化才真正派上用場。
04|中心化的主要價值:讓「0」變得可以解釋
最常見的做法是 mean centering:
中心化後的加班時數 = 原始加班時數 − 平均加班時數
中心化後的主管支持 = 原始主管支持 − 平均主管支持
如此一來:
中心化後的 0 = 原始變數的平均值。
模型中的 β₁ 就會變成:
在「平均主管支持程度」下,加班與疲勞的關係。
β₂ 則變成:
在「平均加班時數」下,主管支持與疲勞的關係。
通常比「主管支持 = 0」或其他不具實質意義的零點容易解釋。
但中心化不會把交互作用變得更顯著
這也是常見誤解。
在線性迴歸且模型包含相同低階項與乘積項的情況下,重新設定零點並不改變模型的整體配適,也不改變交互項所代表的實質關係。
因此,中心化的核心目的不是:
「把共線性修好」
也不是:
「讓 p 值變漂亮」
而是:
重新設定參照點,使低階係數回答一個比較有意義的問題。
Kromrey 與 Foster-Johnson(1998)以及 Echambadi 與 Hess(2007)都曾針對 mean centering 與 moderated regression 中的 collinearity 問題提出重要澄清。
還有一個現象很容易造成誤會:
中心化後,某個低階項可能從不顯著變成顯著,或從顯著變成不顯著。
這不表示「中心化改善了模型」。
而是因為檢定問題已經改變。
例如原本問的是:
加班 = 0 時,主管支持是否與疲勞相關?
中心化後問的則是:
加班處於平均程度時,主管支持是否與疲勞相關?
兩個不同問題,本來就可能得到不同答案。
05|交互作用顯著,分析還沒有結束
交互項的 p 值顯著,只告訴我們:
斜率會改變。
它並沒有告訴我們:
- 往哪個方向改變?
- 改變多大?
- 在哪些主管支持程度下,加班與疲勞的關係明顯?
- 是否具有實務意義?
因此,交互作用顯著後,至少應進一步做交互作用探測(probing the interaction)。
最常見的兩種方法是 simple slopes 與 Johnson–Neyman method。
Simple slopes:在幾個具有意義的條件下估計斜率
例如分別估計:
- 主管支持較低時
- 主管支持平均時
- 主管支持較高時
加班每增加 1 小時,疲勞平均增加多少。
常見的 ±1 SD 只是其中一種選點方法,不是必須遵守的自然定律。
如果 ±1 SD 超出量表範圍或落在幾乎沒有觀察值的位置,就不宜機械式使用。更好的做法是選擇位於實際資料範圍內,且具有臨床或管理意義的值。
Johnson–Neyman:直接找出效果在哪個範圍出現
Johnson–Neyman method 的問題不同。
它不是先指定「高、中、低」三個點,而是尋找:
主管支持在哪些觀察範圍內,加班與疲勞的條件效果達到指定的統計顯著水準?
對連續型調節變數而言,這通常能提供比任意切成三組更完整的資訊。
但無論使用哪一種方式,都應同時呈現交互作用圖。
因為交互作用本質上是在解讀「斜率如何變化」,只報 β₃ 與 p 值,很難讓讀者真正理解結果。
06|論文與研究報告,至少應呈現什麼?
這類分析不需要把報表塞滿所有可能指標,但有幾項資訊不能缺。
完整模型
至少報告:
- 主要自變數
- 調節變數
- 交互項
不要只留下顯著項。
迴歸係數與不確定性
對各係數報告:
- β 或 B
- SE
- 95% CI
- p 值
不要讓 p 值成為唯一資訊。
這不只是我們的建議。美國心理學會的量化研究報告準則 JARS(Appelbaum 等人,2018)要求,在可行時報告與每個推論檢定相對應的效應量及其信賴區間。醫學領域的 CONSORT 2010 聲明(Schulz、Altman、Moher 等,2010)同樣要求,對每個主要與次要結果報告各組結果、估計的效應量及其精確度,例如 95% 信賴區間。
對交互作用來說這特別重要。交互作用本來就不容易測到,只給 p 值,讀者無從判斷「不顯著」到底是效果小、樣本不夠,還是量表不夠可靠。
交互作用所增加的模型解釋力
在線性迴歸的階層建模情境下,可以報告加入交互項後的:
ΔR²
但 ΔR² 很小而 p < .05 時,也不應因為「統計顯著」就忽略實際效果可能有限。
清楚說明變數處理方式
例如:
Continuous predictors were mean-centered before construction of the interaction term.
如果有類別變數,則應說明:
- 編碼方法
- reference group
交互作用探測與圖形
至少提供:
- simple slopes 或其他具實質意義條件下的 conditional effects
- 95% CI
- 交互作用圖
如果使用 Johnson–Neyman method,也應標示實際觀察範圍,避免讀者把資料之外的推估當成實證結果。
07|一個最常見、也最值得避免的分析流程
錯誤流程通常是:
建立交互作用模型
↓
看到主管支持 p > .05
↓
刪除主管支持
↓
留下顯著的「加班 × 主管支持」
↓
宣稱主管支持具有調節效果
問題出現在第三步。
低階項不是因為「自己顯不顯著」才決定是否存在。
只要交互作用仍然是研究問題的一部分,低階項原則上就屬於該模型結構的一部分。
比較合理的流程是:
事前提出調節假設
↓
建立完整模型
↓
檢驗交互項
↓
保留構成交互項的低階項
↓
若交互作用成立,進行 simple slopes / Johnson–Neyman
↓
結合圖形、效果估計與 95% CI 解讀
這樣的分析才能讓「統計模型」與「研究問題」維持一致。
結語|不要用低階項的 p 值,決定交互作用模型的結構
交互作用分析最容易犯的錯,並不是忘記把兩個變數相乘。
而是把一般迴歸中熟悉的 p 值判讀方式,直接套進含有交互作用的模型。
一旦模型中存在交互作用,低階係數就具有條件性。
「主管支持不顯著」不等於:
主管支持沒有作用。
它只是在特定參照點下回答一個特定問題。
真正的調節問題則是:
主管支持改變時,加班與疲勞之間的關係是否也跟著改變?
這才是交互項負責回答的問題。
因此,這篇方法論問答最重要的一句話是:
當交互項留在模型中,構成交互項的低階項通常也應保留;不是為了讓它們自己的 p 值好看,而是為了讓整個交互作用模型仍然具有可解釋的統計意義。
投稿前快速檢核
- 交互項及其構成的低階項是否都保留在模型中?
- 是否避免把低階係數直接解讀成無條件的「整體主效果」?
- 模型中的 0 是否位於合理且可解釋的範圍?
- 若進行中心化,是否說明中心化方法與參照點?
- 是否沒有把中心化描述成「解決共線性」的必要手段?
- 交互作用顯著後,是否進一步報告 conditional effects 或 simple slopes?
- 是否提供交互作用圖與 95% CI?
- 若交互作用未達顯著,是否寫成「本研究未發現顯著交互作用」,而非「證明不存在交互作用」?
參考文獻
- Nelder, J. A. “A Reformulation of Linear Models.” Journal of the Royal Statistical Society. Series A (General), vol. 140, no. 1, 1977, pp. 48–77. doi:10.2307/2344517.
- Peixoto, Julio L. “Hierarchical Variable Selection in Polynomial Regression Models.” The American Statistician, vol. 41, no. 4, 1987, pp. 311–313. doi:10.1080/00031305.1987.10475506.
- Peixoto, Julio L. “A Property of Well-Formulated Polynomial Regression Models.” The American Statistician, vol. 44, no. 1, 1990, pp. 26–30. doi:10.1080/00031305.1990.10475687.
- Aiken, Leona S., and Stephen G. West. Multiple Regression: Testing and Interpreting Interactions. Sage Publications, 1991.
- Braumoeller, Bear F. “Hypothesis Testing and Multiplicative Interaction Terms.” International Organization, vol. 58, no. 4, 2004, pp. 807–820. doi:10.1017/S0020818304040251.
- Brambor, Thomas, William Roberts Clark, and Matt Golder. “Understanding Interaction Models: Improving Empirical Analyses.” Political Analysis, vol. 14, no. 1, 2006, pp. 63–82. doi:10.1093/pan/mpi014.
- Kromrey, Jeffrey D., and Lynn Foster-Johnson. “Mean Centering in Moderated Multiple Regression: Much Ado about Nothing.” Educational and Psychological Measurement, vol. 58, no. 1, 1998, pp. 42–67. doi:10.1177/0013164498058001005.
- Echambadi, Raj, and James D. Hess. “Mean-Centering Does Not Alleviate Collinearity Problems in Moderated Multiple Regression Models.” Marketing Science, vol. 26, no. 3, 2007, pp. 438–445. doi:10.1287/mksc.1060.0263.
- Bauer, Daniel J., and Patrick J. Curran. “Probing Interactions in Fixed and Multilevel Regression: Inferential and Graphical Techniques.” Multivariate Behavioral Research, vol. 40, no. 3, 2005, pp. 373–400. doi:10.1207/s15327906mbr4003_5.
- Preacher, Kristopher J., Patrick J. Curran, and Daniel J. Bauer. “Computational Tools for Probing Interactions in Multiple Linear Regression, Multilevel Modeling, and Latent Curve Analysis.” Journal of Educational and Behavioral Statistics, vol. 31, no. 4, 2006, pp. 437–448. doi:10.3102/10769986031004437.
- Dawson, Jeremy F. “Moderation in Management Research: What, Why, When, and How.” Journal of Business and Psychology, vol. 29, no. 1, 2014, pp. 1–19. doi:10.1007/s10869-013-9308-7.
- Hayes, Andrew F. Introduction to Mediation, Moderation, and Conditional Process Analysis: A Regression-Based Approach. 3rd ed., Guilford Press, 2022.
- Appelbaum, Mark, Harris Cooper, Rex B. Kline, Evan Mayo-Wilson, Arthur M. Nezu, and Stephen M. Rao. “Journal Article Reporting Standards for Quantitative Research in Psychology: The APA Publications and Communications Board Task Force Report.” American Psychologist, vol. 73, no. 1, 2018, pp. 3–25. doi:10.1037/amp0000191.
- Schulz, Kenneth F., Douglas G. Altman, David Moher, and the CONSORT Group. “CONSORT 2010 Statement: Updated Guidelines for Reporting Parallel Group Randomised Trials.” BMJ, vol. 340, 2010, c332. doi:10.1136/bmj.c332.
匯東華統計顧問有限公司|Medata Research Methodology
智。數據決策|專業 × 效率 × 熱忱 × 創新 × 永續
本文由匯東華統計顧問有限公司 陳秀敏 博士撰稿,Claude Opus 5 協助資料查證與排版,最終內容已由作者審閱定稿。日期:2026 年 8 月 21 日。
同期其他單元
- 本期重點|一篇統合分析被撤下來,通常是哪裡出了問題?
- 專欄|AI 讓人去技能化
- 本期工具|Elicit:用研究問題找證據,把文獻整理成一張可核對的表
匯東華電子報 第 3 期|2026.08.21|看本期網頁版 →
聯絡我們
- LINE:@medatatw
- Email:info@medatatw.com
- 電話:07-9721586
- 官網:www.medatatw.com

統計分析
服務價目表 (未含5%營業稅)
透過嚴謹的數據整理,提供有價值的資訊,形塑知識,提高決策品質。包括信達雅三執行原則。
信:確保資料品質可信賴
達:確保統計方法適切性
雅:確保圖文表格正規化
協助代執行統計分析與進一步加值服務。
在匯東華與夥伴的專業背景知識配合下,能有效地處理面對的問題。
統計分析成果

數據串接與清洗
數據是礦藏,數據清洗是挖出鑽石的第一步,尤其是巨量知識。數據清洗或串接執行過程需要細心與專注,且有可能會消耗許多時間和精力,就由我們來替各位處理掉這個大麻煩。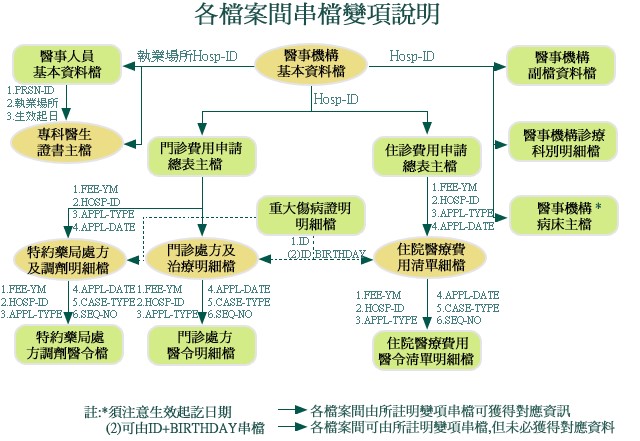
全民健保研究資料庫、國外大型資料庫資料非常齊全,種類多,需要串接與清洗,進行正規化後才能更進一步進行資料探勘與統計分析。
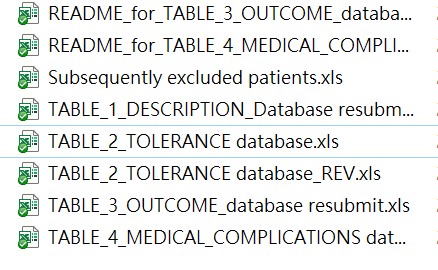
Fig1.同一個Project資料散落在不同tables,無法使用
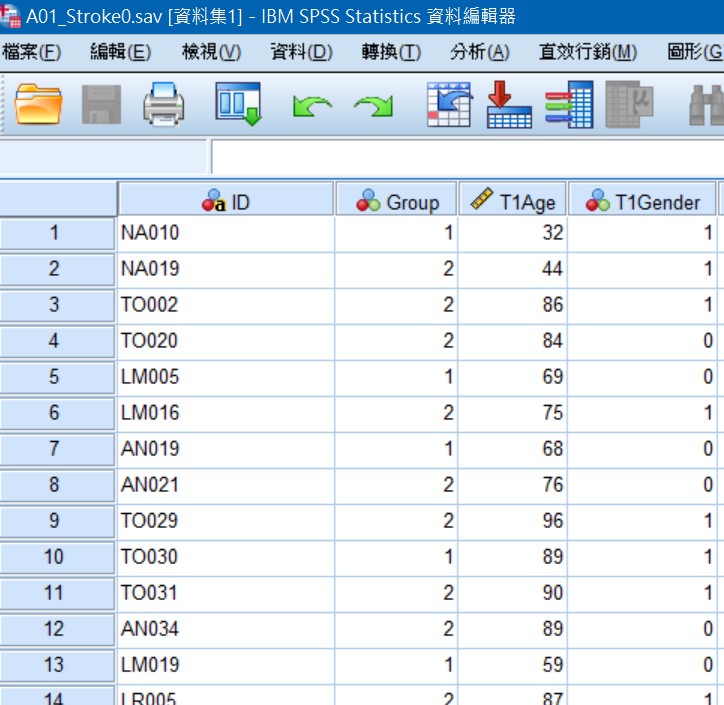
Fig2.整併與清理為可分析的table
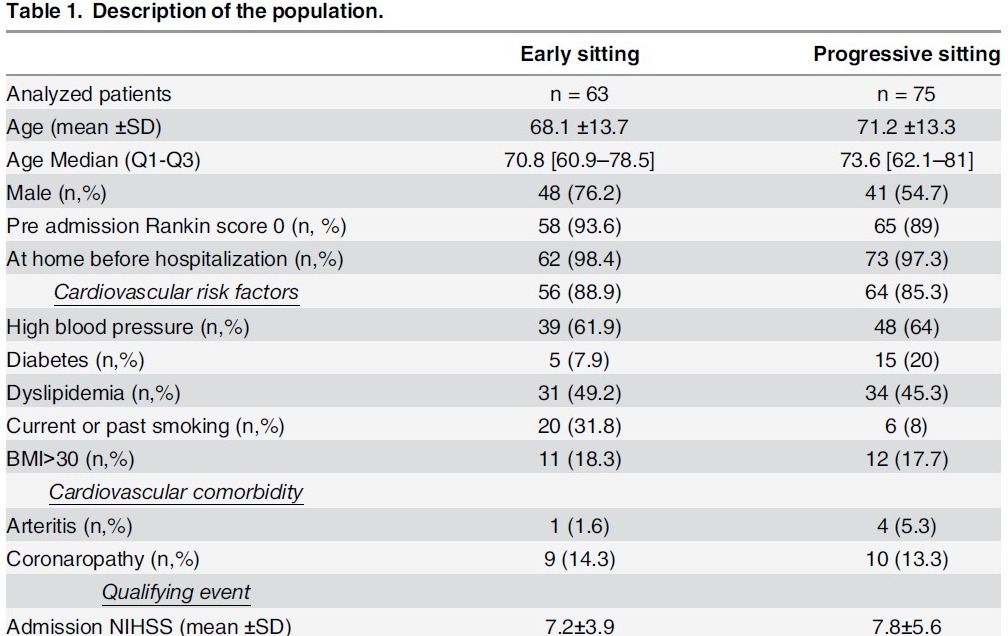
Fig.3整理和分析後形成有意義的知識
概念與流程示意圖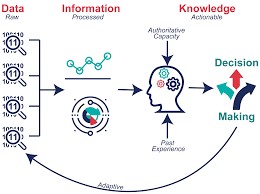

計畫撰寫與統計諮詢
為了讓匯東華的顧客與學員有更好的合作和消費體驗,故匯東華特別依據營業項目開發周邊產品,提供使用、購買。目前已有針對公共衛生師的題庫以及模擬試題,未來將針對醫學研究領域發展產品。