 匯東華統計顧問有限公司
一、它解決什麼問題
做過文獻回顧的人都熟悉這個場景。
你心裡有一個很清楚的研究問題,例如「短期高強度間歇訓練對第二型糖尿病患者糖化血色素的影響」。但你不能把這句話直接丟進資料庫,你得先把它翻譯成資料庫聽得懂的語言:拆成概念、找同義詞、查 MeSH 詞、組布林邏輯、決定要不要截斷。
這個翻譯過程本身就是專業,而它的代價是:
你的檢索結果,取決於你有沒有想到那個關鍵字。
漏掉一個同義詞,可能就漏掉一整批文獻。跨領域的題目更麻煩,因為同一個概念在不同學門有不同慣用語。做過系統性回顧的人都知道,檢索策略往往要反覆修改十幾輪,還是不確定有沒有漏。
語意檢索(semantic search)處理的就是這一段。它不比對字串,而是比對意義:把研究問題與論文內容都轉成向量,再找出概念相近的文獻,即使兩者用字完全不重疊。官方對這件事的說法很直白:
Elicit's semantic search means you don't have to know all the right keywords to get relevant results.
Elicit 的語意檢索意味著,你不必知道所有正確的關鍵字,也能得到相關結果。
Elicit 是目前把這個路線做得最完整的商業產品之一。官方對自己的定位是一句話:
Elicit helps researchers be 10x more evidence-based
讓研究者的證據基礎強十倍。
除了「找得到」,它真正省時的地方在後面一段:把找到的論文,自動整理成一張可以逐格核對的表。
二、它能做什麼、怎麼用
官方目前的六項功能
官方網站首頁的 FEATURES 一節,目前將功能分為六項:
| 功能 | 官方描述(節錄) | 適合的情境 |
|---|---|---|
| Research agent | 「為高風險決策與嚴謹研究流程而建」;跨科學資料庫、學術期刊、公開資料來源與你自行上傳的文件蒐集證據,產出附完整引用的報告、表格、圖表與投影片 | 需要跨來源整合、且結論要能追溯的題目 |
| Search | 「搜尋逾 1.38 億篇學術論文與 545,000 筆臨床試驗,更多資料來源即將加入」 | 起手式:用研究問題找文獻 |
| Research reports | 「依受系統性回顧啟發的流程產生高品質研究簡報」;且「與其他 AI 工具不同,Elicit 報告可深度客製,你可以更改報告涵蓋哪些論文、涵蓋什麼資訊」 | 快速建立研究背景、寫前言 |
| Systematic literature review | 「可自動化系統性回顧的篩選與資料萃取,並部分支援檢索與報告生成」 | 正式的系統性回顧與統合分析 |
| Library | 儲存與整理你找到的來源,方便日後專案重複使用 | 文獻管理 |
| Alerts | 追蹤新研究而不塞爆信箱 | 長期追蹤某個題目 |
其中 Research agent 是 2026 年 8 月推出的現行主打。
從研究問題到一張表:實際怎麼跑
第一步,用問題檢索。 不要輸入關鍵字組合,直接輸入研究問題本身。免費方案即可無限次搜尋。
第二步,設定要抓什麼欄位。 這是與傳統資料庫最大的差別。你可以指定要從每篇論文抓出哪些欄位(樣本數、介入方式、追蹤時間、主要結果、study design 等),系統逐篇填成一張表。欄位數依方案而定:Plus 一次 5 欄、Pro 一次 20 欄、Scale 一次 30 欄、Enterprise 一次 40 欄。
對做系統性回顧的人來說,這一段最花時間。
第三步,逐格核對回原文。 這一步不能省,理由見第四節與第六節。
第四步,輸出與接續。 Plus 以上可匯出 RIS、CSV、BIB、PDF、DOCX;免費方案即可自 Zotero 匯入;Pro 以上提供 API。這代表它可以接進你既有的文獻管理與分析流程,不必被綁在單一介面裡。
所有 AI 生成的主張都附上句子層級的來源引用,查核時可以直接跳回它是根據哪一句話下的結論。
資料從哪裡來
這是評估任何檢索工具的第一個問題。官方說明:
Elicit searches across over 138 million academic papers from Semantic Scholar, PubMed, and OpenAlex. This covers all academic disciplines.
Elicit 搜尋來自 Semantic Scholar、PubMed 與 OpenAlex 的 1 億 3,800 萬篇以上學術論文,涵蓋所有學術領域。
另可直接檢索 ClinicalTrials.gov 的臨床試驗語料庫,官網標示 545,000 筆。
收錄範圍包含 arXiv、bioRxiv、medRxiv、SSRN 等預印本,涵蓋開放取用與訂閱制論文,但不收錄書籍、學位論文與非學術出版品。
還有一個容易被忽略的細節:全文分析能力取決於你拿不拿得到全文。官方說明,若論文為開放取用,或你安裝了 Elicit 瀏覽器擴充功能且擁有該期刊訂閱(個人或機構訂閱皆可),它可讀取完整論文;否則只能讀標題與摘要,摘要沒寫的方法學細節就讀不到。
三、貴不貴:方案與定價
Elicit 的定價頁有一個容易被略過的設計:頁面上方有 Industry(產業)與 Academic(學術)兩組切換,兩者是完全不同的方案結構與價格。學術組不但便宜,還多一個入門付費方案。學術使用者請務必切到 Academic 再看價格。
以下為 Academic(學術) 組,幣別美元,查詢日期 2026 年 8 月 20 日。
| 方案 | 月繳 | 年繳(折後月費) | 年繳總額 | 主要額度 |
|---|---|---|---|---|
| Basic | 免費 | 免費 | 免費 | 無限次搜尋、無限篇摘要、與論文對話;Research Agent 與 Research Reports 用量有限 |
| Plus | $19 | $11 | $132 | 資料表一次 5 欄;可匯出 RIS/CSV/BIB/PDF/DOCX;可搜尋逾 50 萬筆臨床試驗 |
| Pro | $69 | $39 | $468 | 專屬系統性回顧流程,可篩選 5,000 篇;資料表一次 20 欄;135 個資料來源;10 組追蹤提醒;API |
| Scale | $149 | $89 | $1,068 | 資料表一次 30 欄;可萃取並判讀論文圖表;即時協作;200 個資料來源 |
| Enterprise | 客製報價 | 客製報價 | 客製報價 | 可篩選 40,000 篇、萃取 40 欄;無限追蹤提醒;預設不以你的資料訓練模型;SSO/SAML |
(費用為每位使用者每月計;年繳為一次付清全年費用後之等效月費。作為對照,產業組 Pro 年繳等效月費為 $49、Scale 為 $169,明顯高於學術組。)
官方定價頁: https://elicit.com/pricing 一切以官網公告為準。
怎麼挑
- 只是想試試看語意檢索好不好用 → 免費 Basic 就夠,搜尋與摘要都不限次數。
- 要寫論文前言、需要匯出書目 → Plus(年繳約每月 11 美元)。
- 要做正式的系統性回顧或統合分析 → Pro 起跳,因為專屬系統性回顧流程與一次 20 欄的資料萃取在這一層才有。
- 團隊協作、需要看論文裡的圖表 → Scale。
用量制度有一點值得留意:Elicit 已改為單一共用的月度用量池,不再各功能分開計次。官方說明用量依任務複雜度而異,簡單提問耗用極少,長時間的代理程式工作階段耗用較多。
它是閉源商業服務
Elicit 是閉源的商業訂閱服務,不是開源軟體。有免費方案,但完整功能需要付費,外部也無從稽核其檢索排序與摘要生成的實際運作方式。
四、使用前該知道的限制
官方自行說明本工具有以下限制:
To help you calibrate how much you can rely on Elicit, we'll share some of the limitations you should be aware of as you use Elicit
為協助你拿捏可以多依賴 Elicit,我們在此說明使用 Elicit 時應注意的一些限制。
「拿捏可以多依賴」(calibrate how much you can rely on)這個用詞就值得注意:它把判斷權留給使用者,該信到什麼程度由你決定。
其一,幻覺風險並未消除
the models aren't explicitly trained to be faithful to a body of text by default. We've had to customize the models to make sure their summaries or extractions are actually what is said in the abstract, and not what the model thinks is likely to be the case in general (sometimes called "hallucination"). While we've made a lot of progress and try hard to err on the side of Elicit saying nothing rather than saying something wrong, in some cases Elicit can miss the nuance of a paper or misunderstand what a number refers to.
這些模型預設並未被明確訓練成忠實於某段文本。我們必須客製化模型,以確保其摘要或萃取內容確實是摘要中所述,而非模型認為一般情況下可能為真的內容(有時稱為「幻覺」)。雖然我們已有很大進展,並盡力讓 Elicit 寧可什麼都不說,也不要說錯,但在某些情況下,Elicit 仍可能錯失論文的細微之處,或誤解某個數字所指為何。
請特別注意最後半句:misunderstand what a number refers to,誤解某個數字所指為何。
對做統合分析的人而言,這句話很具體:它可能把組間差異讀成組內變化,把中位數讀成平均數,把追蹤終點的數值填進基線欄位。而這些錯誤不會讓表格看起來有問題。
其二,它無法評估論文品質
這是全篇最重要的一段:
Elicit is only as good as the papers underlying it. While we think researchers are a very careful and rigorous group on average, there is research with questionable methodology and even fraud. Elicit does not yet know how to evaluate whether one paper is more trustworthy than another, except by giving you some imperfect heuristics like citation count, journal, critiques from other researchers who cited the paper, and certain methodological details (sample size, study type, etc.). We're actively researching how best to help with quality evaluation but, today, Elicit summarizes the findings of a bad study just like it summarizes the findings of a good study.
Elicit 的品質取決於其底層論文。雖然我們認為研究者平均而言是非常謹慎嚴謹的一群,但確實存在方法學可疑、甚至造假的研究。Elicit 目前尚不知道如何評估某篇論文是否比另一篇更可信,只能提供一些不完美的經驗指標,例如引用次數、期刊、其他引用該論文之研究者的批評,以及某些方法學細節(樣本數、研究類型等)。我們正積極研究如何協助品質評估,但就今天而言,Elicit 摘要一篇劣質研究的結果,與摘要一篇優質研究的結果並無二致。
一篇樣本數 12 人、沒有對照組、結果選擇性報告的研究,和一篇設計嚴謹的多中心隨機對照試驗,在 Elicit 產生的表格裡會長得一模一樣:同樣的欄位、同樣的排版、同樣流暢的一句話摘要。格式的一致性,會掩蓋品質的巨大差異。
其三,它提醒你注意確認偏誤
In the same way that good research involves looking for evidence for and against various arguments, we recommend searching for papers presenting multiple sides of a position to avoid confirmation bias.
正如良好的研究需同時尋找支持與反對各種論點的證據,我們建議搜尋呈現立場多面向的論文,以避免確認偏誤。
語意檢索在這裡有個副作用:你問得越具體,它越能精準找到「回答你這個問題」的論文。而如果提問本身帶有預設立場,它會非常有效率地把符合你預期的文獻遞到你面前。
其四,領域涵蓋並不平均
Elicit works better for some questions and domains than others. We eventually want to help with all domains and types of research but, to date, we've focused on empirical research (e.g. randomized controlled trials in social sciences or biomedicine) so that we can apply lessons from the systematic review discipline.
Elicit 對某些問題與領域的效果優於其他領域。我們最終希望能協助所有領域與所有類型的研究,但迄今我們聚焦於實證研究(例如社會科學或生醫領域的隨機對照試驗),以便援用系統性回顧學門的經驗。
換句話說,如果你做的是生醫或社會科學的實證研究,它的表現會比較接近官方描述;越偏離這個範圍,越需要自己驗證。
官方另補充兩點實務限制:灰色文獻與部分臨床試驗報告在自動化檢索中的擷取率可能較低;區域涵蓋度因資料庫來源而異,中文出版品有部分缺口。因此建議若要做最完整的回顧,仍應在領域專屬資料庫補充檢索。官方也說明,在某些工作流程中 Elicit 或可讀取或回應英文以外的語言,但無法確保該等回應的正確性。
其五,官方明說這份清單並不完整
This section is really way too short. We tried to share enough to make you not overrely on Elicit but this is not a comprehensive list of possible limitations.
這一節其實太短了。我們試圖提供足夠資訊,讓你不致過度依賴 Elicit,但這並非可能限制的完整清單。
五、匯東華觀點:它解決「找得到」,解決不了「該不該信」
把前面幾節放在一起看,Elicit 的定位其實非常清楚,而清楚的定位正是它值得推薦的原因。
它大幅降低「找到文獻」與「整理文獻」的成本。 語意檢索確實處理關鍵字檢索的根本弱點,資料萃取表格也確實把系統性回顧最耗時的一段自動化。這是真實的貢獻,不需要打折。
但它沒有降低「判斷文獻該不該信」的成本,而這一點官方自己講得比誰都清楚。這句話同時說明兩件事。
第一,篩選(screening)與評讀(appraisal)是兩件不同的事。
系統性回顧的標準流程裡,「篩選出符合納入條件的研究」與「評估這些研究的偏誤風險」是兩個獨立步驟。Elicit 自動化的是前者;後者,也就是 Cochrane RoB 2、ROBINS-I、NOS 這類偏誤風險評估工具在做的事,官方明說它做不到。
一份完成了自動篩選、卻沒有做偏誤風險評估的回顧,不是完成度 90% 的系統性回顧,而是一份還沒開始評讀的清單。
第二,效率提升會放大品質問題,而不是抵銷它。
過去一天讀 20 篇,你會逐篇看方法;現在一小時產出 200 篇的萃取表格,你很可能只看表格。而表格是均質的,劣質研究與嚴謹研究在裡面長得一模一樣。當閱讀單位從「論文」變成「表格列」,你失去的正是判斷品質所需要的訊息:樣本怎麼來的、有沒有盲法、失訪多少、結果指標是不是事後才改的。
所以我們的建議是:把 Elicit 用在它最強的地方,檢索與整理;評讀的部分留給自己。
那句「讓研究者的證據基礎強十倍」(10x more evidence-based)也應該這樣理解:它讓你接觸到的證據多了十倍,至於這些證據能不能支撐你的結論,仍然要由你來判斷。
證據的量能靠工具提升,證據的質不行。
一份系統性回顧最後掛的是你的名字。當審查委員問「你為什麼納入這篇樣本數 12 人、沒有對照組的研究」,「工具幫我找出來的」不是一個答案。
把關這件事,不能外包。
六、怎麼用才安全:三個實務做法
其一,萃取表格逐格核對,並善用句子層級引用
資料萃取表格是它最省時的功能,也是最需要查核的地方,原因就是官方講的那句:它可能誤解某個數字所指為何。而這種錯誤沒有外觀特徵,填錯的那一格看起來和填對的完全一樣。
好消息是,官方設計了句子層級的來源引用,讓查核比想像中快。實務上建議:
- 納入分析的每一筆數值都要回原文核對,不能只核對「看起來奇怪」的那幾筆。因為你判斷「奇怪」的依據,正好就是你想從表格得到的資訊。
- 特別注意單位、時間點與比較基準:是組間差異還是組內前後變化?是追蹤終點還是基線?是平均數還是中位數?這三類最容易錯,也最容易被忽略。
- 確認它到底讀了什麼。若論文非開放取用、你也沒有全文權限,它只讀得到標題與摘要,而且不會主動告訴你它沒讀到全文。方法學細節多半寫在全文,這一點會直接影響萃取品質。
其二,把工作流程切成兩段
若要用 Elicit 協助系統性回顧,建議把流程明確切開:
第一段(可借助工具):擬定研究問題、初步檢索、去重、初篩。
第二段(必須人工,且需雙人獨立進行):全文評讀、偏誤風險評估、資料萃取核對、證據等級判定。
這樣切的好處是,你可以放心地在第一段大量使用工具、把時間省下來,因為你知道第二段有人在守。第二段是掛名者的專業責任,也是投稿後審查委員真正會質疑的部分。
若研究要投稿,檢索策略必須可重現。單一工具的語意檢索通常不足以作為完整的檢索策略,官方自己也建議,若要做最完整的回顧,應在領域專屬資料庫補充檢索。實際做法仍應以目標期刊要求與 PRISMA 等報告規範為準。
其三,用提問方式主動對抗確認偏誤
語意檢索的效率是雙面的。如果你問「證實 A 有效的研究有哪些」,它會非常有效率地找到支持 A 的文獻,每一篇看起來都很相關,你會覺得證據很充分。官方特地提醒要避免確認偏誤,這個提醒出現在一個檢索工具的說明文件裡,值得認真對待。
把它變成可執行的習慣:
- 同一個問題至少用兩種方向各問一次:一次找支持的證據,一次明確找反面、無效或有疑慮的證據。
- 主動搜尋失敗的研究:陰性結果、未達顯著、無法複製的研究,往往才是判斷效果穩不穩的關鍵。
- 留意問句裡有沒有藏著結論。「為什麼 A 能改善 B」和「A 是否能改善 B」,會得到完全不同的文獻清單。
工具會忠實回答你問的問題。問對問題,它的效率就是你的效率。
參考文獻
以下所有內容均於 2026 年 8 月 20 日查詢並擷取自官方來源。
- Elicit. Elicit: AI for Scientific Research(官方網站首頁,含六項功能說明與引用設計). https://elicit.com/
- Elicit. Pricing(官方定價頁,含 Industry/Academic 及月繳/年繳各組方案). https://elicit.com/pricing
- Elicit Help Center. Elicit's limitations(本文第四節官方原文出處). https://support.elicit.com/en/articles/14757928-elicit-s-limitations
- Elicit Help Center. Elicit's source for papers(資料來源、涵蓋範圍、更新頻率與全文取用說明). https://support.elicit.com/en/articles/14758040-elicit-s-source-for-papers
- Elicit Help Center. Usage limits in Elicit(共用月度用量池說明). https://support.elicit.com/en/articles/15646622-usage-limits-in-elicit
- Elicit Help Center. Languages other than English(非英語回應之正確性說明). https://support.elicit.com/en/articles/11126721
- Elicit Research, PBC. Terms of Service(公司法律名稱與免責條款). https://elicit.com/operations/terms
- Elicit. Elicit API Reference. https://docs.elicit.com/
同期其他單元
- 本期重點|一篇統合分析被撤下來,通常是哪裡出了問題?
- 專欄|AI 讓人去技能化
- 方法論問答|交互作用顯著,但變項本身不顯著:還要留在模型嗎?
匯東華電子報 第 3 期|2026.08.21|看本期網頁版 →
聯絡我們
- LINE:@medatatw
- Email:info@medatatw.com
- 電話:07-9721586
- 官網:www.medatatw.com

統計分析
服務價目表 (未含5%營業稅)
透過嚴謹的數據整理,提供有價值的資訊,形塑知識,提高決策品質。包括信達雅三執行原則。
信:確保資料品質可信賴
達:確保統計方法適切性
雅:確保圖文表格正規化
協助代執行統計分析與進一步加值服務。
在匯東華與夥伴的專業背景知識配合下,能有效地處理面對的問題。
統計分析成果

數據串接與清洗
數據是礦藏,數據清洗是挖出鑽石的第一步,尤其是巨量知識。數據清洗或串接執行過程需要細心與專注,且有可能會消耗許多時間和精力,就由我們來替各位處理掉這個大麻煩。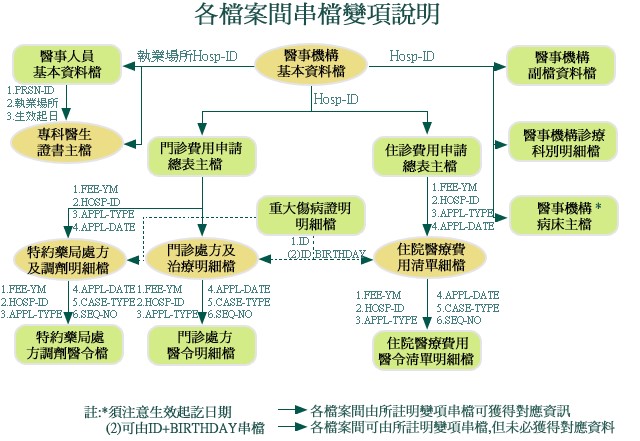
全民健保研究資料庫、國外大型資料庫資料非常齊全,種類多,需要串接與清洗,進行正規化後才能更進一步進行資料探勘與統計分析。
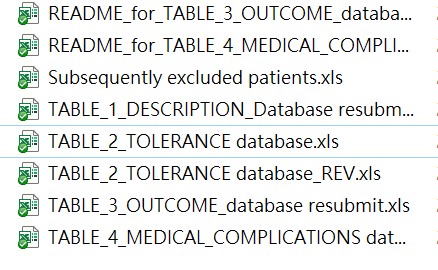
Fig1.同一個Project資料散落在不同tables,無法使用
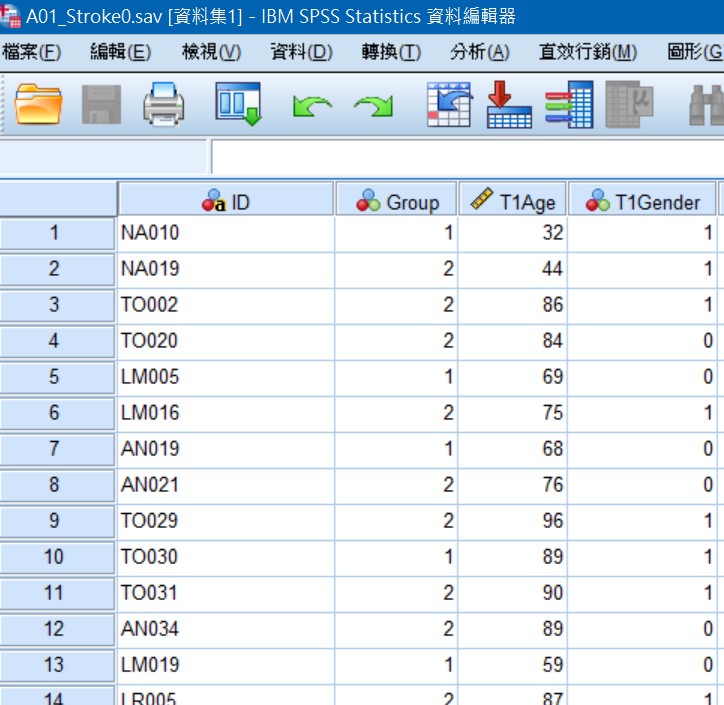
Fig2.整併與清理為可分析的table
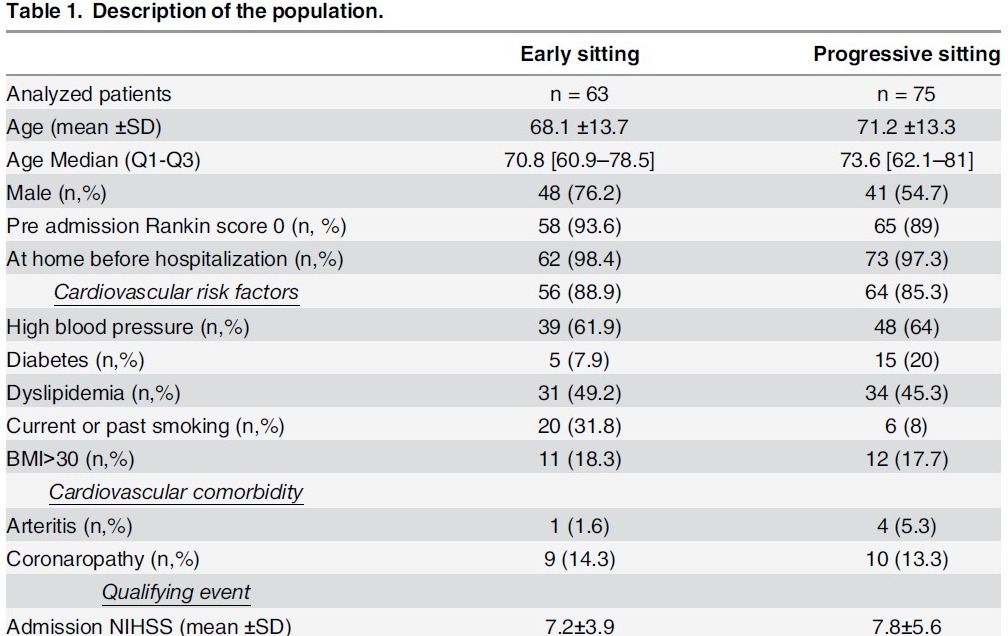
Fig.3整理和分析後形成有意義的知識
概念與流程示意圖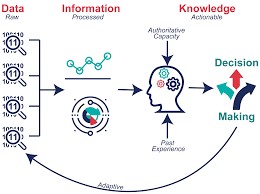

計畫撰寫與統計諮詢
為了讓匯東華的顧客與學員有更好的合作和消費體驗,故匯東華特別依據營業項目開發周邊產品,提供使用、購買。目前已有針對公共衛生師的題庫以及模擬試題,未來將針對醫學研究領域發展產品。