 匯東華統計顧問有限公司
一頁先懂|核心判斷
長期依賴 AI 輔助,專業能力可能退化。
目前最直接的一筆臨床證據來自四家波蘭內視鏡中心:在導入 AI 息肉偵測系統後,醫師執行沒有 AI 輔助的標準大腸鏡時,腺瘤偵測率(adenoma detection rate, ADR)由 28.4% 降至 22.4%。這項研究的重要性,在於它不再只是詢問使用者「是否覺得自己變依賴 AI」,而是觀察到實際臨床工作表現的變化。
但證據還沒有走到「AI 已證實會使專業能力退化」。
這是一項觀察性研究,研究刊出後已有三封讀者來函提出質疑,原作者亦正式回覆;寫作、認知工作與導航等其他領域的資料,則分別來自預印本、企業自有使用資料與不同研究設計,證據強度並不相同。
因此,現階段真正值得研究工作者警覺的,不只是 AI 會不會讓我們「少練習一項技能」,而是:
當愈來愈多認知工作被交給 AI,我們是否也把原本用來監督這些工作的判斷能力一起交了出去?
對研究工作而言,產出可以被加速;判斷不能被省略。
01|目前最直接的證據:AI 輔助內視鏡之後,沒有 AI 時發生了什麼?
2025 年,Budzyń 等人在 The Lancet Gastroenterology & Hepatology 發表一項多中心觀察性研究,探討一個相當直接的問題:
當內視鏡醫師長期暴露於 AI 輔助後,在沒有 AI 的情況下,其大腸鏡檢查表現是否發生改變?
研究涵蓋四家波蘭內視鏡中心。這些中心於 2021 年底導入 AI 息肉偵測系統,研究者比較 AI 導入前 3 個月與導入後 3 個月的標準非 AI 輔助大腸鏡,共納入 1,443 位病人:
AI 導入前:795 例
AI 導入後:648 例
中位年齡:61 歲
主要結果相當醒目。
標準非 AI 輔助大腸鏡的 ADR 由 28.4% 降至 22.4%,絕對差為 −6.0%(95% CI −10.5 至 −1.6;p = 0.0089)。多變項邏輯迴歸分析中,AI 暴露與較低 ADR 相關,OR 為 0.69(95% CI 0.53–0.89)。
若只看到這裡,很容易將結果轉述成:
「使用 AI 會讓醫師的能力退化。」
但原作者並沒有下這麼強的結論。
研究原文寫的是:
“Continuous exposure to AI might reduce the ADR of standard non-AI assisted colonoscopy, suggesting a negative effect on endoscopist behaviour.”
兩個限定語尤其重要:
might 是「可能」,不是「會」;
suggesting 是「暗示」,不是「證明」。
此非文字遊戲,而是證據強度。
觀察到 AI 導入前後的 ADR 下降,與證明 AI 造成能力退化,為兩個不同層級的主張。當 might 被轉述成 will,或 suggesting 被寫成 showing,研究結論就已經在傳播過程中被放大。
本項研究之所以值得重視,也正在於 ADR 並非抽象的實驗室測量,而是大腸鏡品質的重要臨床指標。因此,它至少提供一個需要正視的訊號:
AI 的影響可能不只出現在「使用 AI 的當下」,也可能延伸到 AI 不在場時的人類工作表現。
同期,Omer F Ahmad 在同一期刊發表評論〈Endoscopist deskilling: an unintended consequence of AI-assisted colonoscopy?〉,亦直接以 deskilling 描述這項值得關注的潛在非預期後果。
但「值得關注」仍然不等於「因果關係已經確立」。
02|真正的爭議:下降的是能力,還是行為?
這項研究屬於觀察性設計,而非隨機分派試驗。
研究刊出後,同年 12 月號的 The Lancet Gastroenterology & Hepatology 刊登三封相關讀者來函,以及原作者回覆。
| 類型 | 作者 | DOI | PMID |
|---|---|---|---|
| 讀者來函 | Lam K | 10.1016/S2468-1253(25)00290-0 | 41205614 |
| 讀者來函 | Levartovsky A, Kopylov U | 10.1016/S2468-1253(25)00289-4 | 41205615 |
| 讀者來函 | van de Sande D, Sleijfer S, Buijsman SNR, et al. | 10.1016/S2468-1253(25)00288-2 | 41205616 |
| 作者回覆 | Budzyń K, Romańczyk M, Mori Y | 10.1016/S2468-1253(25)00324-3 | 41205617 |
目前無法取得上述四篇全文,因此可以確認的是:這項研究確實引發正式學術討論。
但同樣必須守住另一條證據邊界:
「有三封來函提出質疑」不等於「學界已否定本項研究」。
對同一研究的方法學限制,美國胃腸病學會(American College of Gastroenterology, ACG)的 Evidence-Based GI 專欄整理得相當清楚,包括:
研究為觀察性設計,容易受到干擾與選擇偏誤影響。
AI 導入後,病人如何進入非 AI 組的程序說明不足。
即使經過統計調整,兩組間仍存在多項顯著差異,殘餘干擾不能排除。
僅涉及 19 位中等以上經驗的內視鏡醫師,可推論性有限,也難以穩定進行個別醫師層級分析。
未報告退鏡時間(withdrawal time)。
研究世代整體 ADR 約為 25.7%,外推至其他醫療體系時需要審慎。
其中,第 5 點尤其值得注意。
退鏡時間本身可能影響 ADR,而且它是一個可以改變的操作行為。假設 AI 導入後,醫師因為更加信任系統而改變操作速度,那麼 AI 導入後觀察到的 ADR 下降,至少存在兩種不同解釋:
第一種:能力退化。
醫師本身辨識病灶的能力下降。
第二種:行為改變。
醫師的工作方式改變,例如退鏡速度加快,進而影響 ADR。
兩者觀察到的數字可以相同,但代表的治理問題完全不同。
若為能力退化,可能需要重新訓練與維持技能。
若主要是行為改變,介入重點則可能轉向工作流程、操作規範、監測指標與提醒機制。
這也是解讀 AI 研究時經常被忽略的一層:
看到結果改變,不代表已經知道改變結果的機制。
而從顧問與治理角度來看,機制判斷錯誤,後續採取的管理措施也可能完全錯位。
03|其他領域出現了什麼訊號?先看證據層級
AI 去技能化的討論並不限於醫療。
目前在寫作、認知工作與導航等領域,都可以看到相關訊號;但不同研究的證據性質差異很大,不能只因為它們都被稱作「研究」,就給予相同權重。
| 領域 | 主要發現 | 證據性質 | 現階段可以說到哪裡 |
|---|---|---|---|
| 內視鏡 | AI 導入後,非 AI 輔助大腸鏡 ADR 由 28.4% 降至 22.4% | 多中心觀察性研究、同儕審查 | 有去技能化風險訊號,但不能直接建立因果 |
| AI 寫作 | LLM 組腦區連結性較弱,且較多人無法正確引述自己剛寫的內容 | 預印本、EEG 實驗 | 可討論認知參與與 cognitive ownership,但證據仍待同儕審查 |
| 認知工作 | 較高教育程度任務在 Claude 使用資料中呈現較大時間加速 | Anthropic 自有平台資料 | 可觀察工作內容可能重新分配,但不是獨立外部研究 |
| GPS/導航 | GPS 使用較多與自主導航空間記憶表現下降相關 | 同儕審查研究 | 支持導航行為與空間記憶可能相關,不等於證明「GPS 讓海馬體縮小」 |
本張表真正要表達的不是哪一項研究「比較厲害」,而是:
證據來源不同,可以支持的結論也就不同。
AI 寫作:產出了文字,不代表保有對內容的掌握
MIT Media Lab 的 Kosmyna 等人進行一項腦電圖實驗,研究於 2025 年首先以預印本形式上傳 arXiv(2506.08872)。
受試者使用 ChatGPT、搜尋引擎或完全不使用外部工具完成 SAT 類型作文。研究觀察到,LLM 組的腦區連結性最弱,Brain-only 組最強,搜尋引擎組居中。
更值得注意的是行為結果。
第一階段寫作完成後,LLM 組有 83.3%(15/18)無法正確引述自己剛完成的文章;搜尋引擎組與 Brain-only 組則皆為 11.1%(2/18)。
研究者以 cognitive ownership(認知所有權)討論這類現象。
對研究工作而言,這個概念值得注意的地方並不是「AI 到底讓哪個腦區變弱」,而是另一個更實際的問題:
作者是否仍然掌握自己的產出?
論文不是文字生成完成就算完成。作者必須知道自己寫了什麼、為什麼這樣寫,以及每一個主張的證據究竟能走到哪裡。
但這筆證據同樣需要明確標記其限制:它目前仍是預印本,尚未經正式同儕審查;部分階段樣本數亦較少。
因此,正確的轉述是:
「一項尚未經同儕審查的預印本觀察到……」
而不是:
「MIT 已證實 ChatGPT 使大腦退化。」
高階工作:AI 不一定只替代低階任務
另一個值得注意的方向來自 Anthropic 發布的經濟指數報告。
其 Claude.ai 使用資料顯示,需要高中程度教育背景理解的任務約加速 9 倍,需要大學程度教育背景的任務則約加速 12 倍。
上述發現至少挑戰一個常見直覺:
AI 並不一定只影響低階、重複性的工作。
Anthropic 自己甚至使用了 deskill 一詞,認為如果較高教育程度的任務被移除,第一階效果可能使工作的平均技能需求下降。
但來源性質仍然必須說清楚:
這是 Anthropic 對自家產品使用資料的分析,而不是獨立研究團隊進行的同儕審查研究。
同一份報告中,Claude 的「任務跨度」還出現了 2 小時、約 3.5 小時及約 19 小時三個不同數字。
這三個數字並非必然互相矛盾,因為它們來自不同資料來源與估計方式。
這正好示範研究判讀的一個基本原則:
數字本身沒有脫離研究設計而獨立存在的意義。
知道「19 小時」不夠。
還要知道這 19 小時是在哪一種資料、哪一種定義與哪一種估計方法下得到的。
GPS:比數字錯誤更危險的是研究方向被寫反
AI 去技能化的討論中,GPS 是另一個常見例子。
但經典的倫敦計程車司機研究,經常被轉述錯誤。
Maguire 等人 2000 年在 PNAS 發表的研究發現,倫敦計程車司機的後側海馬體比對照組更大,前側海馬體則較小;後側海馬體體積亦與從業年資呈正相關。
2006 年研究再以公車司機作為對照。
這兩項研究從來不是:
GPS 使用者 vs. 非 GPS 使用者。
至於 GPS 本身,Dahmani 與 Bohbot 2020 年發表於 Scientific Reports 的研究則觀察到,GPS 使用愈多,海馬體依賴型空間記憶表現下降愈明顯。
但該研究並沒有報告:
「使用 GPS 的人海馬體縮小多少。」
把這些研究拼接成「GPS 會讓海馬體變小」,不只是數字錯誤,而是把原本的研究問題、比較組與結果方向重新組裝成另一個故事。
對研究工作而言,這類錯誤尤其危險。
數字錯了,回原文還可能校正;研究方向寫反,等於證據鏈本身已經被重建。
而最值得警惕的是:錯誤版本往往比原始研究更符合我們原先相信的故事,因此也更容易被接受、記憶與傳播。
04|真正需要防止的,可能不是「不會做」,而是「不會判斷」
研究工作的核心從來不只是產出。
真正困難的工作是判斷:
這個方法是否適用?
這個模型的假設是否成立?
這項結果能否如此解釋?
這個數字究竟來自原文、摘要,還是二手整理?
這是 RCT、觀察性研究、預印本,還是企業自有資料?
原作者使用的是 might,還是 will?
研究觀察的是 association,還是已經足以主張 causation?
這項結果是否「剛好」過度完美地支持我們原本的觀點?
生成式 AI 改變的是產出的邊際成本。
一段帶有專業術語、統計數字、論文引用與完整格式的文字,現在可以在極短時間內完成。
產出變容易了,判斷沒有。
甚至可以進一步說:
產出愈便宜,判斷反而愈重要。
因為當每個人都能迅速產生大量看起來合理的內容,真正稀缺的就不再只是「能不能生成」,而是:
誰能辨識哪些內容值得相信,哪些只能暫時保留,哪些根本不能下這個結論。
此為 AI 時代的去技能化最值得研究工作者警覺之處。
真正危險的不是 AI 偶爾犯錯。
真正危險的是:
當人逐漸失去驗證能力之後,AI 犯錯時,我們也看不出來。
其中還有一個特別容易被忽略的檢查點:
當一筆引用「剛好」完美支持自己的論點時,反而是最需要回到原始來源重新核對的時刻。
明顯荒謬的錯誤通常容易被發現。
最難辨識的,是那些非常符合我們期待的錯誤。
05|AI 可以用,但先決定哪些能力不能交出去
陶哲軒(Terence Tao)在其 AI 觀點整理中提出一個很實用的原則:
不要把自己希望長期保留的核心技能自動化掉。
他將 not replacing a primary skill 列為使用 AI 時的重要考量,也以自己的程式能力為例:某些技能可以接受逐漸退化,但另一些則刻意維持熟練。
這個觀點比單純規定「每週幾天不用 AI」更接近問題本質。
真正需要管理的並不是 AI 使用時間,而是:
哪些認知工作可以外包,以及哪些能力必須持續保留在人身上。
對研究工作者而言,可以先從三件事開始。
1. 先定義不能失去的核心能力
對統計與研究工作而言,方法選擇、研究設計判斷、假設檢查、結果解讀、因果邊界與證據強度判定,通常都屬於核心能力。
格式整理、初步資料彙整、程式碼樣板或重複性的資訊轉換,則較適合自動化。
區別標準不是「AI 能不能做」,而是:
這項能力如果失去,我是否還有能力判斷 AI 做得對不對?
如果答案是否定的,就不應完全交出去。
2. 保留無 AI 的「驗證動作」,而不是刻意製造無 AI 的「時段」
例如建立一條明確規則:
所有準備寫入論文的關鍵數字,都必須回到原始來源核對。
這項動作每次可能只需要幾分鐘,但它維持的是證據查核能力。
相較之下,單純安排「星期日不用 AI」只能控制使用量,未必能保住真正重要的專業能力。
3. 每一次轉述,都重新確認證據限定語
might 不是 will。
suggesting 不是 showing。
association 不是 causation。
觀察性研究不是因果試驗。
preprint 也不等於已完成正式同儕審查。
這些看似只是幾個字。
但研究品質,往往就存在這幾個字之間。
結語|可以外包產出,不要外包判斷
AI 讓許多過去耗費大量時間的工作變得快速、便宜,而且容易取得。
這本身不是問題。
真正需要治理的是:我們把什麼交出去,又保留了什麼。
如果 AI 幫我們搜尋、整理、寫作、程式設計、分析,最後連「這個結果到底可不可信」都一起交由 AI 判定,那麼被自動化掉的就不再只是工作流程,而是原本用來監督整個流程的能力。
因此,AI 時代真正重要的問題不是:
要不要用 AI?
而是:
哪些工作可以交給 AI,哪些判斷必須始終掌握在人手中?
對研究工作者而言,這條界線應該非常清楚。
可以外包產出。
不要外包判斷。
延伸|12 月 11 日晚間直播
2026 研究翻車現場:AI 幫你犯的錯,我們該負的責
我們會從真實案例拆解 AI 研究工作中的引用錯誤、證據錯置、過度推論,以及人類使用者最終必須承擔的判斷責任。
參考文獻
- Budzyń K, Romańczyk M, Kitala D, et al. “Endoscopist Deskilling Risk after Exposure to Artificial Intelligence in Colonoscopy: A Multicentre, Observational Study.” The Lancet Gastroenterology & Hepatology, vol. 10, no. 10, Oct. 2025, pp. 896–903. doi:10.1016/S2468-1253(25)00133-5. PMID: 40816301.
- Ahmad OF. “Endoscopist Deskilling: An Unintended Consequence of AI-Assisted Colonoscopy?” The Lancet Gastroenterology & Hepatology, vol. 10, no. 10, Oct. 2025, pp. 872–873. doi:10.1016/S2468-1253(25)00164-5.
- Lam K. “Endoscopist Deskilling Risk after Exposure to Artificial Intelligence in Colonoscopy.” The Lancet Gastroenterology & Hepatology, vol. 10, no. 12, Dec. 2025, p. 1060. doi:10.1016/S2468-1253(25)00290-0. PMID: 41205614.
- Levartovsky A, Kopylov U. “Endoscopist Deskilling Risk after Exposure to Artificial Intelligence in Colonoscopy.” The Lancet Gastroenterology & Hepatology, vol. 10, no. 12, Dec. 2025, pp. 1060–1061. doi:10.1016/S2468-1253(25)00289-4. PMID: 41205615.
- van de Sande D, Sleijfer S, Buijsman SNR, Gommers D, van Genderen ME. “Endoscopist Deskilling Risk after Exposure to Artificial Intelligence in Colonoscopy.” The Lancet Gastroenterology & Hepatology, vol. 10, no. 12, Dec. 2025, pp. 1061–1062. doi:10.1016/S2468-1253(25)00288-2. PMID: 41205616.
- Budzyń K, Romańczyk M, Mori Y. “Endoscopist Deskilling Risk after Exposure to Artificial Intelligence in Colonoscopy: Authors’ Reply.” The Lancet Gastroenterology & Hepatology, vol. 10, no. 12, Dec. 2025, p. 1062. doi:10.1016/S2468-1253(25)00324-3. PMID: 41205617.
- Zhou MJ. “Artificial Intelligence in Colonoscopy: Could It Be Making Us Worse?” Evidence-Based GI, American College of Gastroenterology, 17 Sept. 2025. https://gi.org/journals-publications/ebgi/zhou_sep2025/
- Kosmyna N, Hauptmann E, Yuan YT, Situ J, Liao XH, Beresnitzky AV, Braunstein I, Maes P. “Your Brain on ChatGPT: Accumulation of Cognitive Debt When Using an AI Assistant for Essay Writing Task.” arXiv, 2506.08872, 10 June 2025; v2: 31 Dec. 2025. 預印本,未經同儕審查。 https://arxiv.org/abs/2506.08872
- Anthropic. “The Anthropic Economic Index Report: New Building Blocks for Understanding AI Use.” Accessed 20 Aug. 2026. https://www.anthropic.com/research/economic-index-primitives
- Maguire EA, Gadian DG, Johnsrude IS, Good CD, Ashburner J, Frackowiak RSJ, Frith CD. “Navigation-Related Structural Change in the Hippocampi of Taxi Drivers.” Proceedings of the National Academy of Sciences, vol. 97, no. 8, 14 Mar. 2000, pp. 4398–4403. doi:10.1073/pnas.070039597.
- Maguire EA, Woollett K, Spiers HJ. “London Taxi Drivers and Bus Drivers: A Structural MRI and Neuropsychological Analysis.” Hippocampus, vol. 16, no. 12, 2006, pp. 1091–1101. doi:10.1002/hipo.20233.
- Dahmani L, Bohbot VD. “Habitual Use of GPS Negatively Impacts Spatial Memory during Self-Guided Navigation.” Scientific Reports, vol. 10, 2020, article 6310. doi:10.1038/s41598-020-62877-0.
- Tao, Terence. “Terence Tao on AI: A Living Summary.” teorth.github.io/tao-web. Accessed 20 Aug. 2026. 該頁位於陶哲軒個人網站,依其自述係以 AI 彙整其既往貼文、訪談與影片而成。
AI 使用聲明
本文由匯東華統計顧問有限公司陳秀敏博士撰稿。GPT-5.6 Sol 協助文字潤飾與結構編輯,Claude Opus 5 協助全文檢索、DOI 中繼資料比對與網頁排版。所有事實查證、一手來源比對、證據強度判定及最終內容均由作者審閱並負責。
匯東華統計顧問有限公司|Medata Research Integrity & AI Governance
智。數據決策|專業 × 效率 × 熱忱 × 創新 × 永續
同期其他單元
匯東華電子報 第 3 期|2026.08.21|看本期網頁版 →
聯絡我們
- LINE:@medatatw
- Email:info@medatatw.com
- 電話:07-9721586
- 官網:www.medatatw.com

統計分析
服務價目表 (未含5%營業稅)
透過嚴謹的數據整理,提供有價值的資訊,形塑知識,提高決策品質。包括信達雅三執行原則。
信:確保資料品質可信賴
達:確保統計方法適切性
雅:確保圖文表格正規化
協助代執行統計分析與進一步加值服務。
在匯東華與夥伴的專業背景知識配合下,能有效地處理面對的問題。
統計分析成果

數據串接與清洗
數據是礦藏,數據清洗是挖出鑽石的第一步,尤其是巨量知識。數據清洗或串接執行過程需要細心與專注,且有可能會消耗許多時間和精力,就由我們來替各位處理掉這個大麻煩。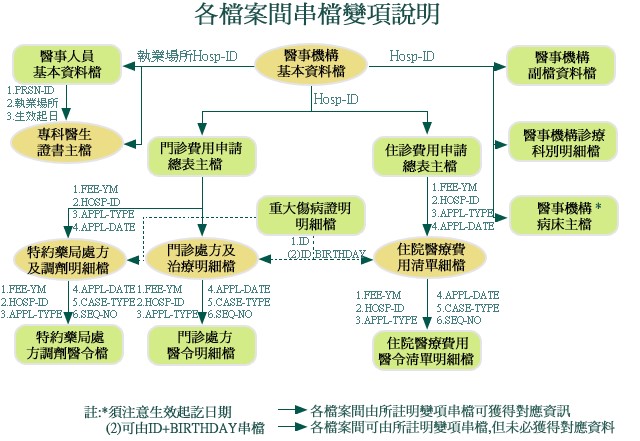
全民健保研究資料庫、國外大型資料庫資料非常齊全,種類多,需要串接與清洗,進行正規化後才能更進一步進行資料探勘與統計分析。
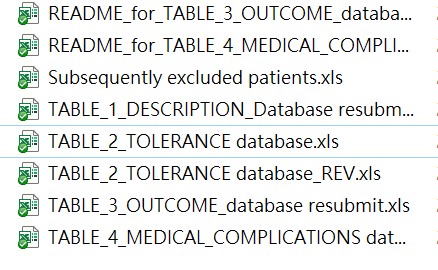
Fig1.同一個Project資料散落在不同tables,無法使用
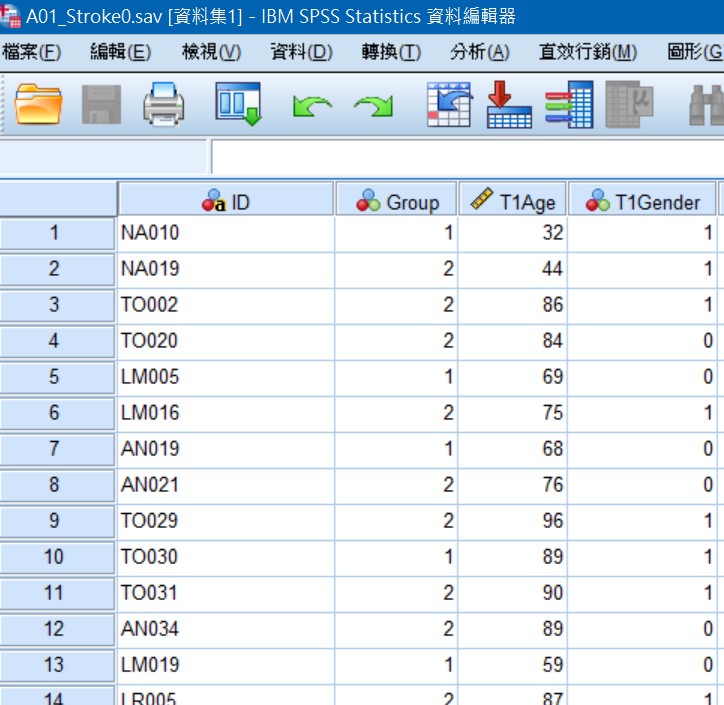
Fig2.整併與清理為可分析的table
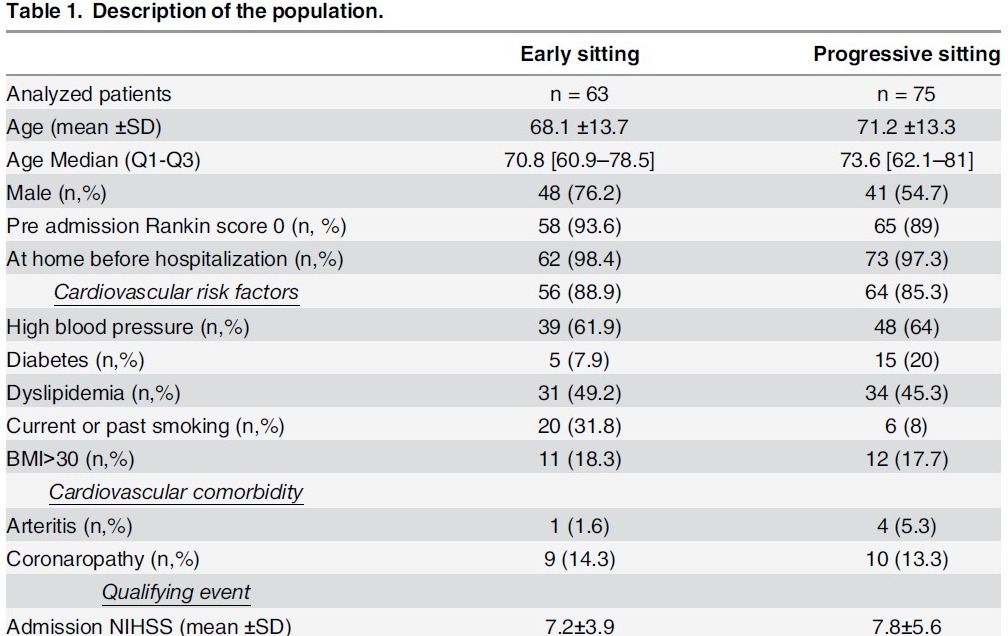
Fig.3整理和分析後形成有意義的知識
概念與流程示意圖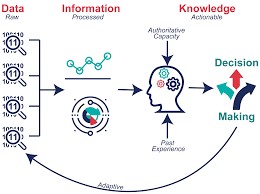

計畫撰寫與統計諮詢
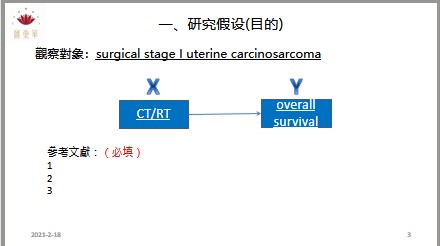
為了讓匯東華的顧客與學員有更好的合作和消費體驗,故匯東華特別依據營業項目開發周邊產品,提供使用、購買。目前已有針對公共衛生師的題庫以及模擬試題,未來將針對醫學研究領域發展產品。