 匯東華統計顧問有限公司
一頁先懂|核心判斷
問題是:研究者、審稿人或期刊編輯很容易把「這篇論文對照 TRIPOD+AI 逐項寫齊」直接當成「這個預測模型做得沒問題」。但原文講得很清楚:本份指引只評估「你有沒有說」,不管「你做得對不對」。方法品質與偏差風險評估是另一份指引 PROBAST 的工作,勾完 27 項不會提醒你這件事。
正確做法是:把 TRIPOD+AI 當成報告完整度的檢查表使用,逐一比對 27 項主條目、52 個子條目(含 13 項摘要清單),確認研究每一項該講的都講了;若某一項因資訊未知或不適用而無法報告,指引要求要明確承認並以文字說明,不能留白。模型本身做得好不好,仍要另外用 PROBAST 之類的工具評估偏差風險。
使用這份指引前,三件最容易被忽略、卻可能讓判讀出錯的事:
- 27 項全部寫齊,不代表模型品質沒問題;它只回答「你有沒有交代」,不回答「你做得對不對」,這是兩份不同指引在管的事。
- 舊版 2015 年的 TRIPOD 已被取代,原文明講「舊版不應再被使用」;若手上的文獻或範本還在對照舊版清單,結果並不適用於現在的審稿標準。
- 這份指引開發時沒有把基礎模型與大型語言模型(如 ChatGPT 那一類)納入考量,原文說明它主要針對非生成式模型;用它逐項核對生成式 AI 模型的論文,本來就超出設計範圍。
前言:TRIPOD+AI 是什麼
2024 年 4 月,BMJ 發表 TRIPOD+AI 文章。其為臨床預測模型研究的報告規範,告訴研究者應該如何報告這類型研究。共有 27 項主條目、展開後是 52 個編號子條目,另附一份給摘要使用的 13 項清單。2024 年改版主要取代 2015 年版的 TRIPOD。原文提到:新清單取代 TRIPOD 2015,舊版不應再被使用。改版理由很直接:越來越多研究改用機器學習方法建構預測模型,而 2015 年那版是依據迴歸模型做法進行設計。TRIPOD+AI 把兩邊合成一套,不管你用 Logistic、Cox,還是隨機森林、深度學習,都對同一個標準,同時統一兩個主流社群的專有名詞。此外,新版另加三方面新要求,包括:公平性的考量被放進整份清單、新增一項病人與公眾參與、新增一整個開放科學區塊(即計畫書、註冊、資料共享、程式碼共享)。
研究者、審稿人與期刊編輯,以及後續要判斷臨床預測模型能不能用者(機構、政策制定者、審查機關、病人)都需要用它做為審核標準。使用時,需要注意兩件事。第一,本份指引只評估「你有沒有說」,不管「你做得對不對」,方法品質與偏差風險評估請見 PROBAST 系列。第二,指引開發時,基礎模型與大型語言模型(ChatGPT 那一類)並未納入考量,原文說明它主要針對非生成式模型。
以下依論文大類,逐項導讀 27 項主條目。
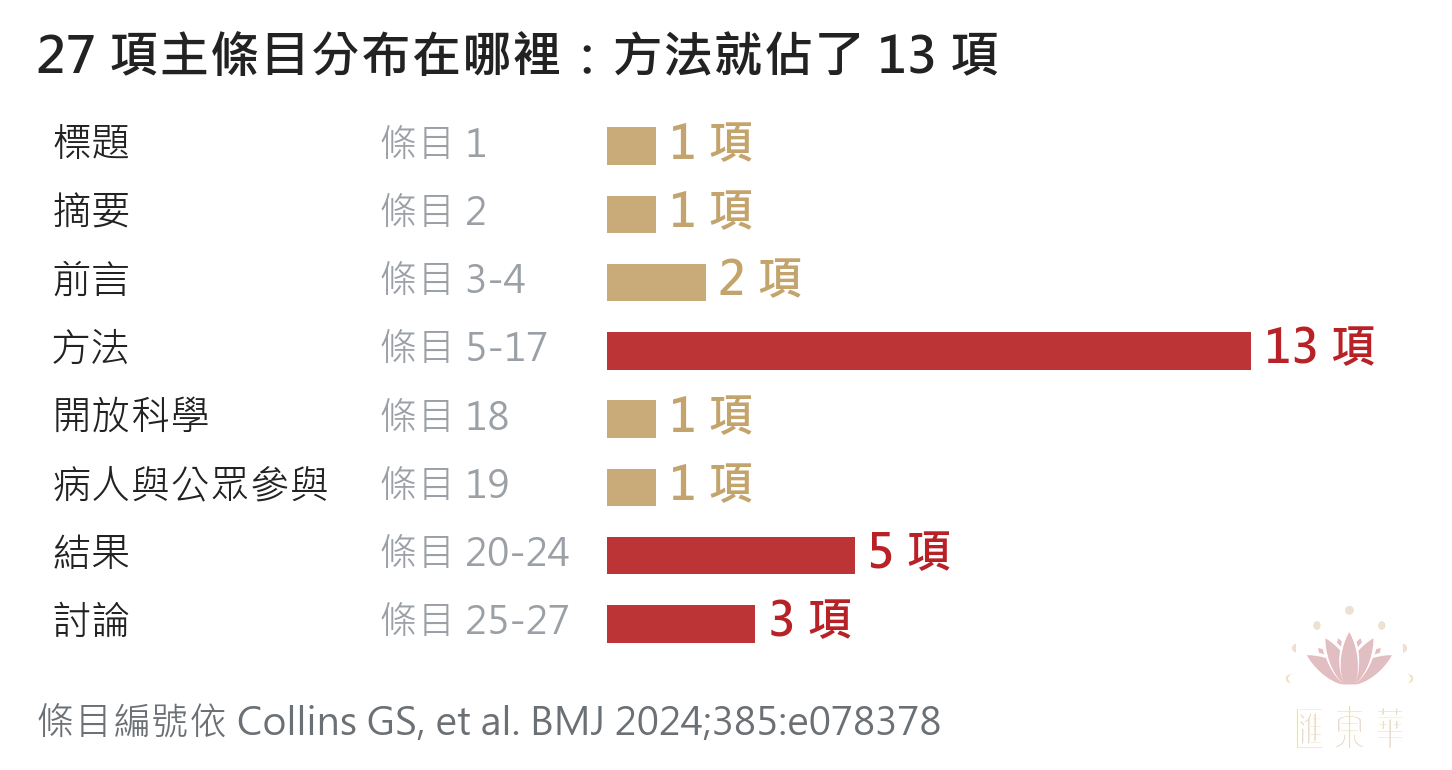
圖1、TRIPOD+AI 27 項主條目在論文八個區塊中的分布:標題 1 項(條目 1)、摘要 1 項(條目 2)、前言 2 項(條目 3 到 4)、方法 13 項(條目 5 到 17)、開放科學 1 項(條目 18)、病人與公眾參與 1 項(條目 19)、結果 5 項(條目 20 到 24)、討論 3 項(條目 25 到 27)。方法區塊佔 13 項,接近全部條目的一半。
(點擊圖片可開啟原圖放大檢視)
Title|標題(條目 1)
這一類只問一件事:光看標題,讀者知不知道這是一篇預測模型研究。
條目 1。 標題要寫出三件事:1. 這是在開發還是在評估一個多變項預測模型、2. 目標族群是誰、3. 要預測的結果變項是什麼。原文的理由很實際:好的標題讓潛在讀者及做系統性文獻回顧研究者能夠檢索到這篇文章。
Abstract|摘要(條目 2)
這一類問的是:只讀摘要的人,能不能掌握該研究的關鍵資訊。
條目 2。 摘要要涵蓋 TRIPOD+AI for Abstracts 清單的每一項,那是一份獨立的 13 項清單(本文後面獨立一段列出)。換句話說,摘要並非正文的濃縮,它另有一張自己的表要對。
Introduction|前言(條目 3 到 4)
這一類問的是:為什麼要做這個模型、要給誰用、用在誰身上。
條目 3(三個子條目)。 3a 要說明醫療情境(明確指出此為診斷模型或是預後模型)以及做本研究的理由,並引用已有的模型;若同一題目已有模型存在,要明確論證為何還要再做一個新的;如果你做的是評估研究,要說明評估的理由並引用所有被評估的模型。3b 要描述目標族群、模型的預期用途(它要支援哪一個臨床決定,例如轉介、住院、分流、開始治療),以及它會被放在照護流程的哪一個時間點、預期使用者是誰(醫療專業人員、病人,還是一般民眾)。3c 要描述目標族群中已知的社會人口群體間健康不平等,並附上支持的引用。這三題回答同一個問題:這個模型要給誰、在什麼時候、解決什麼。
條目 4。 明確寫出研究的所有目的,包含這篇是在開發模型、評估模型表現,還是兩者都做。
Methods|方法(條目 5 到 17)
此為全表佔比最大的一節,13 項主條目,接近全部條目的一半。核心問題為:別人是否能照著你寫的內容重做一次,並判斷你這樣做合理與否。
條目 5(兩個子條目)。 5a 要分別交代開發資料與評估資料的來源(隨機試驗、世代研究、日常照護紀錄或疾病登錄資料庫)、為什麼用這批資料,以及這批人代不代表模型將來要用的那群人。還要指明這個研究用的是既有資料,還是為了這次預測模型研究前瞻性收集的新資料。若用的是別人為其他目的收集的既有資料,要說明合不合用,尤其當它來自不同場域或不同國家;用了合成資料,要說明為什麼用、怎麼生成。5b 要寫出收案的起訖日期,預後模型還要寫追蹤結束日。
條目 6(三個子條目)。 6a 要說明照護場域(基層、次級照護或一般族群)、地理位置(至少到國家)與中心的數目。6b 要寫納入與排除條件,包含連續變項的限制(例如年齡範圍)。6c 必要時要交代參與者在追蹤開始前或當下接受過的治療,以及這些治療在開發或評估過程中如何處理;在模型使用到結果測量之間發生、可能改變結果機率的治療,也要寫。此三項決定別人能不能判斷你的模型適不適用於他的病人。
條目 7。 要描述所有資料前處理與品質檢查:資料清理、特徵工程、原始資料轉換、特徵縮減。資料來自多個來源時,要說明如何整合(例如結果變項與預測因子的定義如何對齊),並確認這些步驟在主要社會人口群體之間是否一致。所有清理程式碼要能取得(見條目 18f);篇幅過長可考慮放補充材料。
條目 8(三個子條目)。 8a 要清楚定義結果變項與預測的時間範圍、怎麼測、什麼時候測、為什麼選這個結果,以及測量方式在不同社會人口群體之間是否一致;診斷模型要說明用了什麼參考標準,預後模型要寫明時間範圍(例如術後 28 天死亡風險、10 年骨折風險)與追蹤期間的評估頻率;必要時要確認沒有任何預測因子被用來定義結果變項或作為它的代理指標。若用的是標準定義(例如 ICD 代碼),要寫出來並附上引用。8b 若結果需要主觀判讀(例如影像判讀),要寫出判讀者的人數、資格與人口學特徵;測量與判讀若需要額外訓練或特定的操作說明,也要寫出來。8c 要說明有沒有讓結果評估者對預測因子的資訊設盲,以避免標籤洩漏(label leakage)。
條目 9(三個子條目,9a 只適用開發研究)。 9a 要說明最初那批候選預測因子如何挑選(文獻回顧、既有模型、臨床專家意見,或就是資料裡全部的變項),以及建模前有沒有做過任何預先篩選、依據為何(例如遺漏過多、或臨床上不合理)。9b 要清楚定義所有預測因子,包含測量單位、類別變項之所有分類、怎麼測、什麼時候測,並注意預測因子必須在模型預定使用的時間點之前或當下就測得到;診斷模型之預測因子測量要對結果以及其他預測因子設盲,否則會人為放大關聯。9c 若預測因子需要主觀判讀,要寫出判讀者的資格與人口學特徵;測量與判讀若需要額外訓練或特定的操作說明,也要寫出來。
條目 10。 要說明樣本數如何決定,開發與評估分開敘述,並論證該規模足以回答研究問題,附上樣本數估算所用的全部估計值。若無進行正式估算(例如使用手上所有資料),仍然要論證該數量是否足夠。
條目 11。 要說明遺漏值如何處理:每一個候選預測因子的遺漏筆數、對遺漏原因的假設、有沒有因為遺漏而排除個案或變項與其理由。若執行插補,要寫出完整方法,並確認插補是在訓練資料與測試資料上分別進行,以避免資料洩漏。
條目 12(七個子條目,是全表最長的一項)。 12a(開發)要說明資料在分析中怎麼用、有沒有切分、為什麼這樣切(開發、調參、評估、內外部交叉驗證),切分後各份的樣本數是否充足,並確認沒有資料洩漏(data leakage);若同一個人在資料中有多筆紀錄,要確認沒有個體跨越訓練與測試的切分。12b(開發)要說明預測因子在分析中怎麼處理:函數形式、重新尺度化、轉換、標準化,類別變項若進行合併,要給細節與理由。12c(開發)要指明模型的類型與選它的理由、所有建模步驟、調了哪些超參數與怎麼調、內部驗證採用何種方法(k 折交叉驗證或拔靴法),並說明建模步驟有沒有在內部驗證中完整重跑,以及有無檢查模型穩定性。若最後有主推的模型,要清楚說明是依什麼準則進行挑選。若資料中同一個人有多筆紀錄或多個樣本,要說明建模與內部驗證時怎麼處理,例如用 k 折交叉驗證時,要確認同一個人的所有紀錄或樣本都落在同一折。12d 要說明參數估計值與模型表現在不同群集(醫院、國家)之間的異質性有沒有處理與量化、怎麼做,原文並指出可以參考 TRIPOD-Cluster 的補充建議。12e 要列出所有用來評估模型表現的指標與圖以及選它們的理由,原文寫明一般預期至少要呈現鑑別力與校準度,且包含校準圖;時間至事件的結果要說明如何處理設限與競爭風險,預後模型要列出所有評估時間點;比較多個模型時,要說明比較方法與判定優劣的標準。12f(只適用評估研究)要說明評估後有無進行模型更新(例如重新校準或重新配適),是整體做還是針對特定群體或場域。12g(只適用評估研究)要說明如何計算模型之預測值(公式、程式碼、軟體物件或 API)。評估既有模型時,要交代個別預測值的計算方法;若該模型並非可公開取得,要說明預測值是如何取得。若評估的是迴歸方程式,要提供該方程式(把方程式列出來,或引用原始的開發研究)。若評估的模型沒有方程式(例如類神經網路、隨機森林),要說明預測值的產生方式,例如程式碼、軟體物件或 API,並寫出處(網址或 DOI)。若把模型的個別預測值拿來建立風險分組或分類,而這些分組不是模型開發時就訂好,要說明怎麼做與執行原因(見條目 15)。
說明:資料洩漏(data leakage)定義為測試資料的資訊在訓練階段就被模型看到,導致表現被高估。
條目 13。 若使用類別不平衡的處理方法(欠抽樣、過抽樣、SMOTE),要說明原因、做法,並考慮對樣本數的影響。本項容易被忽略的後果為不平衡校正會影響校準度,使得估計機率偏高,進而影響風險分組的界定,因此還要說明校準模型或預測值的方法。
條目 14。 要說明處理模型公平性的方法與理由。此處的公平性指模型不會依據種族、性別、年齡這類個人屬性,對個人或群體造成歧視。有兩點需要澄清:資料涵蓋具代表性的群體有其必要,但光有代表性並不等於公平;若模型在缺少某些群體的資料上開發,就需要另外在有代表性的資料中評估這些群體。
條目 15(只適用開發研究)。 要指明模型輸出是機率還是分類。若把輸出轉成分類或風險分組,要說明理由(放在照護流程的脈絡下,這些分組要支援哪個臨床決定),並寫出切點訂定方式(文獻、臨床指引、統計考量,還是臨時決定)。若呈現個別預測值的不確定區間,也要說明計算方式。
條目 16。 要指出開發資料與評估資料在照護場域、納入條件、結果變項與預測因子定義上有哪些差異。在一個場域開發的模型,換到另一個場域不必然還能用;把差異寫清楚,別人才能解讀表現為什麼不一樣。
條目 17。 要寫出核准本研究的機構審查委員會或倫理委員會名稱,並說明受試者知情同意的取得方式或倫理委員會對知情同意的豁免。若未經倫理審查,要明確講出來並說明原因。
Open science|開放科學(條目 18a 到 18f)
這一類問的是:別人能不能查證你的研究。
條目 18(六個子條目)。 這次改版新增開放科學區塊,新增的是計畫書、註冊、資料共享與程式碼共享四格,經費與利益衝突並不是這次新增的。整個區塊共六格:18a 經費來源與資助者在本研究中的角色(以及所有作者的其他經費來源);18b 所有作者的利益衝突與財務揭露,凡是讀者可能認為與研究相關、或可能影響研究設計、執行、解讀與報告的關係或活動都要揭露;18c 研究計畫書的存放位置(出版資訊、補充材料,或公開儲存庫的網址或 DOI),沒寫計畫書就明確寫出來並說明原因,若實際執行與計畫書有明顯出入,要摘要說明與理由;18d 註冊資訊(註冊機構名稱、註冊編號與連結),沒有註冊也要明確寫出來;18e 資料可得性,包含取得位置、取得方式、條件或限制,並附資料字典,不能共享要說明原因,原文直接點名要避免「可依合理要求提供」這種條件未明的寫法;18f 分析程式碼可得性,包含取得位置、取得方式、授權條件與版本,以及如何執行程式碼的說明文件,這裡的程式碼指原則上能重現所有結果的全部程式碼,含資料清理,並要交代軟體與套件(含版本號),必要時交代運算環境。其中必須明講「沒有」的是 18c 沒寫計畫書與 18d 沒有註冊這兩格;18e 與 18f 若不能共享,要說明原因。
Patient and public involvement|病人與公眾參與(條目 19)
這一類問的是:研究有沒有讓病人或公眾參與,以及參與到什麼程度。
條目 19。 要說明病人或公眾在研究的設計、執行、報告、解讀或推廣過程中如何參與,或者明確聲明沒有參與;研究結果有沒有向病人或公眾呈現,也要寫。原文建議參考 GRIPP2 聲明報告參與情形。此為這次改版新增的條目,沒有參與也要寫,不能留白。
Results|結果(條目 20 到 24)
這一類問的是:你算出來的數字,別人能不能看懂來自哪批人、哪一次分析。
條目 20(三個子條目)。 20a 要描述參與者在研究中的流動,包含有結果事件與沒有結果事件的人數,以及必要時追蹤時間的摘要,用流程圖會有幫助;流程圖裡也建議標出遺漏值的人數與結果事件數。20b 要報告整體特徵,並在必要時依資料來源或場域分開報告,內容包含關鍵日期、主要預測因子(含人口學)、接受過的治療、樣本數、結果事件數、追蹤時間,以及每一個預測因子的遺漏個數與比例,用表呈現會有幫助,並報告關鍵人口學群體之間的差異。20c(只適用評估研究)要對照評估資料與開發資料的重要變項分布(人口學、模型中的預測因子、結果變項,含遺漏比例)。
條目 21。 要寫出每一次分析各自的參與者人數與結果事件數(模型開發一次、調參一次、模型評估一次,各報各的)。這些數字在一篇預測模型論文裡常常不一樣,切分過、調參過、有遺漏值,都會讓它變動。若同一個人有多筆紀錄,還要另外報告人數。
條目 22(只適用開發研究)。 模型開發研究的產出就是模型本身,所以要提供完整的預測模型(公式、程式碼、軟體物件或 API),讓別人能對新個體做出預測、讓第三方能評估與實作,並說明取用或再利用上的限制(例如免費取得,或屬商業專有),必要時附上硬體與軟體套件的需求。因為商業理由不能公開的,要明確寫出來,並說明取得條件。若開發多個模型,每一個模型的取得方式都要交代。
條目 23(兩個子條目)。 23a 要報告所有效能估計值並附信賴區間,包含關鍵次族群(例如性別、族裔)的表現,並建議用圖輔助(校準圖要畫平滑校準曲線並附預測值的分布,決策曲線也建議附上);所有做過的評估都要報(開發資料上的、評估資料上的、內部驗證流程得到的),預後模型要報每一個時間點,並明確標示每一個估計值來自哪批資料。23b 若檢視過跨群集的表現異質性,要把結果連同信賴區間一起報。
條目 24(只適用評估研究)。 若做模型更新,要報告更新後的模型本身與其表現,並比照條目 22 說明第三方要如何取得與實作。
Discussion|討論(條目 25 到 27)
這一類問的是:你怎麼解讀自己的結果,以及模型接下來能不能真的被用。
條目 25。 要在研究目的與既有研究的脈絡下,對主要結果做整體解讀,並納入公平性議題。若同題目已有模型或已有其他人評估過同一個模型,要把你的發現放進那些結果裡一起討論;結果分歧時,要討論可能的原因。原文特別提醒:解讀不得超出開發與評估實際得到的結果,避免過度詮釋。
條目 26。 要討論研究的限制(樣本不具代表性、樣本數、過度配適、遺漏值等),以及這些限制對偏差、統計不確定性與概化性(generalisability)的影響。限制要具體討論,不是列幾個名詞帶過。
條目 27(三個子條目)。 27a(只適用開發研究)要說明模型實際使用時,輸入資料品質不佳或缺漏該如何判斷與處理;若打算在使用當下做插補,做法也要先進行評估(因此方法段與結果段也要提到)。27b(只適用開發研究)要說明使用者是否需要介入輸入資料的處理或模型的操作,以及需要哪種程度的專業或訓練。27c 要說明後續研究的下一步:是還需要在不同族群或次族群中評估,還是已經可以進入臨床試驗或實際導入照護流程;討論時要特別著眼於模型的適用性與概化性。
摘要專用清單:TRIPOD+AI for Abstracts 的 13 項
此為一份獨立的清單,非主表之縮寫版。改編自 2020 年的 TRIPOD for Abstracts,並依 TRIPOD+AI 更新過。
| 區塊 | 項次 | 內容 |
|---|---|---|
| 標題 | 1 | 指明這是在開發或評估一個多變項預測模型、目標族群、要預測的結果變項 |
| 背景 | 2 | 簡短說明醫療情境,以及開發或評估所有模型的理由 |
| 目的 | 3 | 指明研究目的,包含這篇是開發、評估,還是兩者 |
| 方法 | 4 | 描述資料來源 |
| 方法 | 5 | 描述納入條件,以及資料收集的場域 |
| 方法 | 6 | 指明模型要預測的結果變項;預後模型還要包含預測的時間範圍 |
| 方法 | 7 | 指明模型類型、建模步驟摘要與內部驗證方法(只適用開發研究) |
| 方法 | 8 | 指明用來評估模型表現的指標(例如鑑別力、校準度、臨床效用) |
| 結果 | 9 | 報告參與者人數與結果事件數 |
| 結果 | 10 | 摘述最終模型中的預測因子(只適用開發研究) |
| 結果 | 11 | 報告效能估計值,並附信賴區間 |
| 討論 | 12 | 對主要結果做整體解讀 |
| 註冊 | 13 | 提供註冊編號與註冊機構或儲存庫名稱 |
(表格較寬,手機可左右滑動檢視)
適用性:哪些條目只適用開發、哪些只適用評估
主表的每一列都標了 D、E 或 D;E。D 指開發研究,E 指評估研究,D;E 指兩種研究都適用。52 列中有 40 列是 D;E,剩下 12 列分成兩組。
只適用開發研究(D,共 8 項)
| 條目 | 內容 |
|---|---|
| 9a | 最初候選預測因子的選擇與建模前的預先篩選 |
| 12a | 資料在分析中怎麼用、有沒有切分、有沒有資料洩漏 |
| 12b | 預測因子在分析中如何處理(函數形式、尺度化、轉換、標準化) |
| 12c | 模型類型、理由、建模步驟、超參數調整、內部驗證 |
| 15 | 模型輸出是什麼(機率或分類)、切點怎麼定 |
| 22 | 提供完整的預測模型,讓第三方能評估與實作 |
| 27a | 實際使用時,輸入資料品質不佳或缺漏怎麼處理 |
| 27b | 使用者需不需要介入、需要什麼程度的專業 |
(表格較寬,手機可左右滑動檢視)
只適用評估研究(E,共 4 項)
| 條目 | 內容 |
|---|---|
| 12f | 評估後的模型更新(重新校準或重新配適)方法 |
| 12g | 模型的預測值是怎麼算出來的(公式、程式碼、物件、API) |
| 20c | 評估資料與開發資料在重要變項分布上的對照 |
| 24 | 模型更新的結果,包含更新後的模型與其表現 |
(表格較寬,手機可左右滑動檢視)
條目 12 橫跨兩邊:12a 到 12c 標 D,12d 與 12e 標 D;E,12f 與 12g 標 E。同一篇論文若既開發也評估模型,52 列全部都要對。
對應的 E&E 使用方式
上面的導讀為精簡版。TRIPOD+AI 另有一份官方的擴充清單,全名 Expanded Checklist(Explanation & Elaboration Light),共 14 頁,每一列條目下面都附有數點展開說明。若要了解特定項次應該寫到什麼程度,可檢視文件對應頁次之內容:
| 你要查的區塊 | 去 E&E Light 的哪幾頁 |
|---|---|
| 標題、摘要、前言(條目 1 到 4) | 第 1 到 2 頁 |
| 方法:資料與參與者(條目 5 到 6) | 第 2 到 3 頁 |
| 方法:資料準備與結果變項(條目 7 到 8) | 第 3 到 4 頁 |
| 方法:預測因子、樣本數、遺漏值(條目 9 到 11) | 第 4 到 5 頁 |
| 方法:分析方法(條目 12a 到 12g) | 第 5 到 8 頁 |
| 方法:不平衡、公平性、模型輸出(條目 13 到 15) | 第 8 頁 |
| 方法:開發與評估的差異、倫理(條目 16 到 17) | 第 9 頁 |
| 開放科學(條目 18a 到 18f) | 第 9 到 10 頁 |
| 病人與公眾參與(條目 19) | 第 10 頁 |
| 結果(條目 20 到 24) | 第 10 到 12 頁 |
| 討論(條目 25 到 27) | 第 13 到 14 頁 |
(表格較寬,手機可左右滑動檢視)
兩點使用上的提醒。第一,多數沿用自 2015 年的條目,其背後的說明仍以 2015 年版的 Explanation and Elaboration 論文為主(Moons 等人,Ann Intern Med 2015),要更詳細的說明可以回去查那一篇。第二,27 項為最低報告建議,不是上限;指引不規定每一項該出現在文章的哪個位置,也允許把部分內容放進補充材料。只有一種情況要特別處理:某一項因為資訊未知或不適用而無法報告時,原文要求你明確承認並以文字說明。
下一期起
第 5 期談核心指標的圖形:鑑別力、校準度、臨床效用各自長什麼樣,一張校準圖怎麼看出模型是高估還是低估。
第 6 期談模型效能的比較:兩個模型要怎麼比、判定優劣的標準該怎麼寫(對應條目 12e 與 23a)。
第 7 期談常被退稿的原因:審稿意見最常打回來的幾類問題,分別對應清單上的哪幾項。
第 8 期做完整的標竿文獻解析:拿一篇實際發表的預測模型論文,對著 52 列逐項看它怎麼寫。
附錄:52 個編號子條目一覽
| 區塊 | 編號 | 適用 | 主題 |
|---|---|---|---|
| 標題 | 1 | D;E | 標題 |
| 摘要 | 2 | D;E | 摘要(對 13 項摘要清單) |
| 前言 | 3a | D;E | 醫療情境與研究理由 |
| 前言 | 3b | D;E | 目標族群、預期用途與使用者 |
| 前言 | 3c | D;E | 已知的健康不平等 |
| 前言 | 4 | D;E | 研究目的 |
| 方法 | 5a | D;E | 資料來源、理由與代表性 |
| 方法 | 5b | D;E | 收案與追蹤的起訖日期 |
| 方法 | 6a | D;E | 研究場域、中心數與位置 |
| 方法 | 6b | D;E | 納入與排除條件 |
| 方法 | 6c | D;E | 治療的接受與處理方式 |
| 方法 | 7 | D;E | 資料前處理與品質檢查 |
| 方法 | 8a | D;E | 結果變項定義與時間範圍 |
| 方法 | 8b | D;E | 結果判讀者的資格與特徵 |
| 方法 | 8c | D;E | 結果評估的設盲 |
| 方法 | 9a | D | 候選預測因子的選擇與預先篩選 |
| 方法 | 9b | D;E | 預測因子的定義與測量 |
| 方法 | 9c | D;E | 預測因子判讀者的資格與特徵 |
| 方法 | 10 | D;E | 樣本數的決定與論證 |
| 方法 | 11 | D;E | 遺漏值的處理 |
| 方法 | 12a | D | 資料的使用與切分 |
| 方法 | 12b | D | 預測因子在分析中的處理 |
| 方法 | 12c | D | 模型類型、建模步驟與內部驗證 |
| 方法 | 12d | D;E | 跨群集的異質性 |
| 方法 | 12e | D;E | 效能指標與圖的選擇 |
| 方法 | 12f | E | 模型更新的方法 |
| 方法 | 12g | E | 預測值的計算方式 |
| 方法 | 13 | D;E | 類別不平衡的處理與重新校準 |
| 方法 | 14 | D;E | 公平性的處理方式與理由 |
| 方法 | 15 | D | 模型輸出與切點 |
| 方法 | 16 | D;E | 開發資料與評估資料的差異 |
| 方法 | 17 | D;E | 倫理審查與知情同意 |
| 開放科學 | 18a | D;E | 經費來源與資助者角色 |
| 開放科學 | 18b | D;E | 利益衝突與財務揭露 |
| 開放科學 | 18c | D;E | 研究計畫書的取得 |
| 開放科學 | 18d | D;E | 研究註冊資訊 |
| 開放科學 | 18e | D;E | 資料可得性 |
| 開放科學 | 18f | D;E | 分析程式碼可得性 |
| 病人與公眾參與 | 19 | D;E | 病人與公眾參與 |
| 結果 | 20a | D;E | 參與者流動與流程圖 |
| 結果 | 20b | D;E | 各資料集的特徵 |
| 結果 | 20c | E | 與開發資料的分布對照 |
| 結果 | 21 | D;E | 每次分析的人數與事件數 |
| 結果 | 22 | D | 完整模型的提供 |
| 結果 | 23a | D;E | 效能估計值與信賴區間 |
| 結果 | 23b | D;E | 跨群集的效能異質性結果 |
| 結果 | 24 | E | 模型更新的結果 |
| 討論 | 25 | D;E | 整體解讀 |
| 討論 | 26 | D;E | 研究限制 |
| 討論 | 27a | D | 輸入資料品質不佳或缺漏的處理 |
| 討論 | 27b | D | 使用者的介入與所需專業 |
| 討論 | 27c | D;E | 後續研究的下一步 |
(表格較寬,手機可左右滑動檢視)
TRIPOD+AI 檢查的是報告有沒有寫齊,不檢查模型本身建得對不對。從研究設計、預測因子篩選、模型效能評價到列線圖,那是另一套要動手做的能力。
我們把這一段做成一門線上課:
參考文獻
- Collins GS, Moons KGM, Dhiman P, Riley RD, Beam AL, Van Calster B, et al. TRIPOD+AI statement: updated guidance for reporting clinical prediction models that use regression or machine learning methods. BMJ. 2024;385:e078378. https://doi.org/10.1136/bmj-2023-078378
- TRIPOD+AI Expanded Checklist (Explanation & Elaboration Light), version 7 February 2024. Supplementary material to Collins et al. 2024. www.tripod-statement.org
- Moons KGM, Altman DG, Reitsma JB, Ioannidis JPA, Macaskill P, Steyerberg EW, et al. Transparent Reporting of a multivariable prediction model for Individual Prognosis or Diagnosis (TRIPOD): explanation and elaboration. Ann Intern Med. 2015;162(1):W1-73. https://doi.org/10.7326/M14-0698
授權說明:本文所列 27 項主條目、52 個子條目與 13 項摘要清單的內容,均譯自參考文獻 1 及其官方補充清單(參考文獻 2)。該文以 CC BY 4.0 授權發布,明文允許包含商業使用在內的重製與改作,惟須標明出處。本文依該授權轉譯並標明來源。
AI 使用聲明
本文由匯東華統計顧問有限公司 陳秀敏 博士撰稿,Claude Opus 5 協助原文檢索、條目核對與版面排版,最終內容已由作者審閱定稿。文中所有條目編號、條目內容、D 與 E 的適用標示與數字,均取自上列 BMJ 原文與其官方補充清單,並經逐頁回原文核對。日期:2026 年 9 月 4 日。
同期其他單元
- 統計方法實務|設置虛擬變數的 SPSS 實作與常見錯誤:從建立虛擬變數到解讀係數,Step by Step
- AI 工具實務|ChatGPT 回答總是差一點?8 個短指令,立即修正太難、太長、太亂與太像 AI
- 研究誠信與 AI 治理系列 No. 03|你叫 AI 檢查自己的工作,它檢查了,然後還是把有問題的結論交給你
匯東華電子報 第 4 期|2026.09.04|看本期網頁版 →
聯絡我們
- LINE:@medatatw
- Email:info@medatatw.com
- 電話:07-9721586
- 官網:www.medatatw.com

統計分析
服務價目表 (未含5%營業稅)
透過嚴謹的數據整理,提供有價值的資訊,形塑知識,提高決策品質。包括信達雅三執行原則。
信:確保資料品質可信賴
達:確保統計方法適切性
雅:確保圖文表格正規化
協助代執行統計分析與進一步加值服務。
在匯東華與夥伴的專業背景知識配合下,能有效地處理面對的問題。
統計分析成果

數據串接與清洗
數據是礦藏,數據清洗是挖出鑽石的第一步,尤其是巨量知識。數據清洗或串接執行過程需要細心與專注,且有可能會消耗許多時間和精力,就由我們來替各位處理掉這個大麻煩。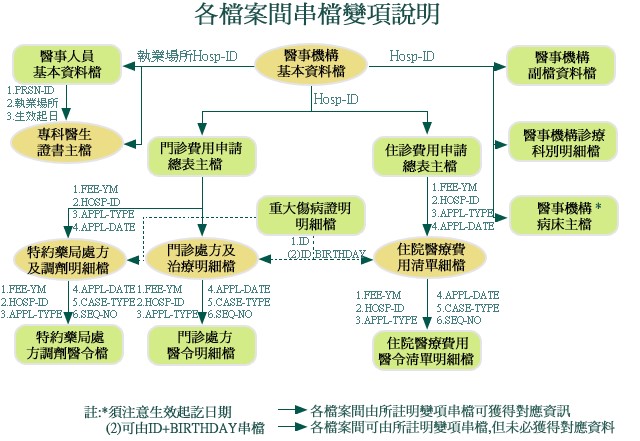
全民健保研究資料庫、國外大型資料庫資料非常齊全,種類多,需要串接與清洗,進行正規化後才能更進一步進行資料探勘與統計分析。
Fig1.同一個Project資料散落在不同tables,無法使用
Fig2.整併與清理為可分析的table
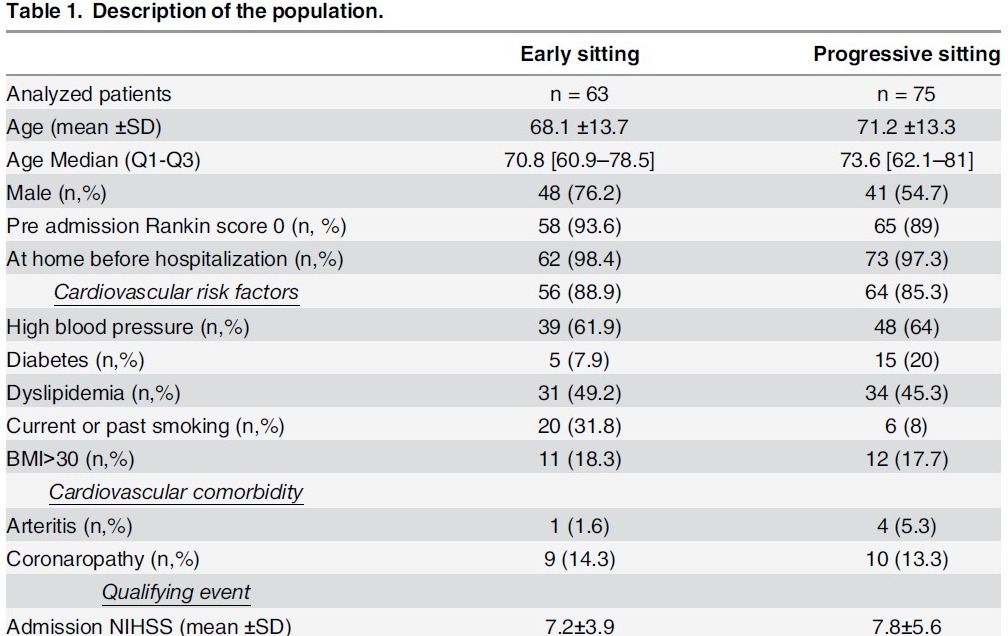
Fig.3整理和分析後形成有意義的知識
概念與流程示意圖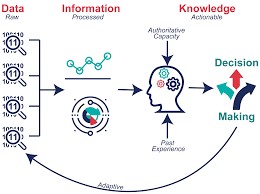

計畫撰寫與統計諮詢
為了讓匯東華的顧客與學員有更好的合作和消費體驗,故匯東華特別依據營業項目開發周邊產品,提供使用、購買。目前已有針對公共衛生師的題庫以及模擬試題,未來將針對醫學研究領域發展產品。