 匯東華統計顧問有限公司
不用重寫整段提示詞,也無須套用複雜提示詞;善用短指令,解決實際痛點。
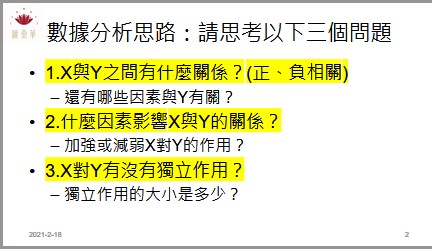
看不懂 /ELI5 先講白話 | 太冗長 /SHORT 直接縮短 |
資訊太亂 /TABLE 整理比較 | 文字太像 AI /HUMAN 恢復自然 |
匯東華電子報 第 4 期|2026.09.04|匯東華統計顧問有限公司|陳秀敏 博士
一頁先懂|核心判斷
文中「/ELI5」「/TABLE」等八個短指令,看起來很像 ChatGPT 介面按「/」就會跳出的內建功能,但它們不是官方功能,只是讓模型理解你意圖的自訂語意速記,沒有產品層級的強制力。輸入「/」根本叫不出這些指令,模型也可能沒有完全照做,而你未必會察覺。
正確做法是:先鎖定目前最困擾你的單一症狀,加入對應的一個短指令即可,不用重寫整段提示詞;若指令沒有生效,就把真正重要的限制寫成完整句子(字數、欄位、成立門檻、不可刪除的內容),因為完整句的明確規格永遠優先於短標記。
以本文八個短指令而言,三件最容易被忽略、卻會影響回答品質與可信度的事:
- 打「/」不會叫出這些指令。它們不是介面內建功能,只是純文字,模型讀到後推測你的意圖,沒有機制保證每次都會照做。
- 回答變好讀,不等於內容更可信。加上如
/ELI5之類的指令後,容易連帶砍掉研究對象、效果強度、不確定語氣、未控制因素這四道推論邊界,句子變順但證據跟著被削掉。 - 一次疊加太多指令會互相衝突。三個以上就要留意條件矛盾,例如同時要求「很短」又要「保留全部細節」,必須先決定哪個條件更重要,而不是全部塞進去。
01|ChatGPT 不是沒回答,而是總差在這八種地方
先別研究提示詞理論。找到現在最困擾你的症狀,就能立刻選指令。
| 你的痛點 | 常見症狀 | 直接加入 | 立即效果 |
|---|---|---|---|
| 看不懂 | 術語太多,讀完仍抓不到核心 | /ELI5 | 換成白話與例子 |
| 太難比較 | 多個方法混在段落裡 | /TABLE | 改成比較表 |
| 不知道怎麼起稿 | 一開始就生成全文,越改越亂 | /OUTLINE | 先取得骨架 |
| 篇幅失控 | 只問一題,卻收到四百字 | /SHORT | 限制生成上限 |
| 只會附和 | 內容有漏洞,模型仍一直稱讚 | /CRITIQUE | 主動找問題 |
| AI 味太重 | 句型整齊、轉折制式、語氣僵硬 | /HUMAN | 恢復自然語感 |
| 不知道缺什麼 | 問題還沒想清楚就急著求答案 | /QUESTIONS | 先問關鍵問題 |
| 廢話太多 | 客套、重述與總結淹沒結論 | /NOFLUFF | 只留有效內容 |
30 秒使用法
把短指令放在問題前面即可。先用一個最符合痛點的指令;若效果不夠,再補上字數、欄位或不可刪除的條件。
現在就試
可直接複製
/NOFLUFF 請說明這份報告最需要我做的三個決定。
你會先感受到回答形式改變;內容是否正確,仍需另外驗證。
02|先用再理解:一個短指令,答案會怎麼變?
短指令的價值不是看起來俐落,而是讓你立刻看見可用的差異。
原始問題
「為什麼 logistic regression 常報告 odds ratio?」
ChatGPT 可能先從公式、logit 與係數轉換從頭開始說明。內容可能過多過於專業,對初學者而言,認知負荷太大,難以聚焦重點。
/ELI5因為 logistic regression 比較的是事件發生與不發生的『勝算』。把係數取指數後,就能得到容易解讀的 OR。注意:勝算不等於機率。 | 再加入 /SHORTLogistic regression 的係數取指數後就是 OR,用來比較兩組勝算;OR 不等於風險比,也不等於機率。 |
八個指令,各自只控制一件事
/ELI5 | 理解難度|講簡單 | /TABLE | 呈現格式|做比較 |
/OUTLINE | 內容結構|先搭骨架 | /SHORT | 回答長度|明確縮短 |
/CRITIQUE | 分析立場|主動挑戰 | /HUMAN | 語言質感|寫得自然 |
/QUESTIONS | 互動方式|先問問題 | /NOFLUFF | 資訊純度|刪除廢話 |
先記這個原則
一次先用一個指令,確認它是否解決主要痛點。只有遇到複合問題時才疊加,避免要求彼此矛盾。
03|看不懂、比不動:先解決閱讀痛點
/ELI5 把難內容講成白話
痛點|術語與公式都看過了,腦中仍沒有一幅能理解的圖。
/TABLE 把資訊排成可比較的欄位
痛點|三個方法分別看得懂,放在一起卻說不出相同與差異。
04|寫不動、收不住:先控制結構與長度
/OUTLINE 先搭骨架,再決定內容
痛點|一開始就請 AI 寫全文,結果每段都有內容,但整篇卻沒有清楚邏輯。
/SHORT 把答案壓進明確上限
痛點|只需要一段摘要,卻收到完整教科書式說明。
05|只會附和、寫得很僵:換掉分析立場與語感
/CRITIQUE 主動找出真正的漏洞
痛點|你想知道哪裡站不住腳,AI 卻只說架構完整、觀點清楚。
/HUMAN 讓專業文字恢復自然節奏
痛點|內容沒有錯,但每段都像模板:首先、其次、此外、綜上所述。
06|問題沒想清楚、答案又有太多廢話:改變互動方式
/QUESTIONS 讓 AI 先問關鍵問題
痛點|你知道想完成什麼,卻還沒掌握哪些資訊會改變方法與結果。
/NOFLUFF 刪掉沒有資訊價值的句子
痛點|答案看似完整,真正有用的結論卻埋在客套與重述等漂亮的廢話裡。
07|一個指令不夠時:直接套用這六種組合
複合痛點才需要疊加。兩個通常夠用,三個以上就要留意條件衝突。
| 你遇到的複合痛點 | 直接組合 | 會得到什麼 | 適用情境 |
|---|---|---|---|
| 太難,而且太長 | /ELI5 /SHORT | 白話、短版解釋 | 初學者快速建立概念 |
| 資料很多,難以比較 | /TABLE /NOFLUFF | 只留必要欄位的比較表 | 文獻與方案盤點 |
| 想先看架構,不要贅述 | /OUTLINE /NOFLUFF | 精簡的階層骨架 | 論文、課程與提案 |
| 要挑錯,但不想像機器審稿 | /CRITIQUE /HUMAN | 直接而自然的批判意見 | 改稿與審查 |
| 不知道怎麼問,又不想聽長篇 | /QUESTIONS /SHORT | 少量關鍵澄清題 | 需求尚未明確時 |
| 要簡單、自然、可直接轉貼 | /ELI5 /HUMAN | 好懂但不幼稚的說法 | 教學與對外溝通 |
穩定的組合順序
| 1 思考模式 | 2 輸出格式 | 3 長度/密度 | 4 不可變條件 |
直接複製
可直接複製
/CRITIQUE /NOFLUFF 檢查這段討論的因果用語與過度推論。只列成立的問題,每項附原句與理由。
衝突時怎麼辦?
完整句的明確規格優先於短標記。若同時要求『很短』又要求『保留全部細節』,請先決定哪個條件更重要。
08|立即見效,不等於提升可信度
短指令能快速改變生成內容的樣子;它不會自動驗證資料、方法與推論。
工具最容易製造一種錯覺:使用後,立即能看見格式變好,就以為內容也同步提升正確性。研究工作中,真正的風險,往往是句子變順,但證據邊界卻被削掉。模型越高階,越能把問題包裝得越漂亮與藏得越隱蔽。
| 原句 | /ELI5 後可能變成 |
|---|---|
| 在這個以住院病人為主的樣本中,兩者呈中度相關,可能受未測量的因素影響。 | 這兩件事有關係。 |
被刪掉的不是贅字,而是四道推論邊界
| 邊界 | 原句中的文字 | 它保護了什麼 |
|---|---|---|
| 研究對象 | 以住院病人為主 | 限制結果可推廣到誰 |
| 效果強度 | 中度 | 避免把弱、中、強關聯混成一樣 |
| 不確定語氣 | 可能 | 避免把推測改寫成確定結論 |
| 未控制因素 | 未測量的因素 | 保留作者已知的證據缺口 |
最安全的雙軌原則
白話版拿來理解;原文拿來引用
寫進論文、報告、簡報或決策文件前,都回到原文核對研究對象、數字、效果方向、限定語、例外與限制。
09|為什麼輸入「/」找不到這八個指令?
因為它們不是 ChatGPT 內建功能,而是讓模型理解意圖的自訂語意速記。
| 比較 | 產品內建斜線命令 | 本文的自訂短指令 |
|---|---|---|
| 本質 | 介面辨識後執行產品動作 | 模型讀到文字後推測你的意圖 |
| 例子 | /model、/review、/status(桌面版)/網頁版為中文動作選單,如圖 1 | /ELI5、/TABLE、/CRITIQUE 等 |
OpenAI 官方文件說明,斜線命令可在對話輸入框內直接執行動作,而且可用項目會因環境與權限而不同。本文八個寫法不在官方清單中;它們的優點是好記、可組合,但沒有產品層級的強制力。
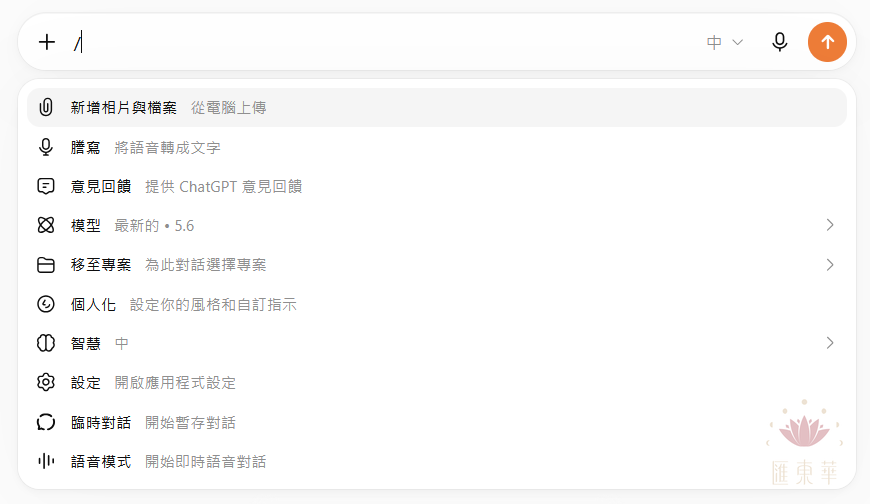
圖1、輸入『/』時,介面顯示的是當下環境可用的內建功能。(ChatGPT 5.6 Sol,2026年9月2日)
(點擊圖片可開啟原圖放大檢視)
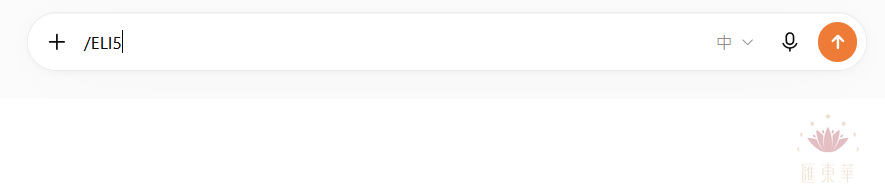
圖2、輸入 /ELI5 只是把文字送給模型理解,不會調用官方功能。
(點擊圖片可開啟原圖放大檢視)
10|模型沒照做?三步把回答拉回來
短指令是啟動器,不是規格書。發現短指令失效時,直接把真正重要的限制寫成完整句。
| 失效訊號 | 直接補上的規格 | 修正示例 |
|---|---|---|
| 還是不夠短 | 字數+保留優先序 | 150 字內;數字與限制不可刪 |
| 表格亂補內容 | 欄位+缺值規則 | 原文未報告一律填 NR |
| 為批判而硬挑錯 | 成立門檻+原句 | 只列有充分理由者並引用原句 |
| 文字自然、主張卻變強 | 不可變內容 | 保留可能、否定詞、引用與數字 |
結語
此八項短指令不限用於 ChatGPT。以 /ELI5 實測 Claude 與 Gemini,理解一致,你可以多加善用。
當你再次遇到看不懂、太冗長、資訊混亂或 AI 味太重的內容,透過本文所介紹的短指令,先讓回答變得可用,再驗證它是否可信。省下重想與重打的時間,但不要把最後的判斷一起外包。
官方資料核對
OpenAI. “Slash Commands.” ChatGPT Learn. Accessed 2 Sept. 2026.
https://learn.chatgpt.com/docs/reference/slash-commands
註:官方頁面說明 ChatGPT 的斜線命令,且可用命令依環境與權限而異。本文兩張介面圖為作者於 ChatGPT 網頁版之實測畫面,只用來說明內建功能與自行輸入文字的差異。
AI 使用聲明
本文由匯東華統計顧問有限公司陳秀敏博士撰稿與專業審定;Claude Opus 5 協助資料檢索與整理,OpenAI Codex 協助結構重整、文字潤飾、版面製作與官方資料核對。所有主張、案例與發布版本均由作者負責最終審閱。
同期其他單元
- 統計方法實務|設置虛擬變數的 SPSS 實作與常見錯誤:從建立虛擬變數到解讀係數,Step by Step
- 臨床預測模型系列 No. 01|臨床預測模型研究寫作指引:TRIPOD+AI 介紹
- 研究誠信與 AI 治理系列 No. 03|你叫 AI 檢查自己的工作,它檢查了,然後還是把有問題的結論交給你
匯東華電子報 第 4 期|2026.09.04|看本期網頁版 →
聯絡我們
- LINE:@medatatw
- Email:info@medatatw.com
- 電話:07-9721586
- 官網:www.medatatw.com

統計分析
服務價目表 (未含5%營業稅)
透過嚴謹的數據整理,提供有價值的資訊,形塑知識,提高決策品質。包括信達雅三執行原則。
信:確保資料品質可信賴
達:確保統計方法適切性
雅:確保圖文表格正規化
協助代執行統計分析與進一步加值服務。
在匯東華與夥伴的專業背景知識配合下,能有效地處理面對的問題。
統計分析成果

數據串接與清洗
數據是礦藏,數據清洗是挖出鑽石的第一步,尤其是巨量知識。數據清洗或串接執行過程需要細心與專注,且有可能會消耗許多時間和精力,就由我們來替各位處理掉這個大麻煩。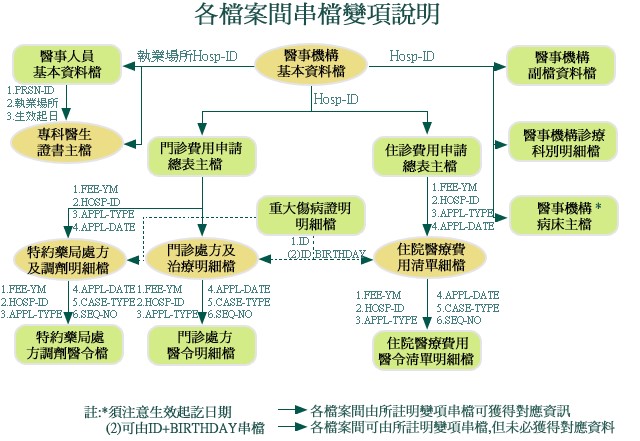
全民健保研究資料庫、國外大型資料庫資料非常齊全,種類多,需要串接與清洗,進行正規化後才能更進一步進行資料探勘與統計分析。
Fig1.同一個Project資料散落在不同tables,無法使用
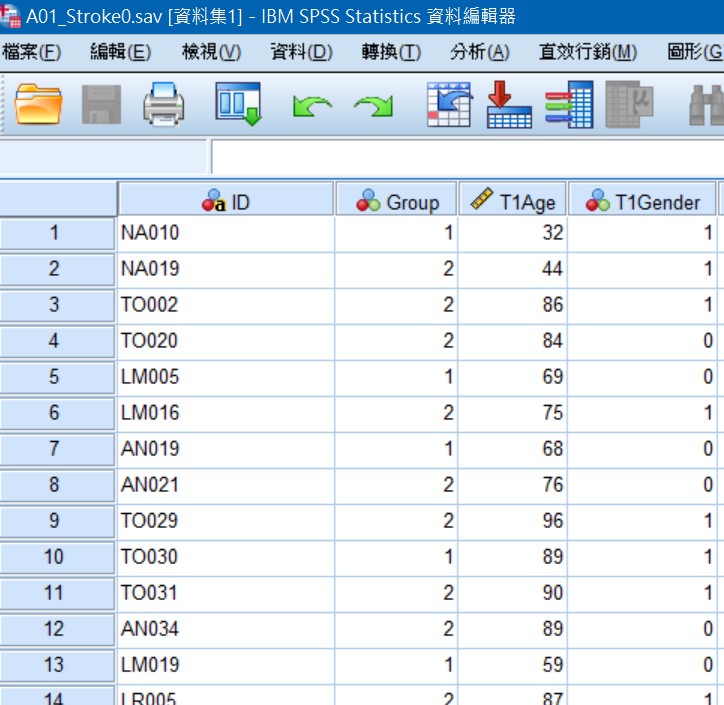
Fig2.整併與清理為可分析的table
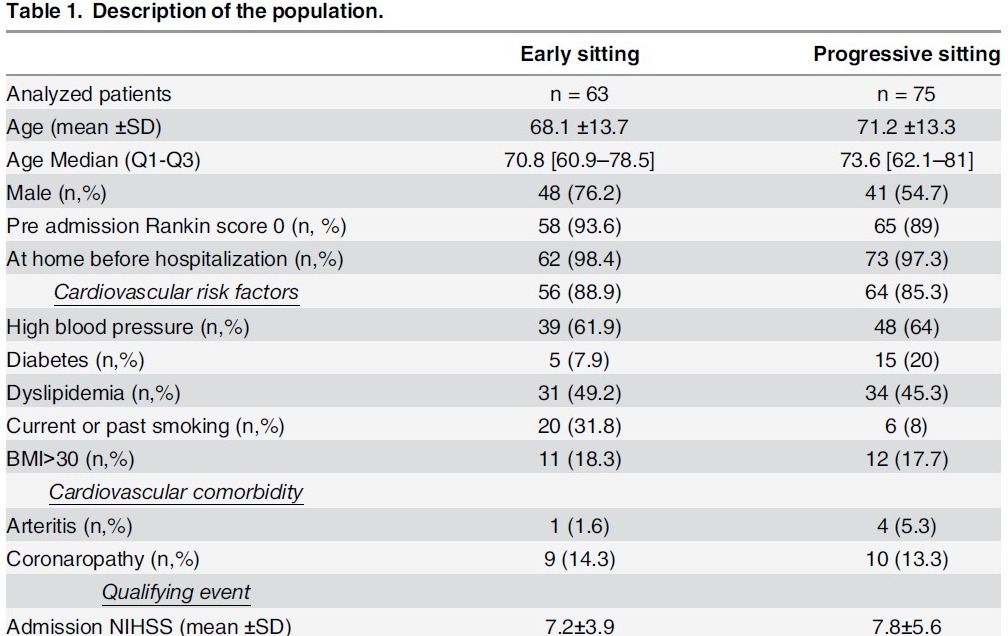
Fig.3整理和分析後形成有意義的知識
概念與流程示意圖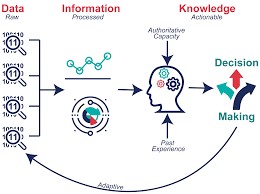

計畫撰寫與統計諮詢
為了讓匯東華的顧客與學員有更好的合作和消費體驗,故匯東華特別依據營業項目開發周邊產品,提供使用、購買。目前已有針對公共衛生師的題庫以及模擬試題,未來將針對醫學研究領域發展產品。