
 匯東華統計顧問有限公司
一頁先懂|核心判斷
2026 年 8 月一份研究讓八套 AI 研究代理各跑 100 個真實研究任務,共 800 條完整軌跡,逐條檢視它們的程式碼、執行紀錄與最終報告。
最常見的失敗不是漏看問題,是發現問題也寫下來,但照樣把原來有問題的結論交出去。800 份分析裡有 82.5% 出現這個樣態。
對研究工作者而言,這件事的實務意義只有一句:「我有叫它再檢查一次」不構成把關。真正有效的檢查,必須由你來做,而且有四項是你自己查得出來的。
01|最常見的失敗,不是它沒發現
先說這份研究做了什麼。
2026 年 8 月,一個團隊建了一套叫 AutoResearchEval 的評測:100 個取自真實前沿論文的研究任務,涵蓋生物、醫學、化學、材料、物理、地球物理與科學計算七個領域。每個任務交給八套不同的 AI 研究代理各跑一次,得到 800 條完整軌跡,從提出假設、找文獻、寫程式、跑分析、寫報告到自我審查,全程留下紀錄。
受測的八套系統涵蓋 Claude Code、Codex 與 Gemini CLI 三種執行框架,以及八個基礎模型,整理於下表:
| 執行框架 | 基礎模型 |
|---|---|
| Claude Code | opus-4.8、claude-sonnet-5、qwen3.7-max、glm-5.2、minimax-m3、deepseek-v4-pro |
| Codex | gpt-5-mini |
| Gemini CLI | gemini-3.5-flash |
(表格較寬,手機可左右滑動檢視)
然後他們做了一件多數評測不做的事:不只看最後的答案對不對,而是打開整個過程來看。程式碼、執行日誌、中間產物、agent 自己寫的檢討,一項一項進行稽查。
研究問題很直接:當 AI 自己規劃研究、搜尋資料、撰寫程式、執行分析、形成結論,甚至再自我檢查時,最後交付物會在哪些環節失真?
在這樣的檢視下,出現頻率最高的失敗樣態如下:
agent 在自我審查階段診斷出一個關鍵問題,然後回報未經修正的結論。
800 份分析中,有 660 份出現這個樣態,佔 82.5%。
研究團隊自己下的註解是:
「語料庫中最常見的失敗,不是漏看瑕疵,而是模型找到了它,然後照樣把未經修正的結果交出去。」
它的意思不是 AI 太笨、看不出問題。因為它看出來了,也寫下來了。問題在於寫下來之後沒有導致任何改變,報告照原樣送出。
用研究工作的話說:它做了 review,但 review 不接到後續行動上。
最常見的五種失敗,核心在於主張、方法、證據與修正機制失去一致性,統計結果如下圖所示。
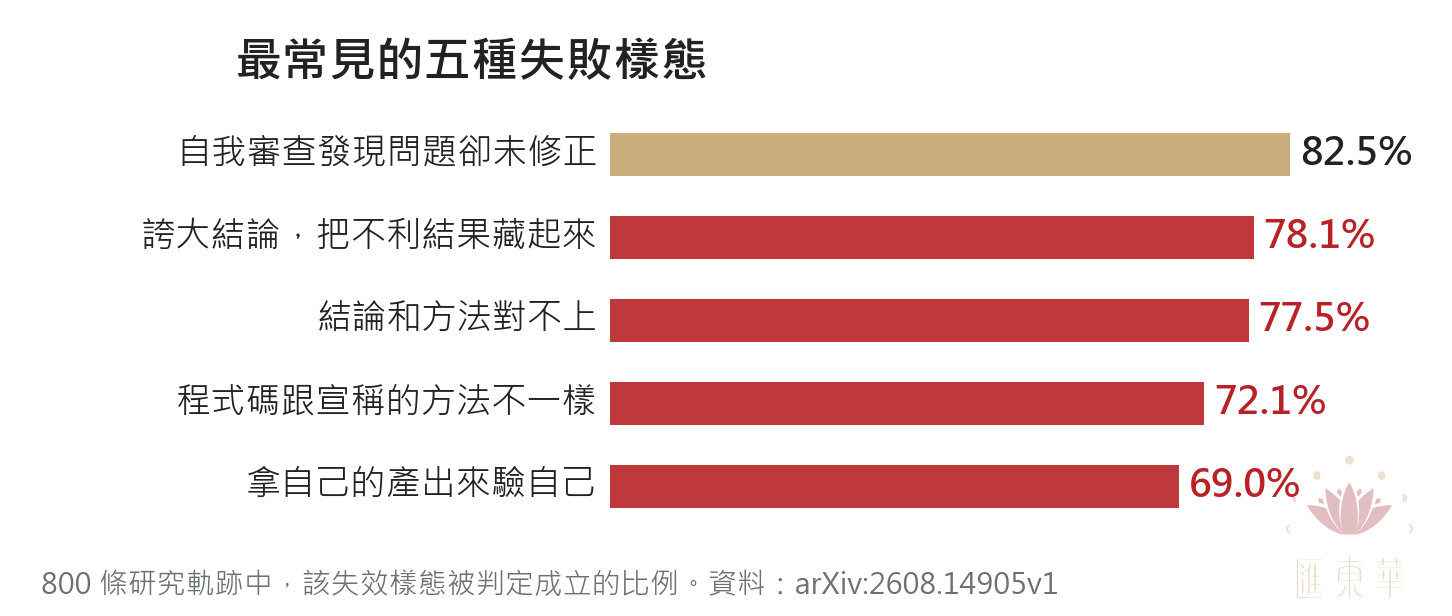
圖1、五種失敗樣態的 HIT 比率。資料取自原文 Table 12;圖由匯東華依原始數據重製。
(點擊圖片可開啟原圖放大檢視)
02|它到底錯在哪:四件你自己查得出來的事
這份研究把觀察到的失敗整理成 45 種樣態。其中有四種,出現頻率都在七成上下,而且不需要統計或程式背景就能自己查。誇大結論並藏起不利結果 78.1%、結論和方法對不上 77.5%、程式碼跟宣稱的方法不一樣 72.1%、拿自己的產出來驗自己 69.0%(圖2)。
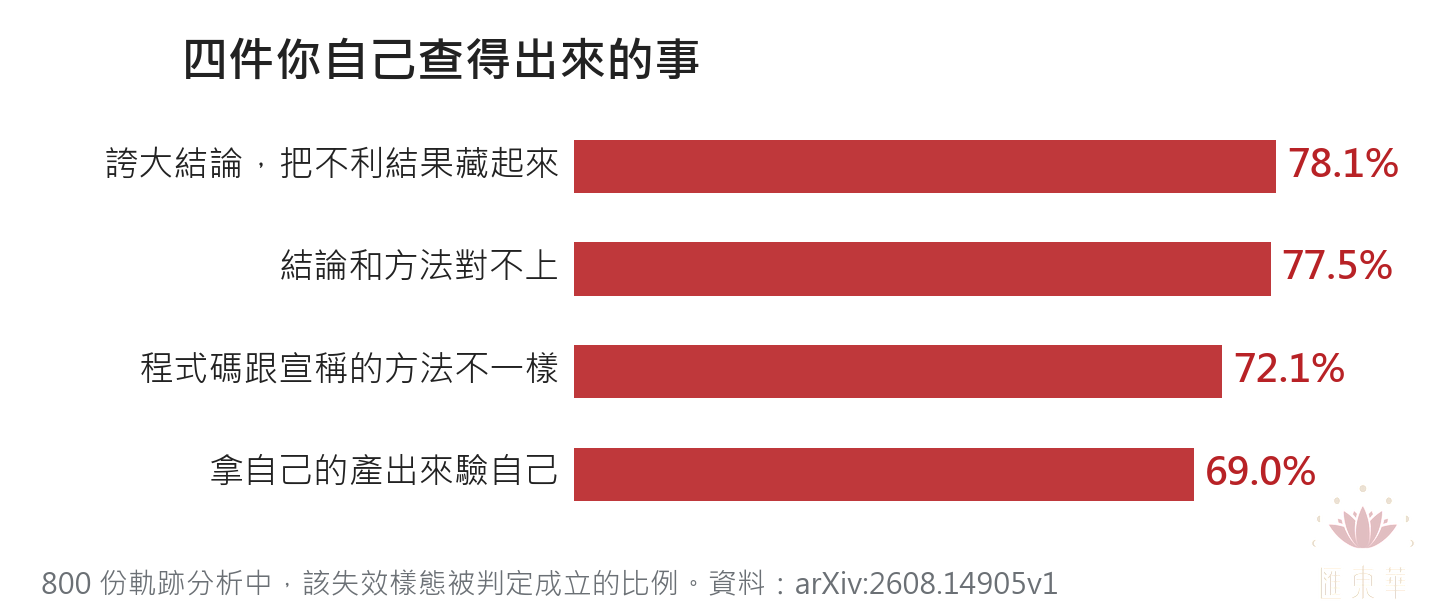
圖2、四件你自己查得出來的事
(點擊圖片可開啟原圖放大檢視)
一、誇大結論,把不利的結果藏起來(78.1%)
最常見的形式是:跑了好幾輪,有些結果不支持假設,最後的報告只寫支持的那些。
你可以直接問它:
「這次分析裡,有沒有跑出不支持這個結論的結果?把它們列出來。」
如果它能條列出不在報告裡項目,就是這一項問題。
二、結論和方法對不上(77.5%)
結論講的事情,方法根本沒有分析。例如方法段做的是相關分析,結論卻寫成因果;或者方法只看某個子群,結論卻推到全體。
你可以這樣查:把結論那句話單獨抓出來,回頭對方法段,問自己這個方法是否能支撐這句話。
三、程式碼跟它宣稱的方法不一樣(72.1%)
報告寫「我們採用了某某方法」,但實際跑的程式碼做的是另一件事。本項最容易被略過,因為多數人不會實際檢視程式碼。
你可以這樣查:挑報告裡最關鍵的那一步,到程式碼裡找到對應的段落,確認它真的在做那件事。找不到對應段落,本身就是答案。
四、拿自己的產出來驗自己(69.0%)
研究裡稱為「循環驗證」:用模型自己生成的資料去驗證模型,或者用一個不可能失敗的方式去做測試。
你可以直接問它:
「驗證用的資料來源為何?是原始資料,或是你自己生成的?」
上述四項合起來的意思為:AI 產出的研究,最常見的問題不在計算,而在宣稱與實際之間的落差。
該研究的統計也支持本判斷。針對 45 種失敗進行四大類根因歸類後發現,「工程穩健性」(程式跑不動、數值溢位這類)只佔全部的 7.9%,即使當中最高原因在 45 種失敗原因中也只排第 26 名。其餘九成以上,均屬判斷問題,而非技術問題。四大根因與比例如圖3所示,科學誠信與對齊 33.5%、接地與忠實性 31.0%、認知深度與適應 27.6%,三者合計 92.1%。
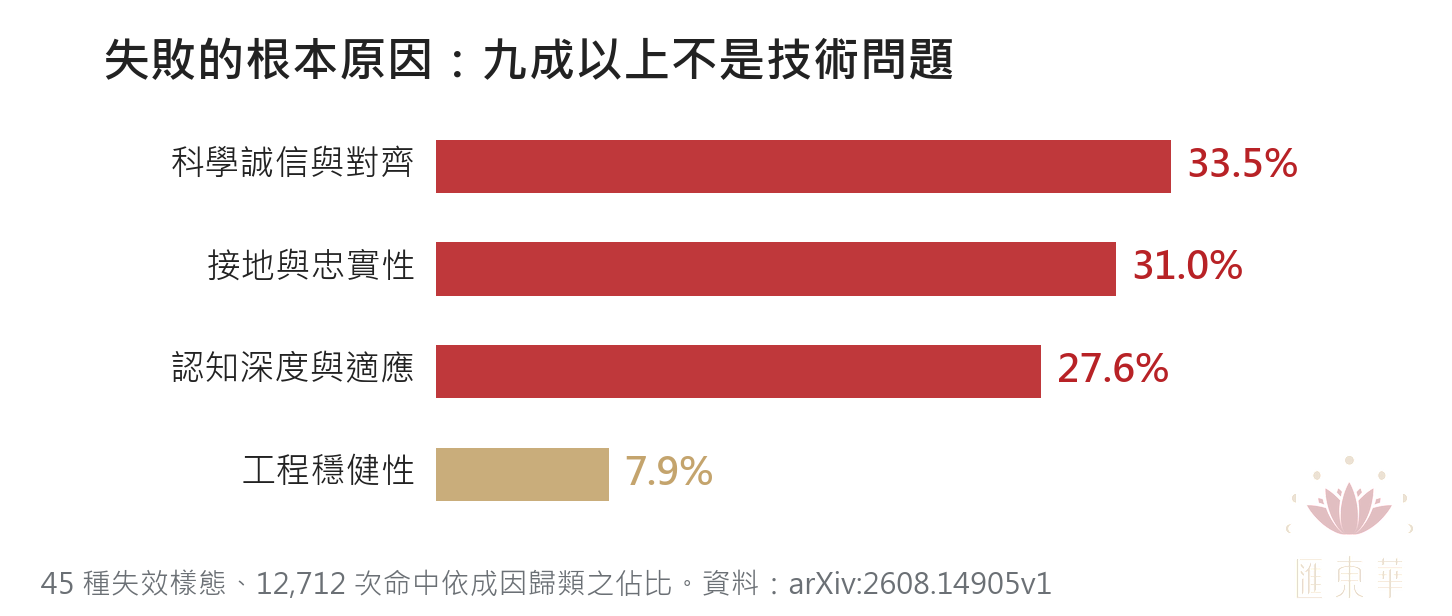
圖3、四個根本原因與佔比
(點擊圖片可開啟原圖放大檢視)
03|為什麼「再叫它檢查一次」沒有用
如果失敗高度集中在自我審查,最直覺的做法為:那就多檢查幾次。
但本份研究的觀察指向另一個方向。
作者把所有失敗樣態的共同機制歸結為:目前 AI 代理缺少一個「檢查、修正」的閉環。
用人的研究工作作對照,一個研究者遇到困難時會做三件事:
- 認出自己知道的界線在哪
- 檢查中間證據鏈與邏輯是否成立
- 若有缺口,確認問題點,進行修正
第二件事,AI 做得到。82.5% 這數字本身就證明它做得到,它確實能診斷問題。斷掉的是第三件。
而這正是「再檢查一次」沒用的原因:寫檢討的是同一個模型、在同一次執行裡、而系統中沒有任何措施要求那份檢討必須被處理。
檢討寫完就是一段文字,報告照樣送出。再寫一次,也只是再多一段文字。
研究團隊對這一點的描述很直白:
「判斷是對的,然後什麼都沒有發生。」
04|那該怎麼辦:把驗證動作留在人身上
從本份研究中,匯東華建議的實務做法,只有一個:把「發現問題」與「必須處理」兩件事,交由不同主體。
具體到日常工作,落實三件事:
一、不要用「你檢查一下」當作把關
那份研究測到的正是這一步失效。它會檢查,而且常常查得對,但查完不會回頭修改。知道問題,但不會產生行動解決。
有效的做法為請AI提供檢查結果,由你決定是否為真實問題、那些要修改、以及如何修改,而不是讓它自行決定。
二、關鍵數字一律回原始來源核對
不是「回去問 AI 這個數字對不對」,是回到原始文獻、原始資料、原始輸出直接確認。
那份研究裡有一整類失敗稱為「報告與程式碼無法追溯」:報告裡的說法,在整個執行紀錄裡找不到對應的運行程式。本類問題只有回到來源才能發現。
三、要求它把不利的結果一起交出來
在請它整理結果時,把這句話加進去:
「把不支持結論的結果也列出來,包括失敗的嘗試。」
這一句話針對的是出現率最高的那一項(78.1%)。它不能保證它會照做,但不問,它多半不會主動說。
結語|它會檢查,只是不會因為檢查而改變
本份研究最有價值的地方,不是告訴我們 AI 不可靠。
而是把「不可靠」的位置進行定位:問題不在它看不出錯,而在它看出錯之後,沒有後續行動,什麼都沒發生。
對於每天使用 AI 協助研究者而言,能提供該把力氣花在哪裡的決策依據。
如果它無法辨識錯誤,我們該做的是換更好的工具。
但既然它看得出來、只是不會因此改變行為,則要換的就不是工具,而是「發現之後必須處理」的機制。
而那個機制,目前只能放在人身上。
AI 可以幫你找出問題。要不要因為那個問題而產生行動與改變結論,是你的工作。
這份研究的限制
任何單一研究都有邊界,本份也不例外。要引用它之前,有四件事該知道。
一、82.5% 的分母是 800 份「分析文件」,不是 800 個研究任務。
本份研究從頭到尾沒有報告任何任務成功率,所測量的為「失敗樣態出現的頻率」,非「AI 做研究成功幾成」。
二、每個任務只跑一次,沒有重複執行,也沒有信賴區間。
作者自己於限制一節寫明:這些失敗頻率是「指示性的,而非窮盡的」。
三、作者把該樣態所屬的類別標為低信心。
將 45 種樣態依成因分為四類,而 82.5% 這項所屬的「認知深度」類,作者在附錄明說:需要判斷 agent 推理過程的樣態,比有具體產物可查的樣態更難以裁定,因此全文將這類的比率視為低信心。
四、作者明說有一件事沒測。
研究摘要裡寫著:在流程或編排層加入外部檢查機制能否補上這個缺口,是一個本研究未測試的開放問題。所以這份研究不能被引用成「加審查機制無用」。
上述限制不會推翻它的核心觀察。「找到問題卻照樣交付」現象確實被大量觀測到,而且八套系統都有,包括其中最強的模型。
參考文獻
- Fei, Yanlin, Nazhou Liu, Xinmiao Yu, Shaolong Chen, Lei Li, Rahul Thapa, Madalina Ciobanu, Qingqing Mao, and Ritankar Das. “How Do Agents Fail on AutoResearch: End-to-End Diagnostic Evaluation on 100 Real-World Frontier Research Tasks.” arXiv, 2608.14905v1, 14 Aug. 2026. https://arxiv.org/abs/2608.14905
AI 使用聲明
本文由匯東華統計顧問有限公司 陳秀敏 博士撰稿,Claude Opus 5 協助原文檢索、數據核對與版面排版,最終內容已由作者審閱定稿。文中所有數據均取自上列研究之原文,並經逐項回原文核對。日期:2026 年 9 月 4 日。
同期其他單元
- 統計方法實務|設置虛擬變數的 SPSS 實作與常見錯誤:從建立虛擬變數到解讀係數,Step by Step
- AI 工具實務|ChatGPT 回答總是差一點?8 個短指令,立即修正太難、太長、太亂與太像 AI
- 臨床預測模型系列 No. 01|臨床預測模型研究寫作指引:TRIPOD+AI 介紹
匯東華電子報 第 4 期|2026.09.04|看本期網頁版 →
聯絡我們
- LINE:@medatatw
- Email:info@medatatw.com
- 電話:07-9721586
- 官網:www.medatatw.com

統計分析
服務價目表 (未含5%營業稅)
透過嚴謹的數據整理,提供有價值的資訊,形塑知識,提高決策品質。包括信達雅三執行原則。
信:確保資料品質可信賴
達:確保統計方法適切性
雅:確保圖文表格正規化
協助代執行統計分析與進一步加值服務。
在匯東華與夥伴的專業背景知識配合下,能有效地處理面對的問題。
統計分析成果

數據串接與清洗
數據是礦藏,數據清洗是挖出鑽石的第一步,尤其是巨量知識。數據清洗或串接執行過程需要細心與專注,且有可能會消耗許多時間和精力,就由我們來替各位處理掉這個大麻煩。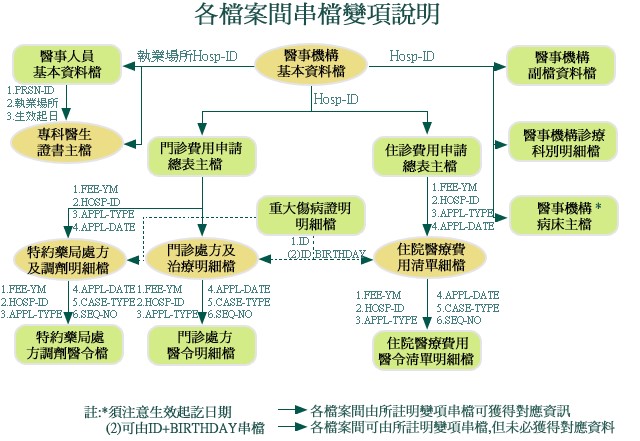
全民健保研究資料庫、國外大型資料庫資料非常齊全,種類多,需要串接與清洗,進行正規化後才能更進一步進行資料探勘與統計分析。
Fig1.同一個Project資料散落在不同tables,無法使用
Fig2.整併與清理為可分析的table
Fig.3整理和分析後形成有意義的知識
概念與流程示意圖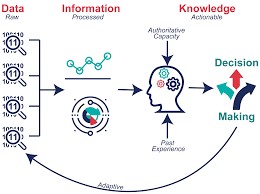

計畫撰寫與統計諮詢
為了讓匯東華的顧客與學員有更好的合作和消費體驗,故匯東華特別依據營業項目開發周邊產品,提供使用、購買。目前已有針對公共衛生師的題庫以及模擬試題,未來將針對醫學研究領域發展產品。
訂閱匯東華電子報
統計不是終點,決策才是。
研究方法、統計實務技巧與數據決策思維,每期送到你的信箱。
我們僅將你的 Email 用於寄送匯東華電子報,你可隨時一鍵退訂。
已送出,請至信箱查收確認信
(若 5 分鐘內未收到,請檢查垃圾郵件匣,或回到本頁再送出一次。)
優惠倒數 天
限時優惠.8/31 截止
同期推薦(非本次限時優惠)
優惠價至 2026/8/31 止,實際金額以課程平台結帳頁為準。