 匯東華統計顧問有限公司
一頁先懂|核心判斷
一個變項單獨看很顯著,和其他變項一起放進模型就不顯著,這很常見,但原因不只一種。先看兩個數字:係數本身改變多少,標準誤放大多少。
- 係數本身往 0 移動,標準誤沒怎麼變:多半是校正其他變項之後,原本的關聯被解釋掉(干擾屬於這一類)。這通常是校正發揮作用,不是問題。
- 係數大致還在、甚至亂跳,標準誤被撐大好幾倍:這才是共線性。幾個變項高度重疊,模型分不清各自的貢獻。
三件最容易做錯的事:
- 只看相關矩陣。 本例三個變項兩兩相關都低於 .7,三個合起來卻幾乎完全重疊,要看 VIF 才看得出來。
- 看到 VIF 超過 10 就刪變項。 門檻是經驗值,刪哪一個要由研究問題決定,不由 p 值決定。
- 把「不顯著」讀成「沒有關係」。 共線性下,幾個變項合起來的解釋力往往還在,只是分不開。
01|「不顯著了」有兩種,先分清楚是哪一種
p 值是係數除以標準誤再查表得來的。所以一個變項從顯著變成不顯著,只有兩條路:分子變小,或分母變大(也可能兩者都有)。
| 看到的現象 | 最常見的原因 | 該怎麼想 |
|---|---|---|
| 係數往 0 移動,標準誤差不多 | 校正其他變項後,原本的關聯被解釋掉 | 先問:這個校正合不合理? |
| 係數還在或亂跳,標準誤變大好幾倍 | 共線性:幾個變項在講同一件事 | 先問:我真正想知道的是哪一個? |
(表格較寬,手機可左右滑動檢視)
干擾、中介、抑制作用三者在統計上的算法相同,都是看「加入第三個變項後,原本的關聯改變多少」;差別在研究概念,而非數字(MacKinnon et al., 2000)。所以「單變項顯著、多變項不顯著」本身不構成診斷,只提醒你回頭檢查模型放入哪些變項、為什麼放。
下面使用同一份資料,把兩種情況各做一次。
02|沿用第 4 期的資料,另外新增四個欄位
資料為第 4 期示範虛擬變數時用的那份模擬資料:200 位護理人員,原有服務單位、性別、年資、疲勞量表總分四個變項。原有欄位一個數字都沒動,我們以固定亂數種子另外新增四欄:
| 新增欄位 | 怎麼產生 | 對疲勞有沒有效果 |
|---|---|---|
| 本單位年資 | 約六成的人等於總年資;四成曾換過單位,取總年資的 50% 到 100% | 沒有(只由年資推算) |
| 開始執業年齡 | 21 歲起,年資越長的人起始年齡越年輕 | 沒有 |
| 年齡 | 開始執業年齡加年資,取整數歲 | 沒有 |
| 夜班比例(%) | 只依服務單位決定:內外科約 25%,急診約 45%,加護約 50%,再加隨機變動 | 沒有 |
(表格較寬,手機可左右滑動檢視)
本份模擬資料最大的好處是:我們知道答案。 疲勞分數產生時,只放入服務單位、性別、年資三個變項,年資的真實效果設定為每多一年,疲勞分數低 0.40 分。新加的四欄,在已知年資與服務單位的情況下,對疲勞完全沒有額外影響。
先確認起點。只放年資的單變項迴歸,年資每多一年,疲勞分數低 0.458 分(95% 信賴區間 −0.772 到 −0.145,p = .004);第 4 期的多變項模型(服務單位、性別、年資)是低 0.443 分(−0.737 到 −0.149,p = .003),VIF 1.01。兩個模型都很接近真實值。
03|放進本單位年資:年資的正負號翻轉
把本單位年資加進第 4 期的模型。它和年資的相關是 .962。
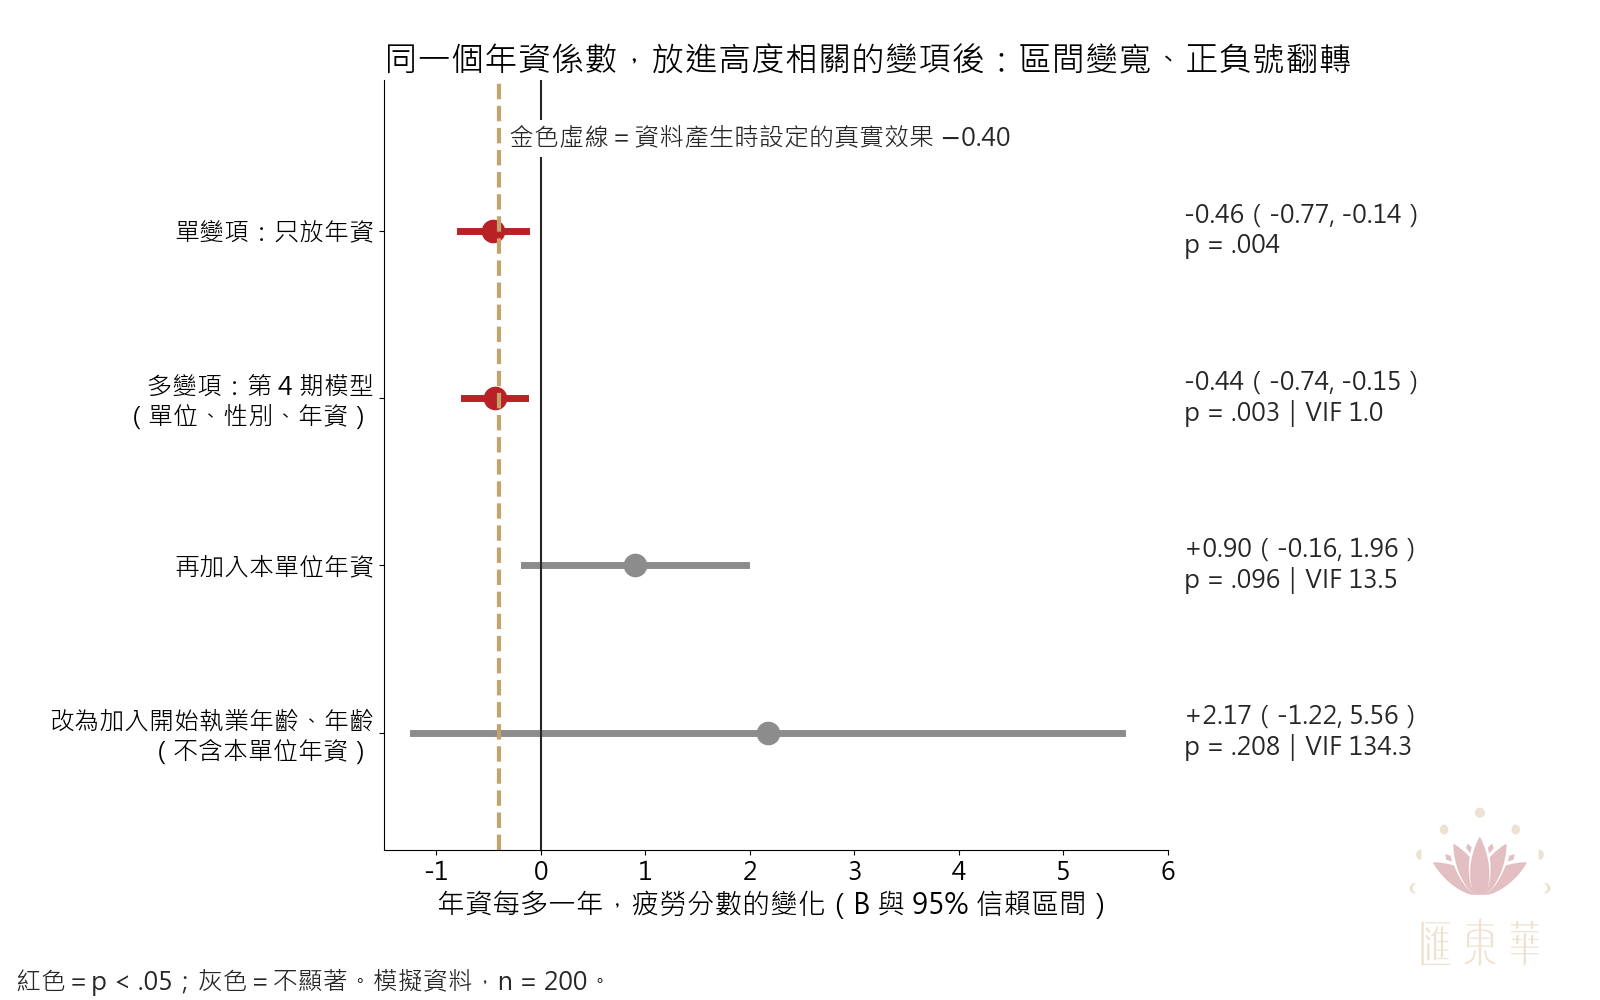
圖1、年資係數在四個模型中的變化。單變項 −0.46(−0.77, −0.14),p = .004;第 4 期模型 −0.44(−0.74, −0.15),p = .003,VIF 1.0;再加入本單位年資 +0.90(−0.16, 1.96),p = .096,VIF 13.5;改為加入開始執業年齡與年齡(不含本單位年資)+2.17(−1.22, 5.56),p = .208,VIF 134.3。金色虛線標示資料產生時設定的真實效果 −0.40。
(點擊圖片可開啟原圖放大檢視)
| 年資那一行 | B | 標準誤 | p | VIF |
|---|---|---|---|---|
| 第 4 期模型 | −0.443 | 0.149 | .003 | 1.01 |
| 加入本單位年資 | +0.901 | 0.538 | .096 | 13.5 |
(表格較寬,手機可左右滑動檢視)
三件事一起發生:
標準誤從 0.149 變成 0.538,大約 3.6 倍。 VIF 的意思正是這個:在其他條件相同下,VIF 為 10 代表這個係數的變異數是「它和其他自變項不相關時」的 10 倍(O'Brien, 2007)。年資的 VIF 從 1.010 升到 13.535,標準誤預期放大約 √(13.535/1.010) ≈ 3.66 倍;實際是 3.61 倍,與預期接近(差距來自殘差變異也跟著改變)。
係數從 −0.443 變成 +0.901。 年資越久、越不疲勞,突然變成年資越久、越疲勞。
本單位年資那一行是 −1.530,p = .010。 而依照資料的產生方式,本單位年資在已知總年資時對疲勞沒有任何效果。它拿到顯著,是因為兩個幾乎一樣的變項在分同一份效果,這一次剛好分到它身上。
「剛好」有多剛好?我們用固定種子把這 200 人重抽 1,000 次,每次重新估計:
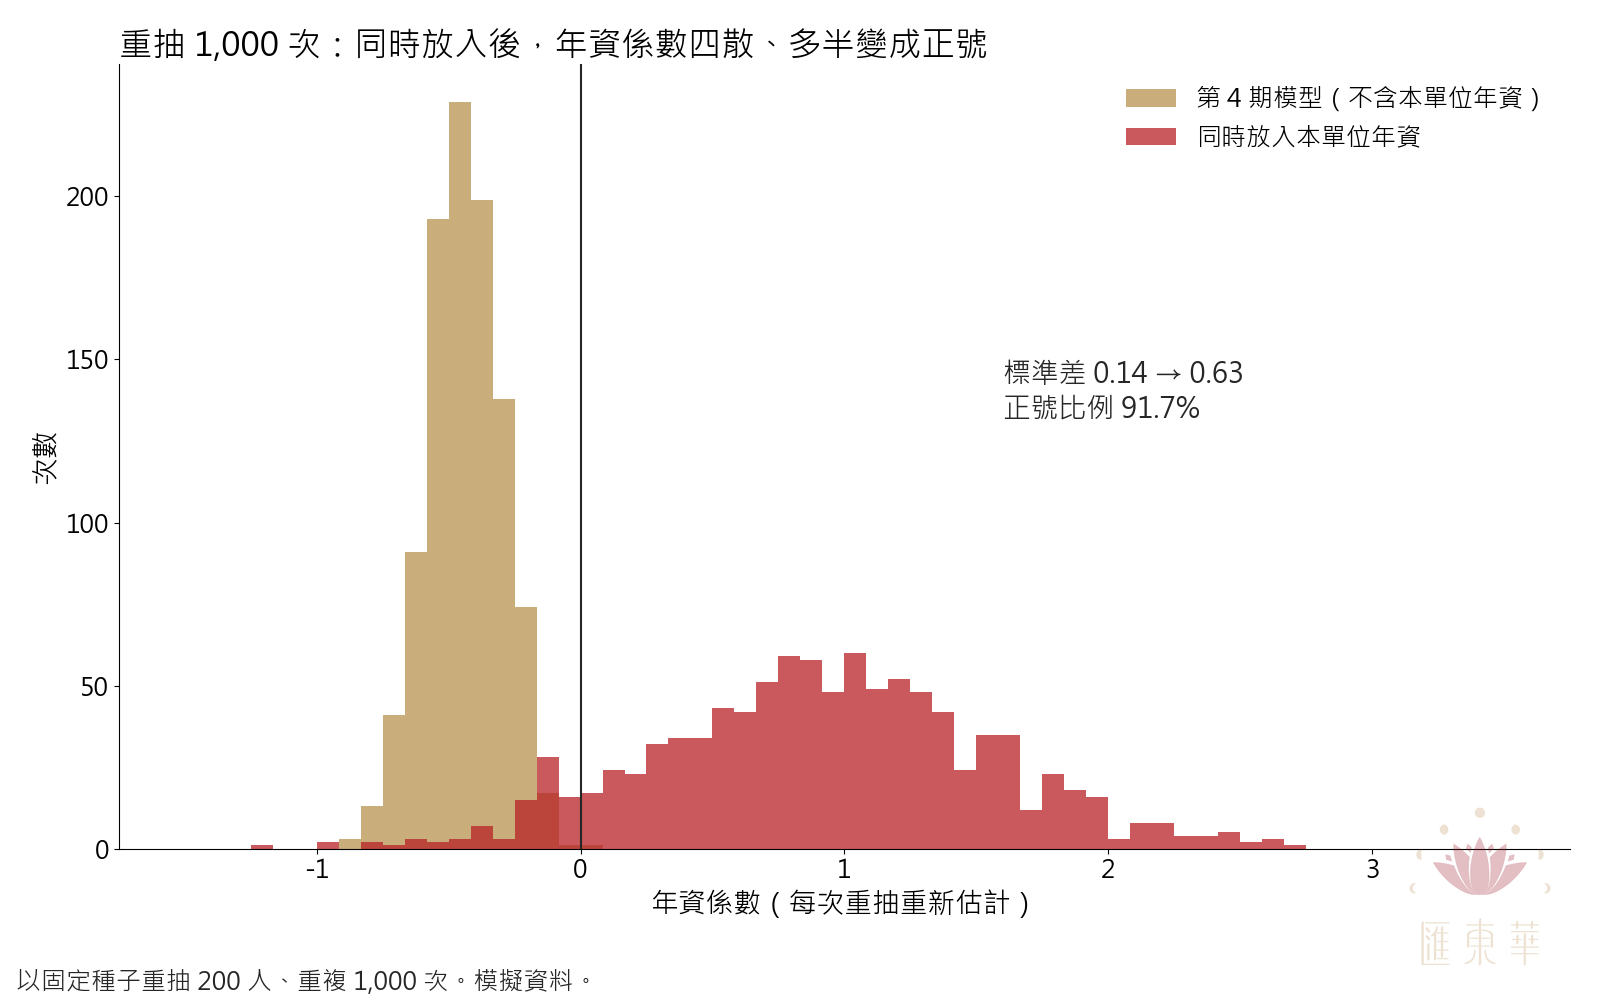
圖2、重抽 1,000 次的年資係數分布。第 4 期模型(金色)集中在 −0.4 附近,標準差 0.14;同時放入本單位年資(紅色)後,分布散開到 −1 到 3 之間,標準差 0.63,91.7% 的重抽結果為正號。
(點擊圖片可開啟原圖放大檢視)
只放年資時,1,000 次幾乎全落在負值(正號僅 0.1%),標準差 0.14。和本單位年資一起放,標準差變成 0.63,而且 91.7% 是正號。係數不穩定的意思是:換一批人,就換一個答案。文獻的模擬研究也看到同樣的現象:預測變項間的相關升高時,係數與標準誤的變化都變大,甚至出現正負號翻轉(Vatcheva et al., 2016)。
因此不能看哪一個顯著就留哪一個。照 p 值挑選,會留下本單位年資、丟掉真正有效果的總年資,而報表上每個數字看起來都正常。
04|相關矩陣看不出來,VIF 看得出來
第二個例子比較隱蔽。把開始執業年齡和年齡兩欄,一起加進第 4 期的模型。
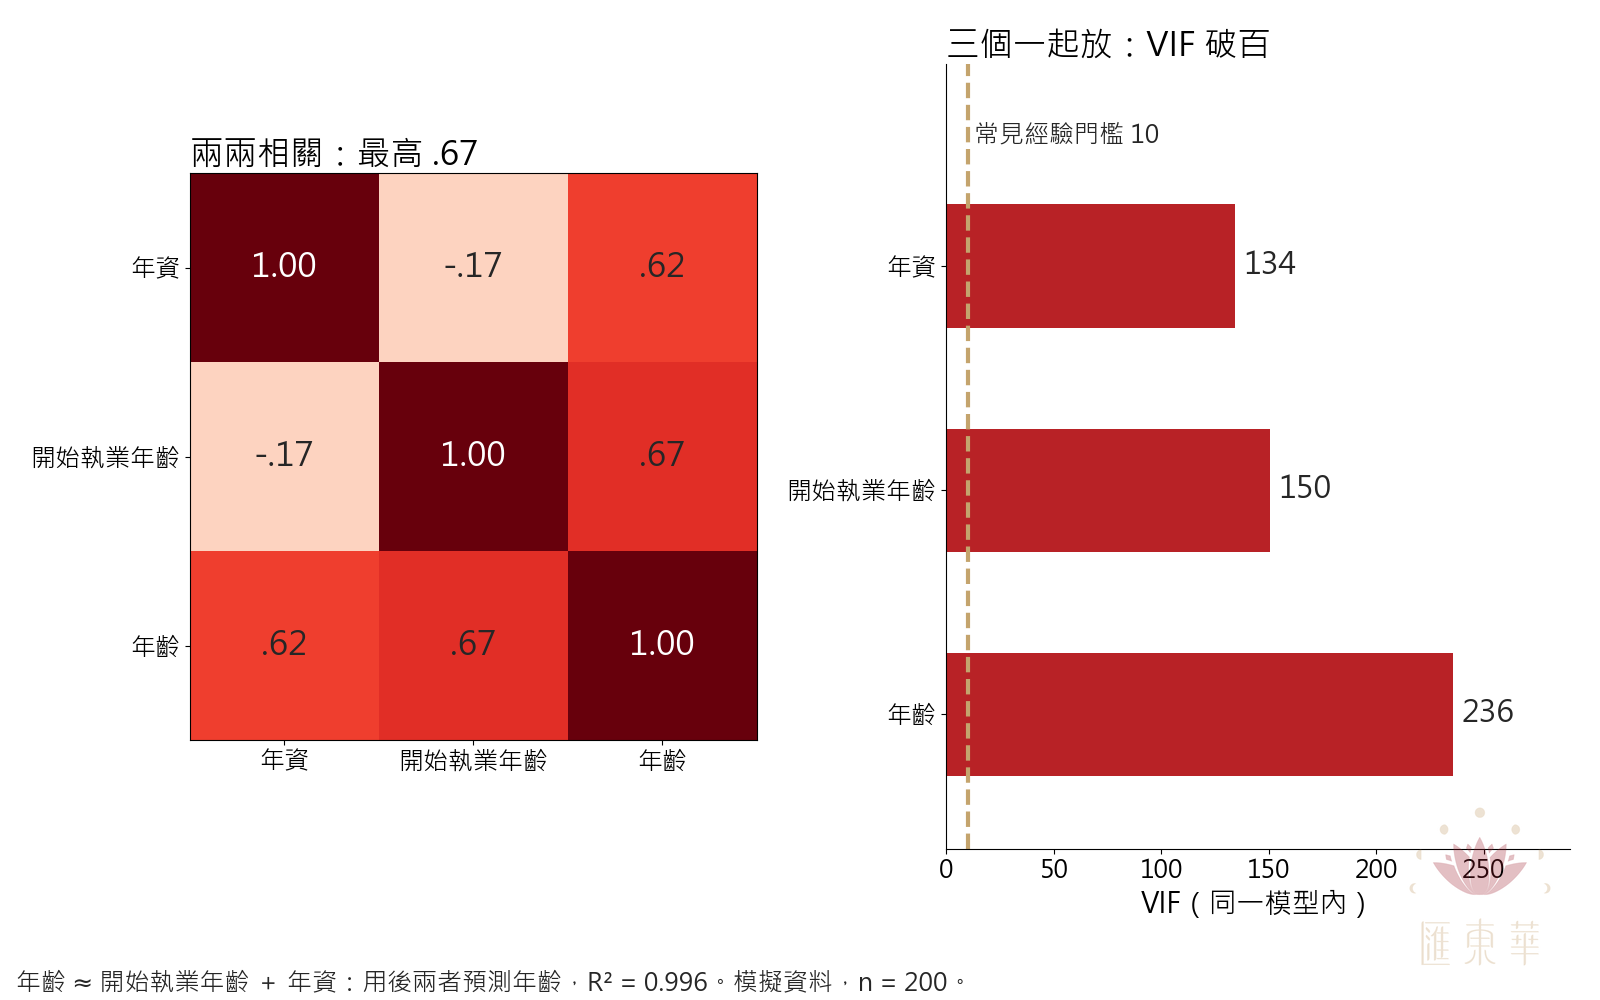
圖3、左:年資、開始執業年齡、年齡三者的相關矩陣,兩兩相關分別為 −.17、.62、.67,最高 .67。右:同一模型內三者的 VIF,年資 134、開始執業年齡 150、年齡 236,均遠高於常見經驗門檻 10。圖下註:用開始執業年齡與年資預測年齡,R² = 0.996。
(點擊圖片可開啟原圖放大檢視)
三個變項兩兩之間的相關,最高只有 .67,年資和開始執業年齡甚至是 −.17。單看相關矩陣,不會覺得有什麼問題。
但同一個模型裡,三者的 VIF 是 134、150、236。原因很單純:年齡 ≈ 開始執業年齡 + 年資。用另外兩個變項去預測年齡,R² 是 0.996。每一對都只有部分重疊,三個合起來卻幾乎完全重疊。
相關矩陣的盲點在此:共線性可能存在於三個以上的變項之間,即使沒有任何一對的相關特別高;這種情況要靠 VIF 來識別(James et al., 2013)。
結果同上一節,只是更極端:年資的標準誤從 0.149 撐到 1.717,係數變成 +2.169(p = .208),三個變項沒有一個顯著。
要知道是哪幾個變項綁在一起,可以看 SPSS 共線性診斷表(第 4 期第 07 節介紹過)。本模型最後一個維度的條件指數是 248.9,在那一列,年資、開始執業年齡、年齡的變異數比例分別是 .99、1.00、1.00,三個一起亮燈,其他變項都接近 0。VIF 告訴你誰被影響,條件指數加變異數比例告訴你誰跟誰綁在一起。
05|夜班比例:這次不顯著,跟共線性無關
第三個例子,看起來一樣是「單變項顯著、多變項不顯著」,原因卻完全不同。
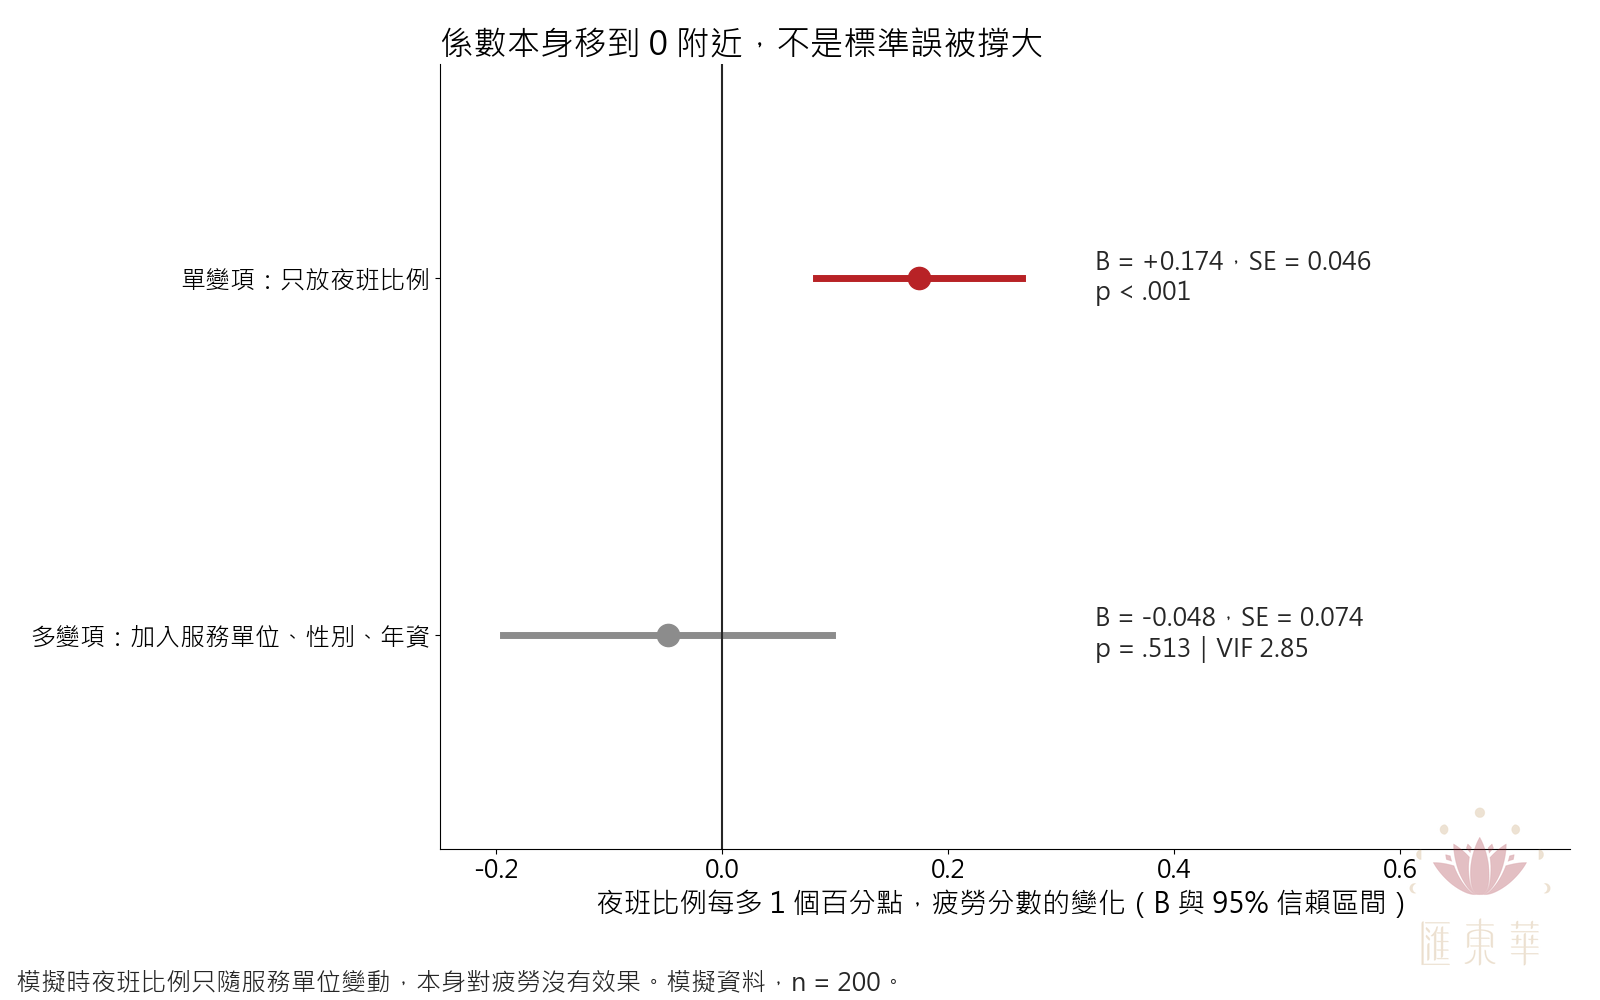
圖4、夜班比例的係數。單變項 B = +0.174,SE = 0.046,p < .001;加入服務單位、性別、年資後 B = −0.048,SE = 0.074,p = .513,VIF 2.85。
(點擊圖片可開啟原圖放大檢視)
| 夜班比例那一行 | B | 標準誤 | p | VIF |
|---|---|---|---|---|
| 單變項 | +0.174 | 0.046 | <.001 | |
| 加入服務單位、性別、年資 | −0.048 | 0.074 | .513 | 2.85 |
(表格較寬,手機可左右滑動檢視)
這次標準誤只從 0.046 變成 0.074,VIF 2.85,離任何常見門檻都很遠。真正的變化是係數本身從 +0.174 掉到 −0.048。簡單算一下:即使標準誤完全沒變大,−0.048 除以原本的 0.046,t 值也只有 −1.05 左右,同樣不顯著。
原因在資料的設計:夜班比例只依服務單位決定,本身對疲勞沒有影響。急診和加護的人,夜班比例較高,疲勞分數也較高。單變項模型沒有服務單位,服務單位造成的疲勞差異就反映在夜班比例的係數上;模型加入服務單位後,這部分差異由服務單位解釋,夜班比例的係數就接近 0。這是干擾,不是共線性:服務單位同時影響夜班比例與疲勞。這時候服務單位應該留在模型裡。在這份資料裡,夜班比例本來就沒有效果,變得不顯著是正確的結果,不需要另外「處理」。
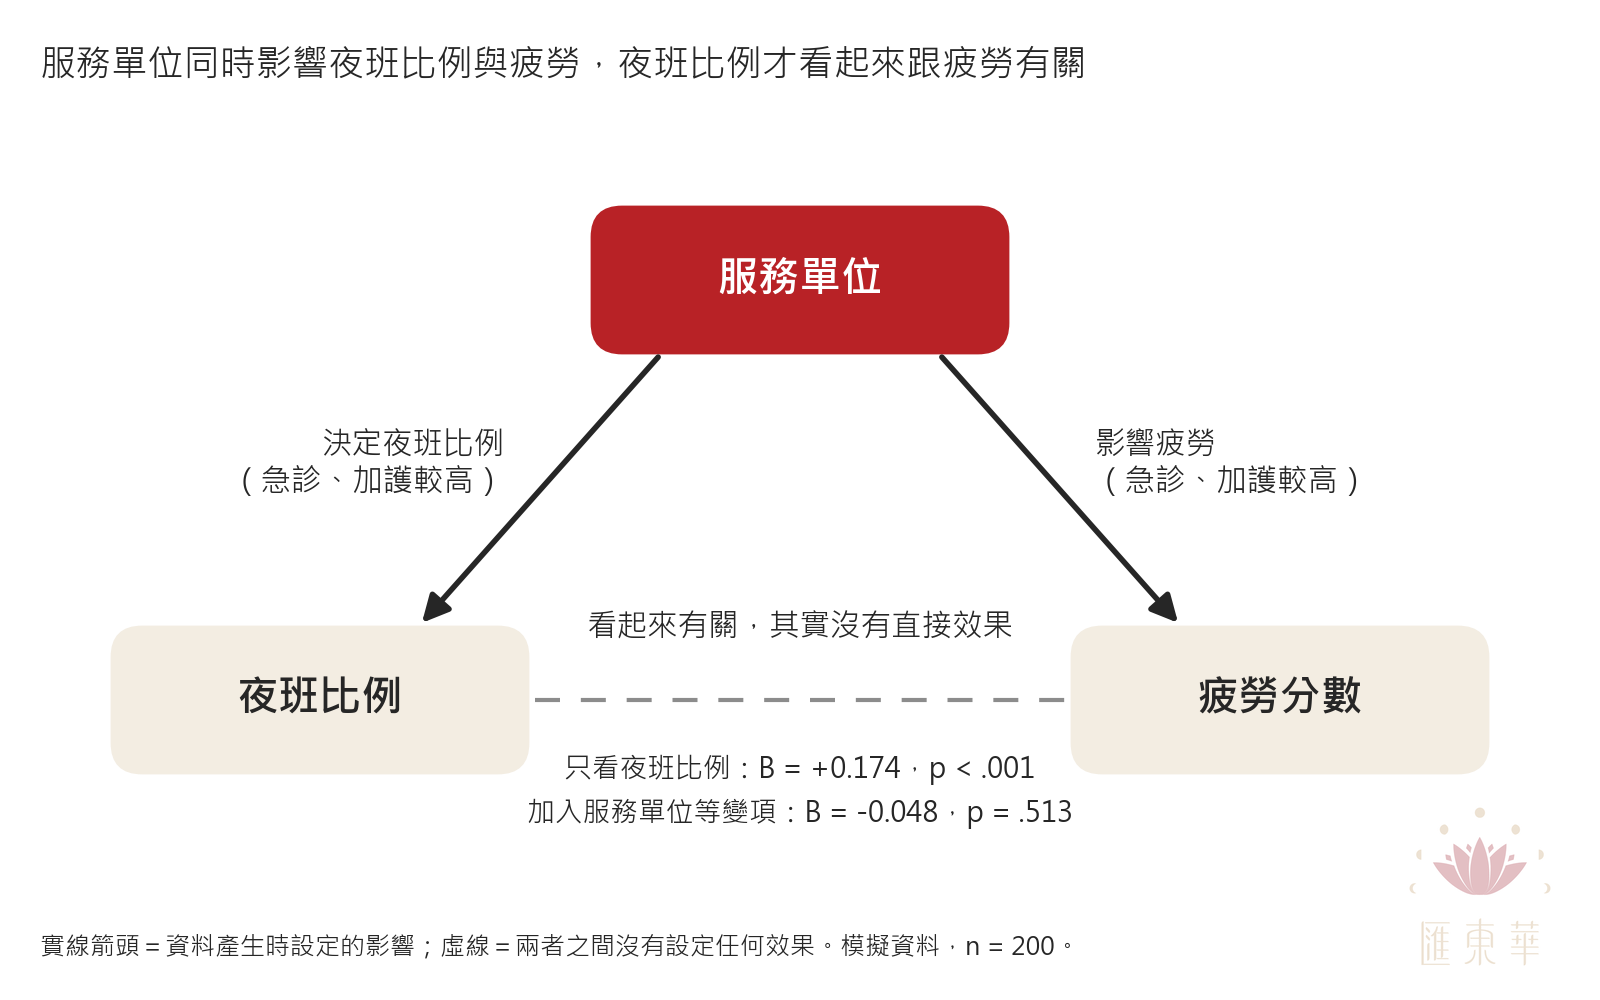
圖5、服務單位同時影響夜班比例與疲勞,夜班比例才看起來跟疲勞有關。實線箭頭為資料產生時設定的影響,兩者之間沒有設定任何效果。
(點擊圖片可開啟原圖放大檢視)
要不要校正某個變項,取決於它在因果結構中的角色(干擾、中介或碰撞),而不是它跟暴露的相關有多高;模型設定正確時,即使變項間高度相關,效果估計也不會因此偏誤,代價是精確度下降(Schisterman et al., 2017)。
再補一個常被忽略的原因:多變項模型的樣本數可能比單變項少。只要任何一個變項有遺漏值,許多統計軟體預設會把那個人整筆排除(Schafer & Graham, 2002)。單變項用 200 人、多變項只剩 150 人,p 值自然會變。比較兩個模型前,先確認 n 一樣。(本文資料沒有遺漏值,兩邊都是 200 人。)
06|三個變項各自不顯著,合在一起卻顯著
04 節的三個變項,p 值分別是 .208、.122、.130,沒有一個低於 .05。換個問法:把它們當成一組,跟只有服務單位、性別的模型比,整組加進去有沒有改善?03 節的兩個年資變項也照樣比一次:
| 比較 | 一起加入的變項 | F | p |
|---|---|---|---|
| 03 節模型 vs 只有單位、性別 | 年資、本單位年資 | 7.91 | <.001 |
| 04 節模型 vs 只有單位、性別 | 年資、開始執業年齡、年齡 | 3.79 | .011 |
(表格較寬,手機可左右滑動檢視)
兩組都顯著。逐一看每個變項,答案是「都不顯著」;整組看,答案是「有關係」。兩個答案並不矛盾:重疊的變項合起來確實帶著年資的資訊,模型只是沒辦法把這份資訊拆給其中某一個。資訊沒有不見,只是分不開。
拆不開的時候該留誰?03 節已經示範過照 p 值挑的結果:本單位年資(p = .010)會被留下,真正有效果的總年資(p = .096)會被丟掉;而重抽 1,000 次裡,總年資有 91.7% 被估成正號,拿這個係數下結論,方向是反的。
所以變項的去留要先回到背景知識。Heinze 等人(2018)的回顧建議,建模前先依背景知識設定每個變項的角色,已知的干擾因子應該納入校正;他們也指出,沒有一個放諸四海皆準的顯著性門檻可以拿來挑變項。
07|兩把尺,對同一個模型給出不同答案
本文兩個共線性的例子,各算兩種診斷:
| 模型 | 年資的 VIF | 最大條件指數 |
|---|---|---|
| 03 節(加入本單位年資) | 13.5 | 17.8 |
| 04 節(加入開始執業年齡、年齡) | 134.3 | 248.9 |
(表格較寬,手機可左右滑動檢視)
常被拿來對照的經驗門檻,VIF 是 5 或 10(James et al., 2013),條件指數是 30,後者多半轉述自 Belsley 等人(1980)的迴歸診斷專書。拿這兩個門檻去量:04 節兩把尺都遠遠超過;03 節卻是 VIF 說超過、條件指數說沒到。SPSS 報表上的容忍度只是把 VIF 倒過來寫,資訊相同,不會提供第三種意見。
兩把尺意見不同,不代表其中一把有誤。VIF 看的是單一係數的變異數被放大多少,條件指數看的是整組自變項離「解不開」有多近,量的東西本來就不同,門檻又都是經驗值。
那超過門檻,是不是就該處理?O'Brien(2007)專文檢討這些經驗法則,結論是 VIF 即使達到 10、20、40 甚至更高,本身都不足以否定迴歸結果,也不代表必須刪變項、改用脊迴歸或合成指標,這些做法帶來的問題可能比它們解決的更嚴重;樣本數等其他因素對係數變異數的影響,也可能遠大於 VIF 造成的膨脹。
許多文章把「VIF 10」歸給 Marquardt(1970)。我們回頭讀原文:文中確實出現 10,但說的是「用脊迴歸或廣義反矩陣時,該容許多少偏誤」的選擇準則,不是判斷要不要刪變項的門檻。
08|先說清楚:這個模型要拿來做什麼
同樣三個模型,換個角度看:年資係數從 −0.44 跳到 +0.90 再跳到 +2.17,但三個模型的 R² 是 .182、.210、.193;第 4 期模型的預測值,和另外兩個模型預測值的相關分別是 .93 與 .97。係數大搬家,預測值的變化小得多。
這個對照決定是否需要處理共線性。
若模型是拿來預測新個案的疲勞分數,重點就是預測準不準,係數怎麼分配是次要的。只要新個案裡,這幾個變項彼此的關係和建模資料差不多,係數分配不同,預測結果也差不多。風險出在新資料的情況不一樣,例如拿某家醫院的資料建模,套到另一家醫院或另一個年代的護理人員身上(Dormann et al., 2013)。以本文資料為例:建模的醫院裡,多數人沒換過單位,總年資和本單位年資幾乎一起變動;若新醫院的人常常換單位,這兩個年資不再一起變動,模型把效果分配給哪一個年資,就會直接影響預測值。
若模型是拿來回答「年資每多一年,疲勞改變多少」,係數本身就是答案,不能放著不管。以本文資料來說:
- 兩個都必須留(例如都是已知的干擾因子),就照實報告它們的係數不精確,並附上 06 節那種整組檢定。
- 問題問的是哪一種年資,就放哪一種。 想知道的是護理總年資,就放總年資;想知道的是在現職單位待多久,就放本單位年資。兩個都放,模型只能告訴你「兩者加起來有關」。
- 重疊的變項若有臨床上能合理解釋的組合,可以合成一個指標;合成之後回答的是另一個問題,要在文中講清楚。
至於脊迴歸、LASSO 這類懲罰方法:03 節的重抽顯示,年資係數的標準差從 0.14 撐大到 0.63,懲罰方法要壓低的,正是這種不穩。其做法是刻意讓係數有偏誤,換取較小的均方誤差(Hoerl & Kennard, 1970; Heinze et al., 2018)。代價是係數被往 0 拉,不再是原本的「每多一年改變多少」;Heinze 等人也提醒,LASSO 適合預測,不適合用來解釋係數。
結語|先確認它是怎麼消失的,再決定要不要處理
先確認   兩個模型的 n 一樣嗎?
再比較   係數改變多少?標準誤改變多少?
係數變動  回頭看校正的是什麼、合不合理(干擾、中介)
SE 變大   看 VIF;不只看相關矩陣
找夥伴   看條件指數那一列,是哪幾個變項一起亮燈
做決定   依研究問題選變項,不依 p 值
本文的例子裡,年資是確實有效果的變項,卻在兩個多變項模型裡變得不顯著;開始執業年齡、年齡、夜班比例本來就沒有效果,在多變項模型裡也不顯著;本單位年資則是反例,同樣沒有效果,p 卻為 .010。單看 p 值,分不出哪個變項真的有效果;要看係數和標準誤怎麼變,判斷是共線性還是干擾,才分得出來。
關於本文的示範資料
資料來源:本文使用的是模擬資料,不是真實病人資料。 沿用第 4 期的 200 筆護理人員工作負荷資料,原有的服務單位、性別、年資、疲勞量表總分四欄未改動任何數值;本單位年資、開始執業年齡、年齡、夜班比例四欄為本期以固定亂數種子新增,產生方式如 02 節所述。
文中所有數字,均由 R 與 Python 兩套程式各自獨立產生資料、各自計算後逐格比對,差異皆小於萬分之一。
AI 使用聲明
本文由匯東華統計顧問有限公司 陳秀敏 博士撰稿,Claude Opus 5.5 協助資料模擬、分析執行、文獻查證與初稿撰寫,最終內容已由作者審閱定稿。文中所有數字均為示範資料在 R 與 Python 實際跑出的輸出,並經逐格比對。日期:2026 年 10 月 16 日。
參考文獻
- Belsley, D. A., Kuh, E., & Welsch, R. E. (1980). Regression diagnostics: Identifying influential data and sources of collinearity. Wiley. https://doi.org/10.1002/0471725153
- Dormann, C. F., Elith, J., Bacher, S., et al. (2013). Collinearity: A review of methods to deal with it and a simulation study evaluating their performance. Ecography, 36(1), 27–46. https://doi.org/10.1111/j.1600-0587.2012.07348.x
- Heinze, G., Wallisch, C., & Dunkler, D. (2018). Variable selection – A review and recommendations for the practicing statistician. Biometrical Journal, 60(3), 431–449. https://doi.org/10.1002/bimj.201700067
- Hoerl, A. E., & Kennard, R. W. (1970). Ridge regression: Biased estimation for nonorthogonal problems. Technometrics, 12(1), 55–67. https://doi.org/10.1080/00401706.1970.10488634
- James, G., Witten, D., Hastie, T., & Tibshirani, R. (2013). An introduction to statistical learning: With applications in R. Springer. https://doi.org/10.1007/978-1-4614-7138-7
- MacKinnon, D. P., Krull, J. L., & Lockwood, C. M. (2000). Equivalence of the mediation, confounding and suppression effect. Prevention Science, 1(4), 173–181. https://doi.org/10.1023/A:1026595011371
- Marquardt, D. W. (1970). Generalized inverses, ridge regression, biased linear estimation, and nonlinear estimation. Technometrics, 12(3), 591–612. https://doi.org/10.1080/00401706.1970.10488699
- O'Brien, R. M. (2007). A caution regarding rules of thumb for variance inflation factors. Quality & Quantity, 41(5), 673–690. https://doi.org/10.1007/s11135-006-9018-6
- Schafer, J. L., & Graham, J. W. (2002). Missing data: Our view of the state of the art. Psychological Methods, 7(2), 147–177. https://doi.org/10.1037/1082-989X.7.2.147
- Schisterman, E. F., Perkins, N. J., Mumford, S. L., Ahrens, K. A., & Mitchell, E. M. (2017). Collinearity and causal diagrams: A lesson on the importance of model specification. Epidemiology, 28(1), 47–53. https://doi.org/10.1097/EDE.0000000000000554
- Vatcheva, K. P., Lee, M., McCormick, J. B., & Rahbar, M. H. (2016). Multicollinearity in regression analyses conducted in epidemiologic studies. Epidemiology: Open Access, 6(2), 227. https://doi.org/10.4172/2161-1165.1000227
同期其他單元
- 本期工具|文獻檢索工具|Google 學術搜尋「實驗室」:用一句研究問題,快速找到真實又相關的文獻
- 研究誠信與 AI 治理系列 No. 06|AI 生成內容(AIGC)偵測報告,能不能當作弊證據?
匯東華電子報 第 7 期|2026.10.16|看本期網頁版 →
聯絡我們
- LINE:@medatatw
- Email:info@medatatw.com
- 電話:07-9721586
- 官網:www.medatatw.com

統計分析
服務價目表 (未含5%營業稅)
透過嚴謹的數據整理,提供有價值的資訊,形塑知識,提高決策品質。包括信達雅三執行原則。
信:確保資料品質可信賴
達:確保統計方法適切性
雅:確保圖文表格正規化
協助代執行統計分析與進一步加值服務。
在匯東華與夥伴的專業背景知識配合下,能有效地處理面對的問題。
統計分析成果

數據串接與清洗
數據是礦藏,數據清洗是挖出鑽石的第一步,尤其是巨量知識。數據清洗或串接執行過程需要細心與專注,且有可能會消耗許多時間和精力,就由我們來替各位處理掉這個大麻煩。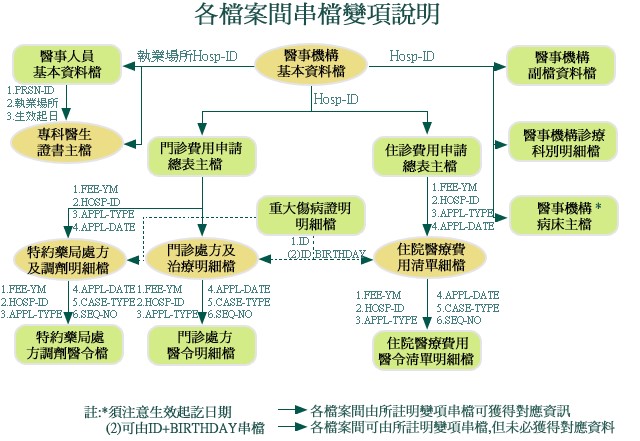
全民健保研究資料庫、國外大型資料庫資料非常齊全,種類多,需要串接與清洗,進行正規化後才能更進一步進行資料探勘與統計分析。
Fig1.同一個Project資料散落在不同tables,無法使用
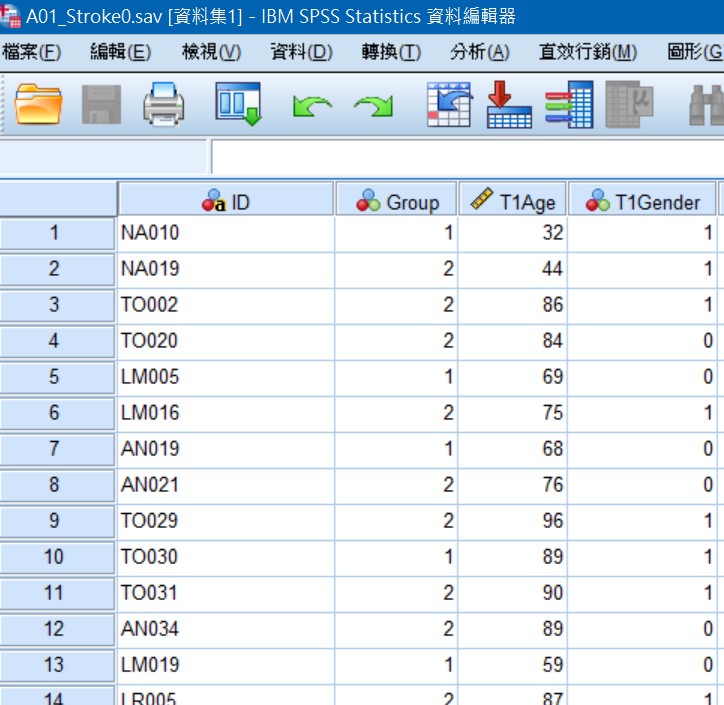
Fig2.整併與清理為可分析的table
Fig.3整理和分析後形成有意義的知識
概念與流程示意圖

計畫撰寫與統計諮詢
為了讓匯東華的顧客與學員有更好的合作和消費體驗,故匯東華特別依據營業項目開發周邊產品,提供使用、購買。目前已有針對公共衛生師的題庫以及模擬試題,未來將針對醫學研究領域發展產品。