 匯東華統計顧問有限公司
一頁先懂|核心判斷
偵測報告上的「AI 率」,可以當成提醒,不能當成證據。
Sun、Liao 與 Ma 於 2026 年在 Computers & Education 發表的研究,建立三個以真實樣本構成的資料集(課堂作業、學位論文、工程程式碼),合計超過 28 萬筆樣本,系統性評估 13 種主流偵測工具,涵蓋商業與開源模型。
摘要的結論有三點:偵測工具在長篇論文上表現尚可,在工程程式碼與短篇作業上則系統性失靈;理工領域因技術寫作的公式化特性,受到明顯的演算法偏誤;作者所稱的混合修改策略,最多可讓 88% 的 AI 生成內容逃過偵測。作者據此判斷:現有偵測技術不足以支撐高風險的教育評量。
第 2 期介紹 Academic Humanizer 時,我們提醒過「不要把能不能通過 AI 偵測當作品質判準」;這項研究為那句提醒補上證據。
文末整理三種讀者(投稿的研究者、指導學生的教師、需要判讀報告的審查者)拿到偵測報告時,可以怎麼做。
01|從第 2 期的改寫工具,到這一期的偵測工具
第 2 期的本期工具〈Academic Humanizer:把 AI 初稿修回自己的聲音,然後呢?〉談的是改寫端:一套把 AI 初稿修回作者語氣的規則。開發團隊在說明中寫明它「not designed to evade AI-use detection」,《Nature》的報導仍以「可抹除 AI 寫作痕跡」為題,引發科學家的擔憂。我們當時在第三個實務提醒寫下:完全由作者自行撰寫的文章,也可能被判定具有 AI 特徵;今天通過某一套偵測器,不能證明文章比較真實。《Nature》相關報導見參考文獻 2。
那是一個原則性的提醒。本期這項研究從偵測端回答同一件事:偵測工具在真實的學生作品上準不準、被改寫之後還剩多少偵測力。
兩篇合起來看,結論是對稱的:偵測分數高,不能證明用過 AI;偵測分數低,也不能證明沒用過。
本篇也延續系列前幾篇的主線。No.03 談 AI 自我檢查後,照樣交出有問題的結論;No.05 的結語是「每一種 AI 用法,都要說得出:出錯時誰會發現、誰負責」。偵測工具是同一個問題的另一面:當我們拿一個 AI 工具去判斷別人有沒有用 AI,判斷的責任仍然在人身上,不在報告上。
02|這項研究怎麼測:把偵測工具放回真實的學生作品
作者指出,偵測工具在真實教育情境中的有效性,至今探討不足。因此他們建立三個資料集:
- StuTask:課堂作業
- StuThesis:學位論文
- DataCode:工程程式碼
三者合計超過 28 萬筆真實樣本。作者以 13 種主流偵測工具(含商業與開源模型)從多個面向評估,包括整體表現、任務複雜度、學科差異,以及面對刻意修改時的穩健性。
03|長篇論文尚可,短作業與程式碼系統性失靈
摘要的第一個發現是:偵測工具在長篇學位論文上的表現「尚可接受」(acceptable),但在工程程式碼與短篇課堂作業上「系統性失靈」(systematic failures)。
要注意的是「尚可」兩個字。作者在研究重點中另外寫明:尚可的偵測表現,仍不足以用於高風險評量。 即使在表現最好的長篇論文,結果也只到「可以參考」,達不到「可以定案」。
對醫護研究的讀者,這裡有一點延伸:統計分析常附 R 或 SPSS 語法。這項研究測的是工程程式碼,沒有直接測統計語法;但同屬程式碼,不宜預設通用偵測器在這裡會比較準(此為推論,本研究未直接檢驗)。
04|理工寫作的公式化特性,帶來演算法偏誤
第二個發現與學科有關。作者指出,由於技術寫作的公式化特性,理工(STEM)領域受到明顯的演算法偏誤。
醫學與護理研究的寫作同樣高度格式化:方法節的固定句式、結果節的數值報告、被動語態與專業術語。本研究沒有把醫學寫作單獨分析,但依作者對理工寫作的解釋,醫護研究者的稿件很可能落在同一側(此為推論,未經本研究直接檢驗)。
摘要沒有說明偏誤的方向(較常被誤判為 AI,或較常被漏判)。
這一點對指導者最重要:同一個偵測分數,放在不同學科、不同文體,意義不一樣。 用同一條門檻判斷所有學生,本身就可能不公平。
05|經混合修改,最多 88% 的 AI 內容逃過偵測
第三個發現是穩健性測試。作者指出,現有偵測工具極度脆弱:作者所稱的混合修改策略,最多可讓 88% 的 AI 生成內容成功逃過偵測。
摘要沒有說明 88% 是哪一種工具的結果、是單一工具還是跨工具的彙總,也沒有列出各工具各自的數字;這些細節都在全文,本文不轉述。可以確定的是:在作者的測試中,經混合修改後逃過偵測的比例最多達 88%。
回到第 2 期的問題:如果經過修改就可能大量通過偵測,那麼「通過偵測」並不能說明什麼;而另一頭,理工寫作又受到演算法偏誤(方向見 04 節)。偵測分數在兩個方向上都不能單獨成立。
06|拿到偵測報告時:投稿、指導、審查三種情境
作者在研究重點(Highlights)中呼籲轉向過程導向評量(process-oriented assessment),並主張偵測工具應在評量體系中擔任參考指標。以下是我們據此延伸的做法,針對醫護研究的投稿、論文指導與審查情境整理。
情境一|醫護研究者投稿:被質疑時,拿得出來的是分析軌跡
- 研究論文的核心是數據與分析。資料檔版本、分析語法、輸出報表,以及手稿中每個數字對應到哪一份輸出,這些紀錄能說明結果從何而來;一份文字偵測分數無法說明這件事。
- AI 使用依目標期刊規定揭露。No.01 整理過,ICMJE 要求投稿時揭露 AI 輔助技術,並由人類作者為內容負責;揭露與否看規定,不看偵測分數高低。
- 若編輯轉來偵測疑義,回覆時附上揭露內容與版本紀錄,請編輯依稿件內容與證據判斷,不必就分數本身爭辯。
- 不為壓低分數而改寫。第 2 期電子報提醒過,AI 潤飾前後至少要並排檢查動詞強度、限定語、數值與引用。
情境二|指導研究生論文:分數決定要不要多談,不決定結果
- 學位論文是這項研究中偵測工具表現相對較好的類型,但作者仍判斷不足以支撐高風險評量;而醫護論文的方法與結果段落高度格式化,可能落在理工寫作同一側(推論與偏誤方向見 04 節)。分數偏高時,合理的下一步是約學生談,而不是下結論。
- 談的內容以研究本身為準:這個統計方法為什麼適合這份資料?表 2 的這個數字是從哪一份輸出來的?限制段寫的這一點,依據是什麼?能把自己的分析講清楚,比任何百分比都更能反映是不是學生自己做的。
- 在研究計畫書或 IRB 送審階段,就寫明 AI 會用在哪些步驟,並把使用紀錄和資料分析軌跡放在一起保存;事後有疑問時,就有可以對照的依據。
情境三|期刊或學位審查:把疑慮換成可查證的問題
- 這項研究的判斷範圍是教育評量;期刊與學位審查情境未在研究中檢驗,但同樣是會影響當事人的高風險判斷(此為推論)。
- 偵測分數不寫成審查結論。疑慮應換成可以查證的問題:引用的文獻存在嗎、內容對得上嗎?文中數字與表格一致嗎?方法描述足以重現嗎?
- 給作者說明與提出紀錄的機會;有紀錄,判斷才有對照的基礎。
結語|偵測分數是提醒,判斷要靠過程與證據
AIGC 偵測工具可以提醒我們:這份作品值得多看一眼。但它在短作業與程式碼上系統性失靈、在理工寫作上有演算法偏誤,經混合修改後最多 88% 的 AI 內容逃過偵測。拿它當證據,等於把判斷交給一個連作者都認為不足以承擔高風險決定的工具。
第 2 期說過:AI 可以進入寫作流程,責任不能一起外包。偵測端也是一樣。
偵測分數可以提醒你多看一眼;要如何下結論,得看過程與證據。
這份研究的限制
- 研究對象是學生作品(課堂作業、學位論文、工程程式碼),不是期刊投稿稿件;結果能否直接推論到醫學期刊稿件,本研究沒有檢驗。
- 摘要未說明樣本的語言與學生所在地區;本文未取得全文,無法確認。
- 偵測工具與生成模型都持續更新,評估結果反映的是研究進行當時的版本。
- 本文關於這項研究的內容,只依據論文摘要與研究重點;各工具的個別數字、各學科的偏誤方向與幅度、修改策略的細節,請見全文。06 節的做法為匯東華延伸整理,01 節的系列銜接引自本電子報已刊文章。另外,這篇摘要有兩種版本,一版寫 up to 88%,一版只寫 88%;兩種寫法都不超過「最多 88%」,本文一律以「最多 88%」表述。
參考文獻
- Sun, Yicheng, Yihan Liao, and Xiaoxue Ma. "Trusting AI to Detect AI? A Systematic Evaluation of the Reliability and Robustness of Current AIGC Detection Tools for Student Academic Work." Computers & Education 249 (2026): 105616. https://doi.org/10.1016/j.compedu.2026.105616
- McKie, Anna. "Universities Are Relying on AI-Detection Software to Catch Cheating. How Well Do the Programs Work?" Nature 655, no. 8122 (2026): 535-537. https://doi.org/10.1038/d41586-026-01358-2
系列延伸閱讀
- 第 2 期本期工具|Academic Humanizer:把 AI 初稿修回自己的聲音,然後呢? https://www.medatatw.com/academic-humanizer-tool
- 研究誠信與 AI 治理 No.01|AI 生成圖片可以投稿學術期刊嗎? https://www.medatatw.com/ai-generated-images-evidence
- 研究誠信與 AI 治理 No.03|AI 檢查了自己的工作,然後照樣把有問題的結論交出去 https://www.medatatw.com/ai-self-check-not-enough
- 研究誠信與 AI 治理 No.05|醫療用 LLM:九類倫理議題自查 https://www.medatatw.com/llm-healthcare-ethics-systematic-review
AI 使用聲明
本文由匯東華統計顧問有限公司 陳秀敏 博士撰稿,Claude Opus 5.5 協助文獻檢索、內容整理與版面排版,最終內容已由作者審閱定稿。Sun 等人論文之作者、標題、期刊、卷號與文章編號以 CrossRef 查證;文中引用之研究內容僅取自論文摘要與研究重點,未取得全文。日期:2026 年 10 月 16 日。
同期其他單元
- 本期工具|文獻檢索工具|Google 學術搜尋「實驗室」:用一句研究問題,快速找到真實又相關的文獻
- 統計方法實務|單變項顯著、放進多變項就不顯著:先分清楚,它是怎麼「消失」的
匯東華電子報 第 7 期|2026.10.16|看本期網頁版 →
聯絡我們
- LINE:@medatatw
- Email:info@medatatw.com
- 電話:07-9721586
- 官網:www.medatatw.com

統計分析
服務價目表 (未含5%營業稅)
透過嚴謹的數據整理,提供有價值的資訊,形塑知識,提高決策品質。包括信達雅三執行原則。
信:確保資料品質可信賴
達:確保統計方法適切性
雅:確保圖文表格正規化
協助代執行統計分析與進一步加值服務。
在匯東華與夥伴的專業背景知識配合下,能有效地處理面對的問題。
統計分析成果

數據串接與清洗
數據是礦藏,數據清洗是挖出鑽石的第一步,尤其是巨量知識。數據清洗或串接執行過程需要細心與專注,且有可能會消耗許多時間和精力,就由我們來替各位處理掉這個大麻煩。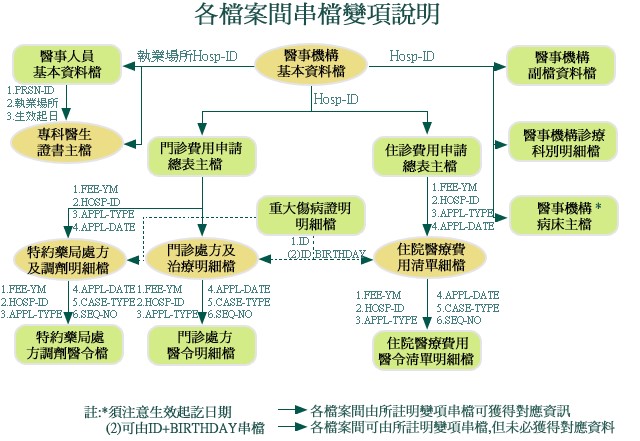
全民健保研究資料庫、國外大型資料庫資料非常齊全,種類多,需要串接與清洗,進行正規化後才能更進一步進行資料探勘與統計分析。
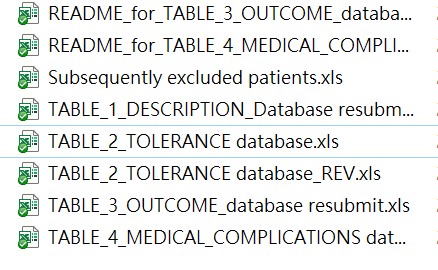
Fig1.同一個Project資料散落在不同tables,無法使用
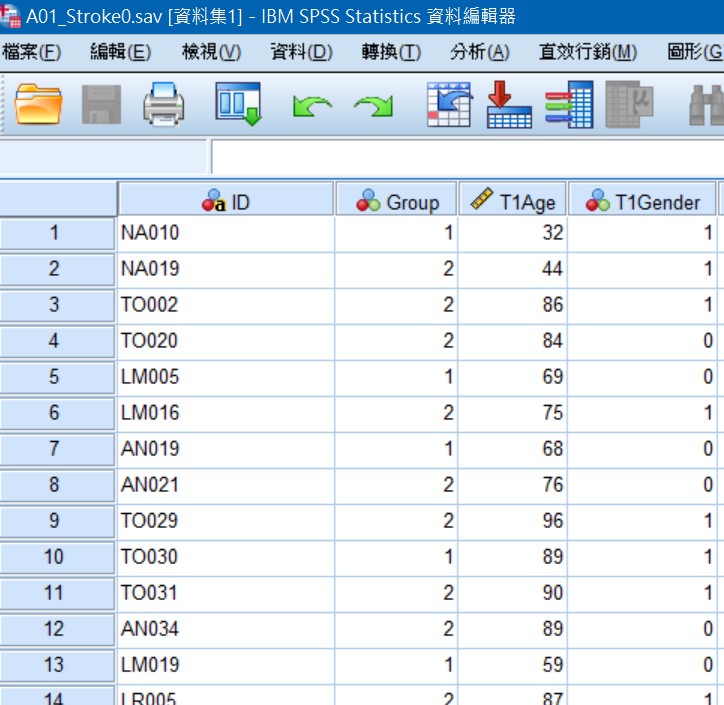
Fig2.整併與清理為可分析的table
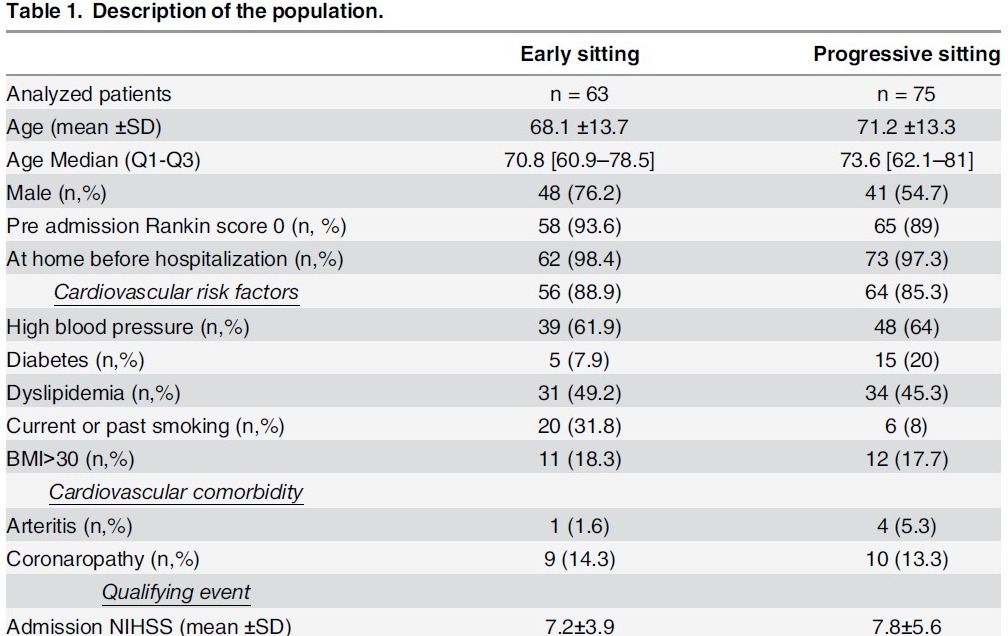
Fig.3整理和分析後形成有意義的知識
概念與流程示意圖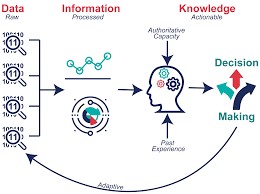

計畫撰寫與統計諮詢
為了讓匯東華的顧客與學員有更好的合作和消費體驗,故匯東華特別依據營業項目開發周邊產品,提供使用、購買。目前已有針對公共衛生師的題庫以及模擬試題,未來將針對醫學研究領域發展產品。