 匯東華統計顧問有限公司


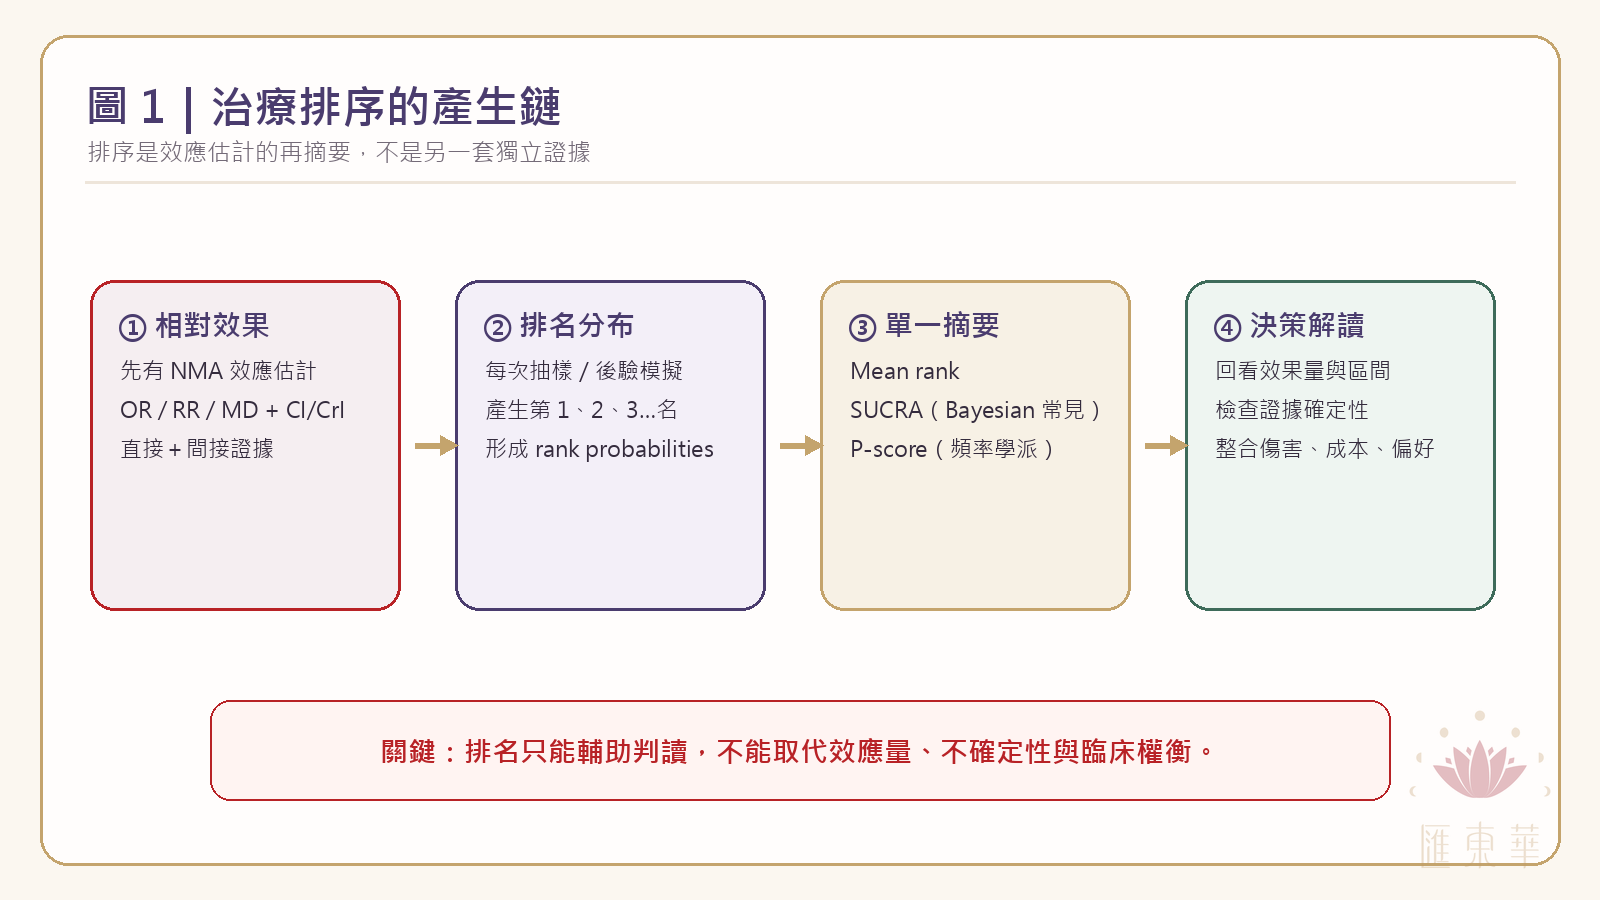
排序是效應估計的再摘要,不是另一套獨立證據——脫離效應量與確定性單獨解讀排名,就是誤用的開始。
Network Meta-analysis 進階:治療排序的正確打開方式
2026 年 10 月 2 日(五)18:30–20:30 夜間直播
NT$ 2,500(匯東華正式會員 2,125)
立即報名(表單請選 10/02(五)夜間直播場次)這堂課只聚焦 3 個常見誤區
SUCRA ≠ 最佳機率
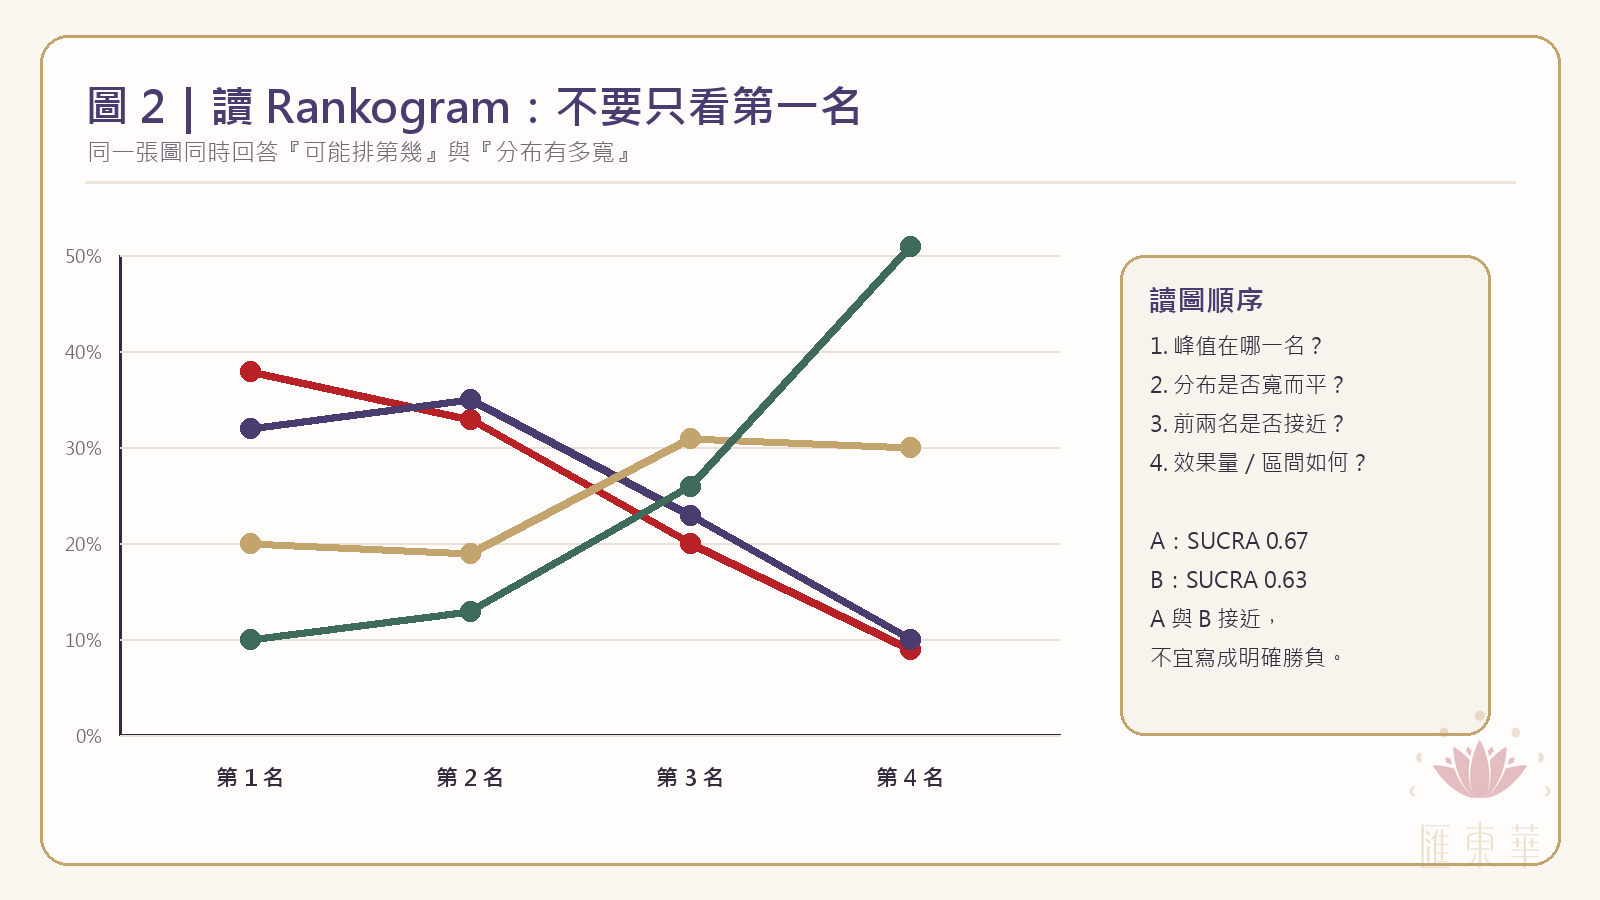
SUCRA 是累積排名的摘要,不是「成為第一名的機率」,也不是效果量。
第一名 ≠ 有臨床差異
名次一定會產生;即使治療間差異很小,演算法仍會排出先後。
排名 ≠ 決策
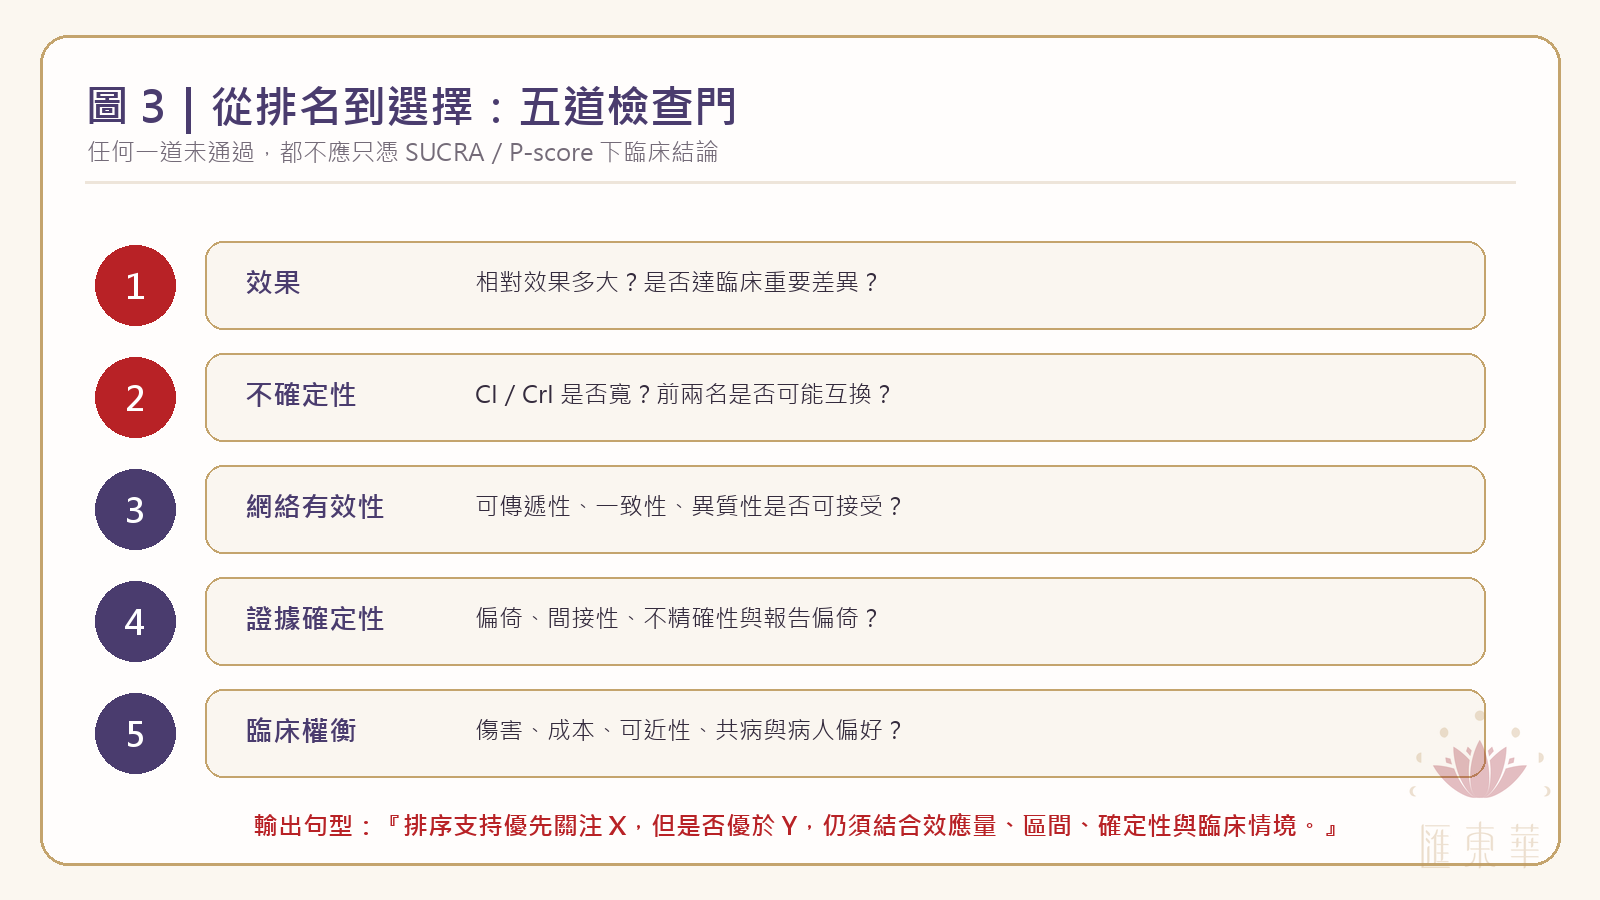
決策還要同時看效果量、區間、證據確定性、安全性、成本與可近性。
四個單元,從統計量一路走到文獻判讀
01|25 分鐘排名怎麼來?
- Rank probabilities 與 rankogram
- Mean rank、SUCRA、P-score 的意義
- SUCRA 公式與手算示例
02|25 分鐘排名能信多少?
- 效果量與信賴/可信區間
- 異質性、傳遞性與不一致性
- 證據確定性與排名不確定性
03|20 分鐘如何進入臨床決策?
- 效益與傷害雙向排序
- 臨床重要差異與適用性
- 成本、可近性與病人偏好
04|40 分鐘文獻解析
- 較妥善的整體解讀:Cipriani et al.
- SUCRA 過度延伸案例:Khan et al.
- 逐步拆解主張、證據與解讀界線
主課程 110 分鐘,另含 5 分鐘中場休息與 5 分鐘問答。
圖解教材預覽
同樣報告了效果與證據,排名語句的力道不同
Cipriani et al., Lancet 2018
成人重鬱症抗憂鬱劑 NMA。研究同時呈現比較效果、可接受度與排名,並檢視傳遞性、不一致性與證據品質。課堂重點不是背排名,而是觀察作者如何把排序留在完整證據鏈中。
Khan et al., Eur J Prev Cardiol 2018
該研究同樣報告了 SUCRA、OR、95% CrI 與 GRADE,資料呈現並不缺漏;爭點在摘要以 SUCRA 85%、84%、80% 將 PCSK9 抑制劑表述為最佳治療。同刊評論提醒:高 SUCRA 可能對應微小臨床差異、寬廣不確定性或品質限制。課堂將練習把「最高排名」改寫為不超出證據的句子。
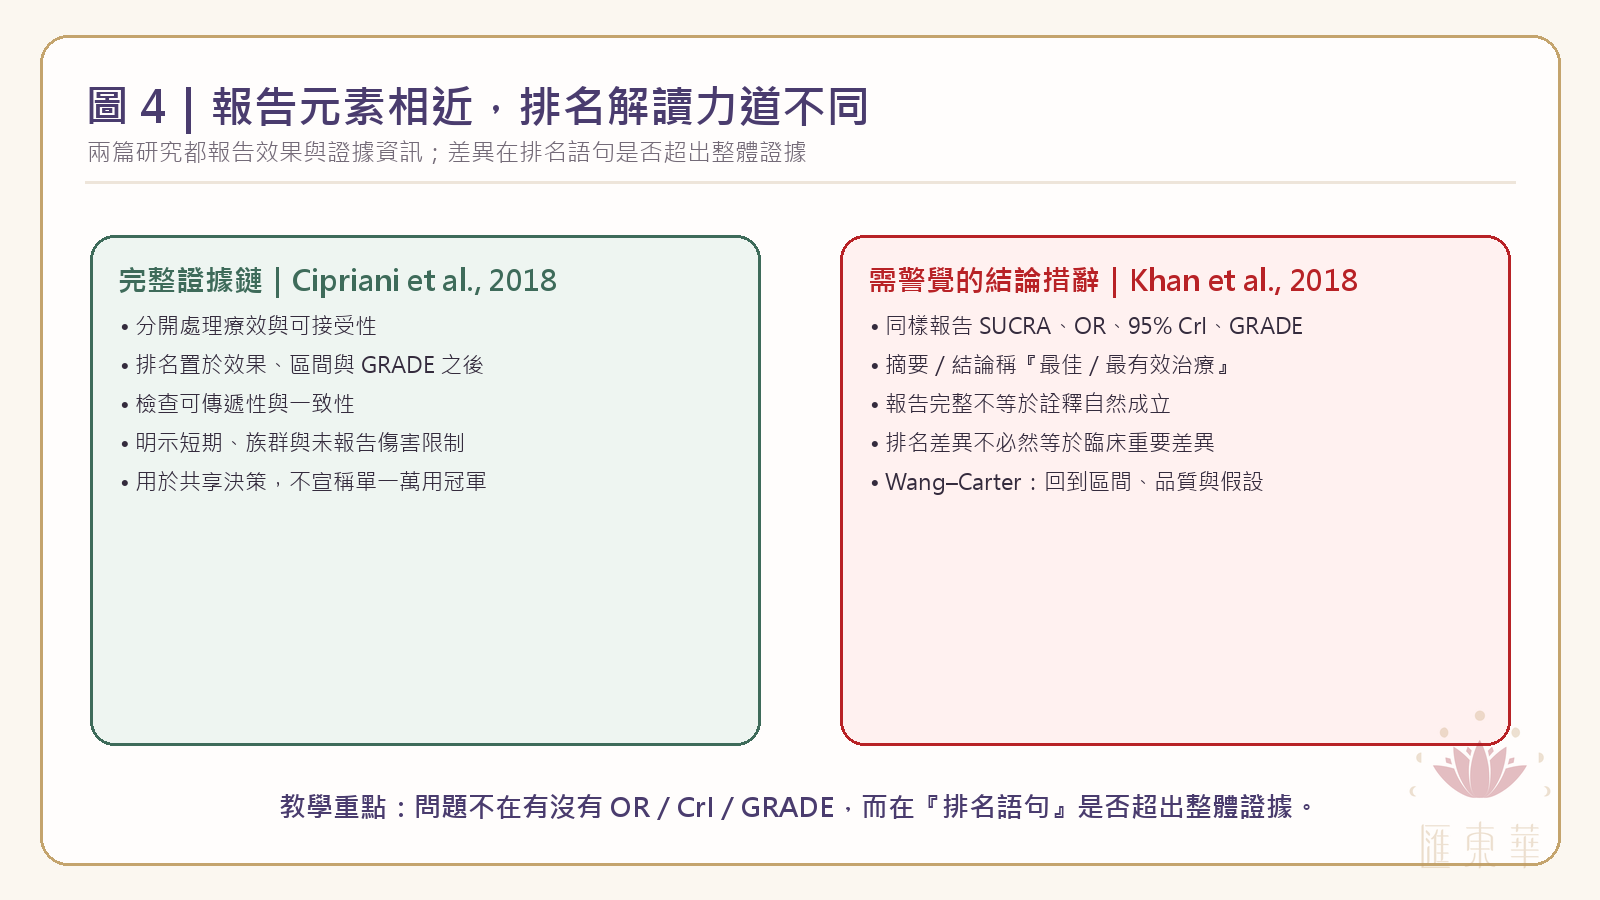
本課程的底線:先看效果量與區間,再看假設與確定性,最後才讓排名成為輔助摘要。
完成課程後,你能帶走什麼?
| 你將能夠 | 可直接使用的產出 |
|---|---|
| 區分「最佳機率」、mean rank、SUCRA 與 P-score | 一頁式指標對照表與手算例 |
| 辨認排序是否受到資料稀疏、區間與模型假設影響 | 五道檢查門 |
| 辨識文獻主張是否超過效果量、區間與證據確定性 | 真實文獻對照表與解析工作表 |
| 在效益、傷害、確定性與可近性之間做結構化權衡 | 臨床決策工作表 |
課程資訊
教材說明:課程引用之真實文獻案例僅供教學判讀練習,說明排序敘述與證據強度的對應關係,不代表對特定藥物或治療的臨床建議。
核心參考來源
- Bafeta A, Trinquart L, Seror R, Ravaud P. Reporting of results from network meta-analyses: methodological systematic review. BMJ. 2014;348:g1741. doi:10.1136/bmj.g1741
- Mbuagbaw L, Rochwerg B, Jaeschke R, et al. Approaches to interpreting and choosing the best treatments in network meta-analyses. Syst Rev. 2017;6(1):79. doi:10.1186/s13643-017-0473-z
- Cipriani A, Furukawa TA, Salanti G, et al. Comparative efficacy and acceptability of 21 antidepressant drugs for the acute treatment of adults with major depressive disorder: a systematic review and network meta-analysis. Lancet. 2018;391(10128):1357–1366. doi:10.1016/S0140-6736(17)32802-7
- Khan SU, Talluri S, Riaz H, et al. A Bayesian network meta-analysis of PCSK9 inhibitors, statins and ezetimibe with or without statins for cardiovascular outcomes. Eur J Prev Cardiol. 2018;25(8):844–853. doi:10.1177/2047487318766612
- Wang Z, Carter RE. Ranking of the most effective treatments for cardiovascular disease using SUCRA: Is it as sweet as it appears? Eur J Prev Cardiol. 2018;25(8):842–843. doi:10.1177/2047487318767199
Network Meta-analysis 進階:治療排序的正確打開方式
2026 年 10 月 2 日(五)18:30–20:30 夜間直播
NT$ 2,500(匯東華正式會員 2,125)
立即報名(表單請選 10/02(五)夜間直播場次)
統計分析
服務價目表 (未含5%營業稅)
透過嚴謹的數據整理,提供有價值的資訊,形塑知識,提高決策品質。包括信達雅三執行原則。
信:確保資料品質可信賴
達:確保統計方法適切性
雅:確保圖文表格正規化
協助代執行統計分析與進一步加值服務。
在匯東華與夥伴的專業背景知識配合下,能有效地處理面對的問題。
統計分析成果

數據串接與清洗
數據是礦藏,數據清洗是挖出鑽石的第一步,尤其是巨量知識。數據清洗或串接執行過程需要細心與專注,且有可能會消耗許多時間和精力,就由我們來替各位處理掉這個大麻煩。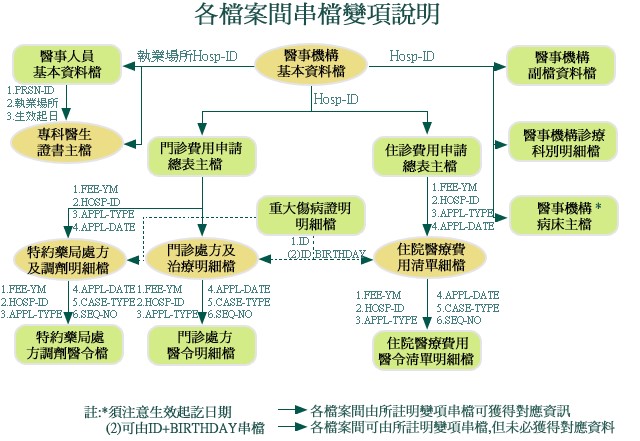
全民健保研究資料庫、國外大型資料庫資料非常齊全,種類多,需要串接與清洗,進行正規化後才能更進一步進行資料探勘與統計分析。
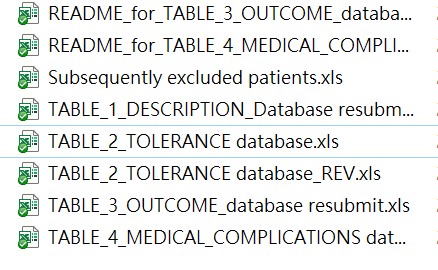
Fig1.同一個Project資料散落在不同tables,無法使用
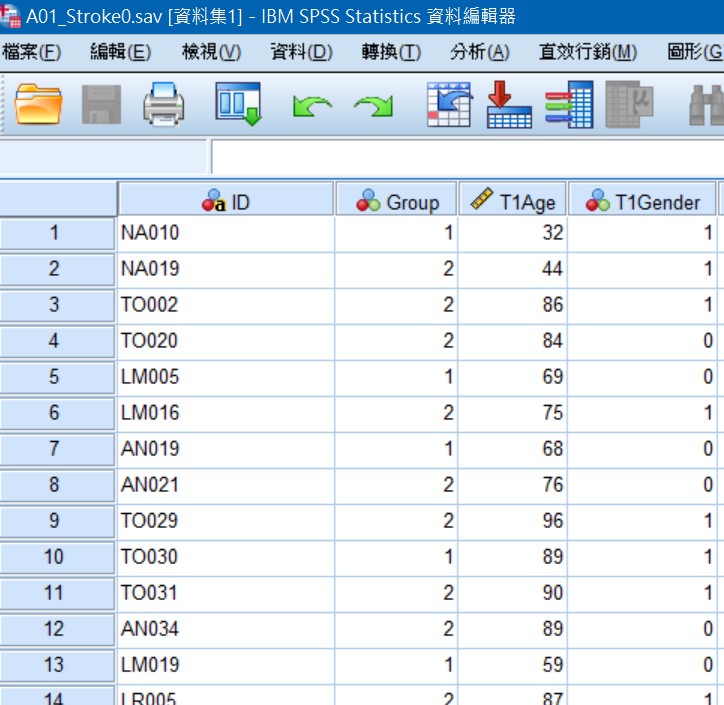
Fig2.整併與清理為可分析的table
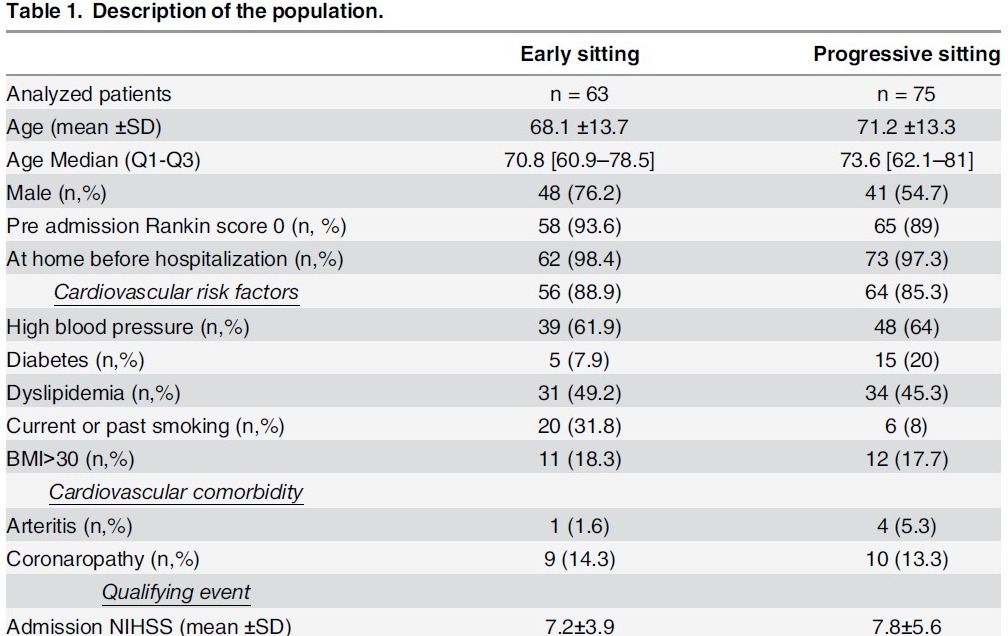
Fig.3整理和分析後形成有意義的知識
概念與流程示意圖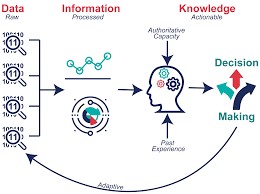

計畫撰寫與統計諮詢
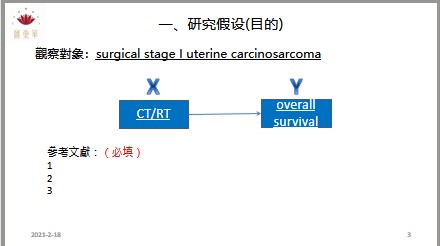
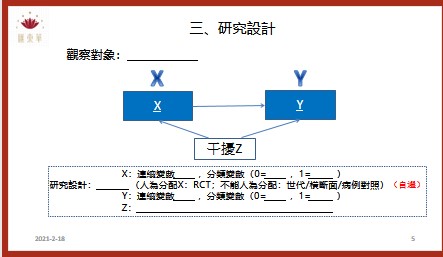
為了讓匯東華的顧客與學員有更好的合作和消費體驗,故匯東華特別依據營業項目開發周邊產品,提供使用、購買。目前已有針對公共衛生師的題庫以及模擬試題,未來將針對醫學研究領域發展產品。